GPT —— 因果语言建模
BERT 看两边。GPT 只看过去。那个三角掩码是现代 AI 里影响最大的一行代码。
类型: Build 语言: Python 前置要求: 阶段 7 · 02(Self-Attention)、阶段 7 · 05(完整的 Transformer)、阶段 7 · 06(BERT) 预计时间: ~75 分钟
问题背景
语言模型回答一个问题:给定前 t-1 个 token,token t 的概率分布是什么?在这个信号——下一个 token 预测——上训练,你就得到一个能一次一个 token 生成任意文本的模型。
要在整个序列上并行地端到端训练它,你需要每个位置的预测只依赖更早的位置。否则模型会通过看答案轻松作弊。
因果掩码做的就是这件事。它是一个由 -inf 值构成的上三角矩阵,在 softmax 之前加到注意力分数上。softmax 之后,那些位置变成 0。每个位置只能关注自己和更早的位置。而因为你对整个序列只施加一次,你在一次前向通过里就得到 N 个并行的下一个 token 预测。
GPT-1(2018)、GPT-2(2019)、GPT-3(2020)、GPT-4(2023)、GPT-5(2025)、Claude、Llama、Qwen、Mistral、DeepSeek、Kimi——它们全都是纯解码器因果 transformer,核心循环相同。真正拉开差距的是数据质量、规模与架构改进,以及后训练(SFT、RLHF、DPO 和它们的后继方法)。
核心概念
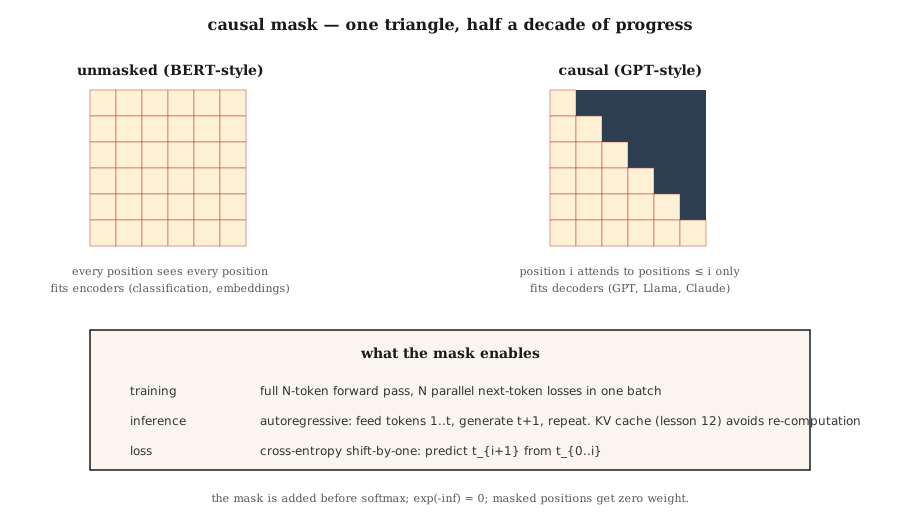
掩码
给定一个长度 N 的序列,构建一个 N × N 矩阵:
M[i, j] = 0       if j <= i
M[i, j] = -inf    if j > i
在 softmax 之前把 M 加到原始注意力分数上。exp(-inf) = 0,所以被掩位置贡献零权重。注意力矩阵的每一行都是一个只在更早位置上的概率分布。
实现成本:一次 torch.tril() 调用。计算耗时:纳秒级。对整个领域的影响:一切。
三角形从何而来
因果掩码通常被描述成后来加到注意力上的补丁。反过来推导,它就不再神秘:注意力可以看作前缀平均的第三次改进,而三角形只是把这个平均操作的循环边界写成了矩阵。
阶段 1:前缀平均。 对序列最简单的因果摘要,是让位置 i 变成位置 0…i 的均值。写成循环就是 out[i] = X[:i+1].mean(0)。同一运算也可以用一次矩阵乘法完成:取一个全 1 的下三角矩阵,让每一行除以该行的元素数,再相乘:
import numpy as np

A = np.tril(np.ones((n, n)))
A = A / A.sum(axis=1, keepdims=True)
out = A @ X
A 的第 i 行是 [1/(i+1), …, 1/(i+1), 0, …, 0]。对角线上方的零就是因果性。并不是未来位置被掩掉了,而是它们从未进入求和范围。
阶段 2:学习权重。 均匀平均把过去每个 token 都看成同样重要。把全 1 矩阵换成学习得到的分数矩阵 S。此时各行不再天然和为 1,因此改用 softmax 归一化,而不是除以元素数。softmax 不会输出精确的零,这会破坏因果性;除非把未来位置的分数设为 -inf,因为 exp(-inf) = 0:
def softmax(x, axis):
    e = np.exp(x - np.max(x, axis=axis, keepdims=True))
    return e / e.sum(axis=axis, keepdims=True)

S = S + np.triu(np.full((n, n), -np.inf), k=1)
A = softmax(S, axis=1)
out = A @ X还是同一个三角形、同一个行随机矩阵、同一次矩阵乘法。-inf 掩码不是新机制,它只是把阶段 1 里的零元素翻译到了 softmax 的输入域。
阶段 3:依赖内容的权重。 在阶段 2 中,S 训练后就是固定的:无论 token 内容是什么,位置 7 对位置 3 的权重都一样。接着让分数由 token 本身决定:S = Q @ K.T / sqrt(d_k)。其他部分完全不变,仍是掩码、softmax 和矩阵乘法。
三个阶段只有一个不变量:用下三角行随机矩阵乘以序列。均匀平均、学习得到的静态权重、依赖内容的权重,只是在逐步改进同一个计算。掩码并不是后来加进注意力的,它从最初的平均操作中一直保留了下来。
mask-derivation并行训练,串行推理
训练:把整个 (N, d_model) 序列前向一次,算 N 个交叉熵损失(每个位置一个),求和,反向传播。沿序列并行。这就是 GPT 训练能扩展的原因——你在一次 GPU 通过里处理一个批次里的 100 万 token。
推理:你一个 token 一个 token 地生成。喂 [t1, t2, t3],得 t4。喂 [t1, t2, t3, t4],得 t5。喂 [t1, t2, t3, t4, t5],得 t6。KV 缓存(第 12 课)保存 t1…tn 的隐藏状态,省得你每步重算。但推理时的串行深度 = 输出长度。这就是自回归税,也是为什么解码是每个 LLM 的延迟瓶颈。
损失——错位一格
给定 token [t1, t2, t3, t4]:
- 输入:
[t1, t2, t3] - 目标:
[t2, t3, t4]
对每个位置 i,算 -log P(target_i | inputs[:i+1])。求和。这就是整个序列的交叉熵。
你听过的每个 transformer LM 都在这个损失上训练。预训练、微调、SFT——同一个损失,不同的数据。
解码策略
训练之后,采样选择比大家以为的更重要。
| 方法 | 干什么 | 何时用 |
|---|---|---|
| 贪心 | 每步取 argmax | 确定性任务、代码补全 |
| 温度 | logits 除以 T 再采样 | 创意任务,T 越高越多样 |
| Top-k | 只从 top-k 个 token 采样 | 砍掉低概率长尾 |
| Top-p(核采样) | 从累积概率 ≥ p 的最小集合里采样 | 2020+ 默认;自适应分布形状 |
| Min-p | 保留 p > min_p * max_p 的 token | 2024+;比 top-p 更擅长拒绝长尾 |
| 投机解码 | 草稿模型提议 N 个 token,大模型验证 | 同质量下延迟降 2–3 倍 |
2026 年,min-p + 温度 0.7 对开放权重模型是个合理的默认。投机解码是任何生产推理栈的入场券。
"GPT 配方"为什么有效
- 纯解码器。 没有编码器开销。每层一次注意力 + FFN。
- 扩展。 124M → 1.5B → 175B → 数万亿。Chinchilla scaling laws(第 13 课)告诉你怎么花算力。
- In-context learning。 在 6B–13B 左右涌现。模型能跟随少样本示例而不必微调。
- RLHF。 在人类偏好上做后训练,把原始预训练文本变成聊天助手。
- Pre-norm + RoPE + SwiGLU。 大规模下稳定训练。
核心架构自 GPT-2 以来没怎么变。所有有意思的事都发生在数据、规模和后训练上。
causal-mask动手构建
第 1 步:因果掩码
见 code/main.py。一行代码:
def causal_mask(n):
    return [[0.0 if j <= i else float("-inf") for j in range(n)] for i in range(n)]
在 softmax 之前把它加到注意力分数上。整个机制就这些。
第 2 步:一个 2 层的类 GPT 模型
堆两个解码器 block(masked self-attention + FFN,无 cross-attention)。加一个 token 嵌入、一个位置编码、一个反嵌入(与 token 嵌入矩阵绑定——GPT-2 以来的标准技巧)。
第 3 步:端到端的下一个 token 预测
在一个 20 token 的玩具词表上,在每个位置产出 logits。对错位一格的目标算交叉熵损失。不算梯度——这是一次前向通过的健全性检查。
第 4 步:采样
实现贪心、温度、top-k、top-p、min-p。在一个固定 prompt 上各跑一遍,对比输出。一个采样函数 10 行。
实际使用
PyTorch,2026 年的写法:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.2-3B-Instruct")
tok = AutoTokenizer.from_pretrained("meta-llama/Llama-3.2-3B-Instruct")

prompt = "Attention is all you need because"
inputs = tok(prompt, return_tensors="pt")
out = model.generate(
    **inputs,
    max_new_tokens=64,
    temperature=0.7,
    top_p=0.9,
    do_sample=True,
)
print(tok.decode(out[0]))底层里,generate() 跑前向通过、取最后位置的 logits、采样下一个 token、追加上去、重复。每个生产 LLM 推理栈(vLLM、TensorRT-LLM、llama.cpp、Ollama、MLX)都用大量优化实现同一个循环——批量 prefill、连续批处理、KV 缓存分页、投机解码。
GPT vs BERT,各一行: GPT 预测 P(x_t | x_\{<t\})。BERT 预测 P(x_masked | x_unmasked)。损失决定模型能不能生成。
拿去用
见 outputs/skill-sampling-tuner.md。这个 skill 为一个新的生成任务挑选采样参数,并在需要确定性解码时标出来。
练习
- 简单。 跑
code/main.py,验证 softmax 之后因果注意力矩阵是下三角的。抽查:第 3 行应该只在第 0–3 列有权重。 - 中等。 实现宽度 4 的 beam search。在 10 个短 prompt 上对比 beam-4 和贪心的困惑度。beam 总是赢吗?(提示:通常翻译会赢,开放式聊天不会。)
- 困难。 实现投机解码:用一个极小的 2 层模型作草稿、一个 6 层模型作验证器。在 100 个长度 64 的补全上测墙钟加速比。确认输出和验证器的贪心结果一致。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 因果掩码 | "那个三角" | 加到注意力分数上的上三角 -inf 矩阵,让位置 i 只看到位置 ≤ i。 |
| 下一个 token 预测 | "那个损失" | 模型分布对每个位置真实下一个 token 的交叉熵。 |
| 自回归 | "一次生成一个" | 把输出喂回作输入;只有训练期并行,生成期不并行。 |
| Logits | "softmax 前的分数" | LM 头在 softmax 之前的原始输出;采样在这上面发生。 |
| 温度 | "创意旋钮" | logits 除以 T;T→0 = 贪心,T→∞ = 均匀。 |
| Top-p | "核采样" | 把分布截断到和 ≥p 的最小集合;从剩下的里采样。 |
| Min-p | "比 top-p 好" | 保留 p ≥ min_p × max_p 的 token;按分布的尖锐度自适应截断。 |
| 投机解码 | "草稿 + 验证" | 廉价模型提议 N 个 token;大模型并行验证。 |
| Teacher forcing | "训练技巧" | 训练期间喂真实的前一个 token,不是模型自己的预测。每个 seq2seq LM 的标准做法。 |
延伸阅读
- Radford et al. (2018). Improving Language Understanding by Generative Pre-Training —— GPT-1。
- Radford et al. (2019). Language Models are Unsupervised Multitask Learners —— GPT-2。
- Brown et al. (2020). Language Models are Few-Shot Learners —— GPT-3 和 in-context learning。
- Leviathan, Kalman, Matias (2023). Fast Inference from Transformers via Speculative Decoding —— 投机解码论文。
- HuggingFace
modeling_llama.py—— 规范的因果 LM 参考代码。