文本转语音(TTS)—— 从 Tacotron 到 F5 和 Kokoro
ASR 把语音反演成文本;TTS 把文本反演成语音。2026 年的工具栈分三段:文本 → token,token → 梅尔,梅尔 → 波形。每一段都有一个塞得进笔记本的默认模型。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(频谱图与梅尔)、阶段 5 · 09(Seq2Seq)、阶段 7 · 05(完整 Transformer) 预计时间: ~75 分钟
问题背景
你有一个字符串:"Please remind me to water the plants at 6 pm."。你需要一段听起来自然的 3 秒音频,韵律正确(停顿、重音),把 "plants" 念对元音,并且在 CPU 上 300 ms 内跑完,供一个实时语音助手用。你还得能换声音、处理混语输入("remind me at 6 pm, daijoubu?"),并且别在人名上出洋相。
现代 TTS 流水线长这样:
- 文本前端。 规整文本(日期、数字、邮箱),转成音素或子词 token,预测韵律特征。
- 声学模型。 文本 → 梅尔频谱图。Tacotron 2(2017)、FastSpeech 2(2020)、VITS(2021)、F5-TTS(2024)、Kokoro(2024)。
- 声码器。 梅尔 → 波形。WaveNet(2016)、WaveRNN、HiFi-GAN(2020)、BigVGAN(2022)、2024 年后的神经编解码声码器。
2026 年,随着端到端的扩散和 flow-matching 模型出现,声学 + 声码器的分界变得模糊。但这套三段式的心智模型在调试时仍然成立。
核心概念
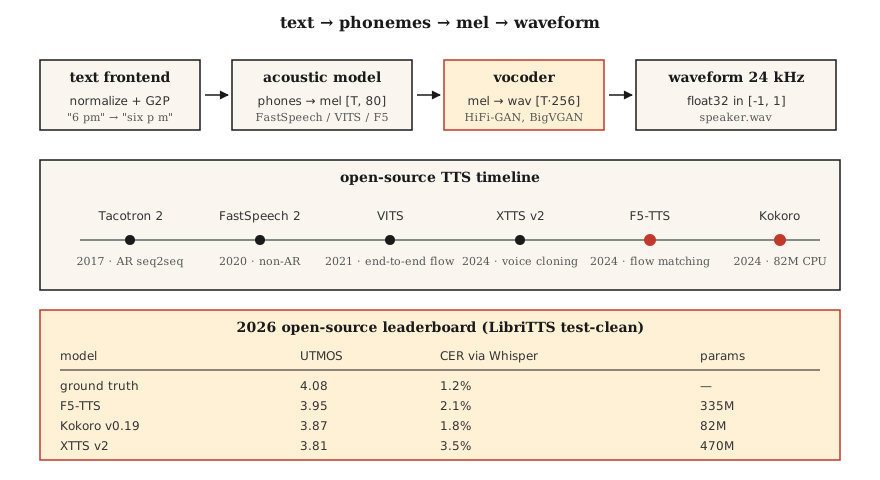
Tacotron 2(2017)。 Seq2seq:字符嵌入 → BiLSTM 编码器 → 位置敏感注意力 → 自回归 LSTM 解码器输出梅尔帧。慢(自回归),长文本上发飘。仍被引为基线。
FastSpeech 2(2020)。 非自回归。时长预测器输出每个音素分到几个梅尔帧。单趟,比 Tacotron 快 10 倍。损失一些自然度(单调对齐),但到处都在用。
VITS(2021)。 用变分推断端到端地联合训练编码器 + 基于 flow 的时长 + HiFi-GAN 声码器。质量高,单模型。2022–2024 年主导的开源 TTS。变体:YourTTS(多说话人零样本)、XTTS v2(2024,Coqui)。
F5-TTS(2024)。 在 flow matching 之上的扩散 transformer。韵律自然,5 秒参考音频就能零样本克隆声音。2026 年开源 TTS 排行榜榜首。335M 参数。
Kokoro(2024)。 小(82M),可跑在 CPU 上,实时场景下同级最佳的英语 TTS。闭词表、仅英语,apache-2.0。
OpenAI TTS-1-HD、ElevenLabs v2.5、Google Chirp-3。 商用的当时最优。ElevenLabs v2.5 的情绪标签("[whispered]"、"[laughing]")和角色声音在 2026 年主导有声书制作。
声码器演进
| 时期 | 声码器 | 延迟 | 质量 |
|---|---|---|---|
| 2016 | WaveNet | 仅离线 | 发布时 SOTA |
| 2018 | WaveRNN | ~实时 | 不错 |
| 2020 | HiFi-GAN | 100× 实时 | 接近人类 |
| 2022 | BigVGAN | 50× 实时 | 跨说话人/语种泛化 |
| 2024 | SNAC、DAC(神经编解码) | 与 AR 模型集成 | 离散 token,比特高效 |
到 2026 年,大多数「TTS」模型都是从文本到波形端到端的;梅尔频谱图只是一个内部表示。
评估
- MOS(平均意见得分)。 1–5 分,众包打分。仍是黄金标准;慢得要命。
- CMOS(比较 MOS)。 A-vs-B 偏好。每次标注的置信区间更紧。
- UTMOS、DNSMOS。 无参考的神经 MOS 预测器。用于排行榜。
- 通过 ASR 算 CER(字符错误率)。 把 TTS 输出过一遍 Whisper,对输入文本算 CER。可懂度的代理指标。
- SECS(说话人嵌入余弦相似度)。 语音克隆质量。
LibriTTS test-clean 上的 2026 年数字:
| 模型 | UTMOS | CER(通过 Whisper) | 规模 |
|---|---|---|---|
| 真值 | 4.08 | 1.2% | — |
| F5-TTS | 3.95 | 2.1% | 335M |
| XTTS v2 | 3.81 | 3.5% | 470M |
| VITS | 3.62 | 3.1% | 25M |
| Kokoro v0.19 | 3.87 | 1.8% | 82M |
| Parler-TTS Large | 3.76 | 2.8% | 2.3B |
sp-tts-stack动手构建
第 1 步:把输入转成音素
from phonemizer import phonemize
ph = phonemize("Hello world", language="en-us", backend="espeak")
# 'həloʊ wɜːld'
音素是通用的桥梁。质量在 VITS 级别以下的任何东西,别直接喂原始文本。
第 2 步:跑 Kokoro(2026 年的 CPU 默认)
from kokoro import KPipeline
tts = KPipeline(lang_code="a")  # "a" = 美式英语
audio, sr = tts("Please remind me to water the plants at 6 pm.", voice="af_bella")
# audio: float32 tensor, sr=24000
离线运行,单文件,82M 参数。
第 3 步:用 F5-TTS 做语音克隆
from f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
    ref_file="my_voice_5s.wav",
    ref_text="The quick brown fox jumps over the lazy dog.",
    gen_text="Please remind me to water the plants.",
)
传一段 5 秒的参考音频 + 它的转写文本;F5 会克隆韵律和音色。
第 4 步:从零写 HiFi-GAN 声码器
塞进一个教程脚本里太大了,但它的形状是:
class HiFiGAN(nn.Module):
    def __init__(self, mel_channels=80, upsample_rates=[8, 8, 2, 2]):
        super().__init__()
        # 4 个上采样块,总共 256 倍,从梅尔率升到音频率
        ...
    def forward(self, mel):
        return self.blocks(mel)  # -> waveform
训练:对抗式(在短窗上的判别器)+ 梅尔频谱重建损失 + 特征匹配损失。已经日用品化了——用 hifi-gan 仓库或 nvidia-NeMo 的预训练 checkpoint。
第 5 步:完整流水线(伪代码)
text = "Please remind me at 6 pm."
phones = phonemize(text)
mel = acoustic_model(phones, speaker=alice)      # [T, 80]
wav = vocoder(mel)                                # [T * 256]
soundfile.write("out.wav", wav, 24000)
实际使用
2026 年的工具栈:
| 情形 | 选 |
|---|---|
| 实时英语语音助手 | Kokoro(CPU)或 XTTS v2(GPU) |
| 从 5 秒参考做语音克隆 | F5-TTS |
| 商用角色声音 | ElevenLabs v2.5 |
| 有声书旁白 | ElevenLabs v2.5 或 XTTS v2 + 微调 |
| 低资源语言 | 在 5–20 小时目标语数据上训 VITS |
| 表现力 / 情绪标签 | ElevenLabs v2.5 或 StyleTTS 2 微调 |
截至 2026 年的开源领跑者:质量看 F5-TTS,效率看 Kokoro。别去碰 Tacotron,除非你是历史学家。
坑
- 没有文本规整器。 "Dr. Smith" 念成 "Doctor" 还是 "Drive"?"2026" 念 "twenty twenty six" 还是 "two zero two six"?在音素化之前先规整。
- 词表外的专有名词。 "Ghumare" → "ghyu-mair"?为未知 token 准备一个兜底的字素到音素模型。
- 削波。 声码器输出很少削波,但推理时梅尔缩放不匹配会冲过 ±1.0。永远
np.clip(wav, -1, 1)。 - 采样率不匹配。 Kokoro 输出 24 kHz;你下游流水线期望 16 kHz → 重采样,否则混叠。
拿去用
存为 outputs/skill-tts-designer.md。为给定的声音、延迟和语种目标设计一条 TTS 流水线。
练习
- 简单。 跑
code/main.py。它从一个玩具词表构建音素字典,估计每个音素的时长,并打印一个假的「梅尔」排程。 - 中等。 装上 Kokoro,用
af_bella和am_adam两个声音合成同一句话。比较音频时长和主观质量。 - 困难。 录一段你自己的 5 秒参考音频。用 F5-TTS 克隆它。报告参考和克隆输出之间的 SECS。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 音素(Phoneme) | 声音单元 | 抽象的声音类别;英语里有 39 个(ARPABet)。 |
| 时长预测器 | 每个音素持续多久 | 非自回归模型的输出;每个音素的整数帧数。 |
| 声码器(Vocoder) | 梅尔 → 波形 | 把梅尔谱映射到原始采样点的神经网络。 |
| HiFi-GAN | 标准声码器 | 基于 GAN;2020–2024 年主导。 |
| MOS | 主观质量 | 人类评分者给的 1–5 分平均意见得分。 |
| SECS | 语音克隆指标 | 目标与输出说话人嵌入之间的余弦相似度。 |
| F5-TTS | 2024 年开源 SOTA | Flow-matching 扩散;零样本克隆。 |
| Kokoro | CPU 英语领跑者 | 82M 参数的模型,Apache 2.0。 |
延伸阅读
- Shen et al. (2017). Tacotron 2 —— seq2seq 基线。
- Kim, Kong, Son (2021). VITS —— 端到端、基于 flow。
- Chen et al. (2024). F5-TTS —— 当前的开源 SOTA。
- Kong, Kim, Bae (2020). HiFi-GAN —— 到 2026 年仍在上线的声码器。
- Kokoro-82M on HuggingFace —— 2024 年 CPU 友好的英语 TTS。