自编码器与变分自编码器(VAE)
普通自编码器先压缩再重建。它在背答案,它不会生成。加一个小技巧——逼着这个码看起来像高斯分布——你就得到了一个采样器。就这一个技巧,
z = μ + σ·ε的重参数化,正是你 2026 年用的每一个潜空间扩散和流匹配图像模型在输入端都挂着一个 VAE 的原因。
类型: Build 语言: Python 前置要求: 阶段 3 · 02(反向传播)、阶段 3 · 07(CNN)、阶段 8 · 01(分类) 预计时间: ~75 分钟
问题背景
把一个 784 像素的 MNIST 数字压成一个 16 个数的码,然后重建出来。普通自编码器的重建 MSE 会拿满分,但码空间是一团坑坑洼洼的乱麻。在码空间里随便挑一个点解码,你得到的是噪声。它没有采样器。它就是一个乔装打扮过的压缩模型。
你真正想要的是:(a) 码空间是一个干净、平滑、你能从中采样的分布——比如各向同性高斯 N(0, I),(b) 解码任意一个样本都能得到一个像样的数字,(c) 编码器和解码器仍然压得很好。三个目标,一个架构,一个损失。
Kingma 2013 年的 VAE 这样解决:训练编码器输出一个分布 q(z|x) = N(μ(x), σ(x)²),通过一个 KL 惩罚把这个分布往先验 N(0, I) 上拉,然后在解码前从 q(z|x) 里采样 z。推理时,把编码器丢掉,采样 z ~ N(0, I),解码。正是这个 KL 惩罚逼着码空间变得有结构。
到 2026 年,VAE 很少单独上线了——在原始图像质量上它已被扩散完爆——但它是每一个潜空间扩散模型(SD 1/2/XL/3、Flux、AudioCraft)首选的编码器。学会 VAE,你就学会了你所用每一条图像流水线那看不见的第一层。
核心概念
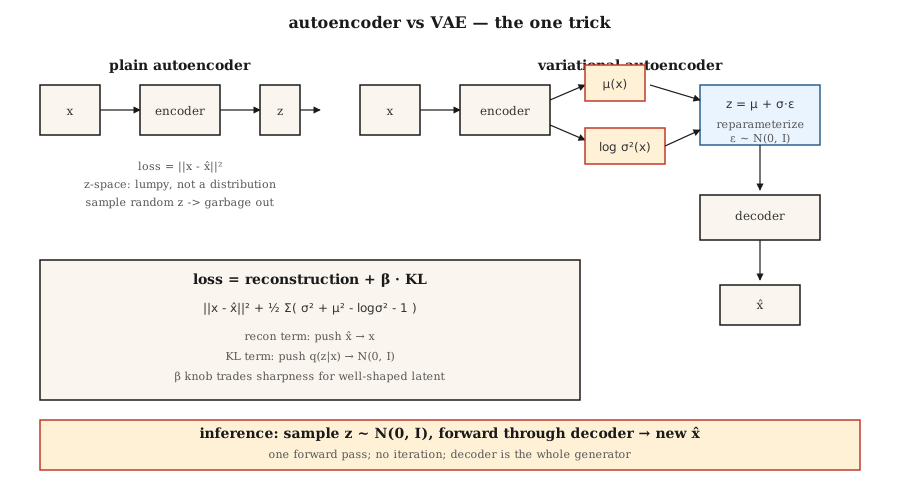
自编码器。 z = encoder(x),x̂ = decoder(z),损失 = ||x - x̂||²。码空间无结构。
VAE 编码器。 输出两个向量:μ(x) 和 log σ²(x)。它们定义了 q(z|x) = N(μ, diag(σ²))。
重参数化技巧。 从 q(z|x) 采样这件事不可微。把这个样本改写成 z = μ + σ·ε,其中 ε ~ N(0, I)。现在 z 是 (μ, σ) 的一个确定性函数加上一个非参数噪声——梯度可以流过 μ 和 σ。
损失。 证据下界(ELBO),两项:
loss = reconstruction + β · KL[q(z|x) || N(0, I)]
     = ||x - x̂||²  + β · Σ_i ( σ_i² + μ_i² - log σ_i² - 1 ) / 2
重建项把 x̂ 推向 x。KL 把 q(z|x) 推向先验。它们互相权衡。β 小(<1)= 样本更锐,码空间没那么高斯。β 大(>1)= 码空间更干净,样本更糊。β-VAE(Higgins 2017)让这个旋钮出了名,并掀起了解耦表示的研究。
采样。 推理时:抽 z ~ N(0, I),前向过解码器。一次前向——不像扩散那样要迭代采样。
vae-latent-grid动手构建
code/main.py 不用 numpy 也不用 torch,实现了一个迷你 VAE。输入是 8 维合成数据,从一个 8 维空间里的双成分高斯混合采样而来。编码器和解码器都是单隐层 MLP。我们实现了 tanh 激活、前向、损失,以及一个手写的反向。不是生产代码——是教学。
第 1 步:编码器前向
def encode(x, enc):
    h = tanh(add(matmul(enc["W1"], x), enc["b1"]))
    mu = add(matmul(enc["W_mu"], h), enc["b_mu"])
    log_sigma2 = add(matmul(enc["W_sig"], h), enc["b_sig"])
    return mu, log_sigma2
输出 log σ² 而不是 σ,这样网络输出无约束(对 σ 做 softplus 是个坑——梯度在 σ ≈ 0 时会死掉)。
第 2 步:重参数化并解码
def reparameterize(mu, log_sigma2, rng):
    eps = [rng.gauss(0, 1) for _ in mu]
    sigma = [math.exp(0.5 * lv) for lv in log_sigma2]
    return [m + s * e for m, s, e in zip(mu, sigma, eps)]

def decode(z, dec):
    h = tanh(add(matmul(dec["W1"], z), dec["b1"]))
    return add(matmul(dec["W_out"], h), dec["b_out"])
第 3 步:ELBO
def elbo(x, x_hat, mu, log_sigma2, beta=1.0):
    recon = sum((a - b) ** 2 for a, b in zip(x, x_hat))
    kl = 0.5 * sum(math.exp(lv) + m * m - lv - 1 for m, lv in zip(mu, log_sigma2))
    return recon + beta * kl, recon, kl
因为两个分布都是高斯,KL 有精确的闭式解。别去数值积分。直到 2026 年还有人上线带蒙特卡洛 KL 估计的代码——慢 3 倍,没有任何理由。
第 4 步:生成
def sample(dec, z_dim, rng):
    z = [rng.gauss(0, 1) for _ in range(z_dim)]
    return decode(z, dec)
这就是那个生成模型。五行。
坑
- 后验坍缩。 KL 项把
q(z|x) → N(0, I)推得太狠,以至于z不携带任何关于x的信息。解法:β 退火(从 β=0 起步,爬升到 1)、free bits,或者在不活跃的维度上跳过 KL。 - 样本模糊。 高斯解码器似然意味着 MSE 重建,而 MSE 对 L2 是贝叶斯最优的(取均值)——一堆像样数字的均值是一个糊掉的数字。解法:离散解码器(VQ-VAE、NVAE),或者只把 VAE 当编码器用、在潜变量上叠扩散(Stable Diffusion 就是这么干的)。
- β 太大、太早。 见后验坍缩。从 β≈0.01 起步再爬升。
- 潜变量维度太小。 16 维对 MNIST 够用,256 维对 ImageNet 256²,2048 维对 ImageNet 1024²。Stable Diffusion 的 VAE 把 512×512×3 → 64×64×4(空间面积下采样 32 倍,通道 32 倍)。
实际使用
2026 年的 VAE 技术栈:
| 场景 | 选择 |
|---|---|
| 给扩散用的图像潜空间编码器 | Stable Diffusion VAE(sd-vae-ft-ema)或 Flux VAE |
| 音频潜空间编码器 | Encodec(Meta)、SoundStream,或 DAC(Descript) |
| 视频潜变量 | Sora 的时空 patch、Latte VAE、WAN VAE |
| 解耦表示学习 | β-VAE、FactorVAE、TCVAE |
| 离散潜变量(给 transformer 建模用) | VQ-VAE、RVQ(ResidualVQ) |
| 给生成用的连续潜变量 | 普通 VAE,然后在那个潜空间里条件化一个流/扩散模型 |
潜空间扩散模型就是一个 VAE,编码器和解码器之间住着一个扩散模型。VAE 做粗压缩,扩散模型挑重担。视频(VAE + 视频扩散 DiT)和音频(Encodec + MusicGen transformer)都是同一套路。
拿去用
存为 outputs/skill-vae-trainer.md。
技能接受:数据集画像 + 目标潜变量维度 + 下游用途(重建、采样,或潜空间扩散的输入),输出:架构选择(普通/β/VQ/RVQ)、β 调度、潜变量维度、解码器似然(高斯还是类别),以及评测计划(重建 MSE、每维 KL、q(z|x) 与 N(0, I) 之间的 Fréchet 距离)。
练习
- 简单。 把
code/main.py里的β改成0.01、0.1、1.0、5.0。记录最终的重建 MSE 和 KL。对你的合成数据来说哪个 β 是帕累托最优? - 中等。 把高斯解码器似然换成伯努利似然(交叉熵损失)。在同一份合成数据的二值化版本上比较样本质量。
- 困难。 把
code/main.py扩成一个迷你 VQ-VAE:把连续的z换成在一个 K=32 项的码本里做最近邻查找。比较重建 MSE,并报告有多少个码本项被用上了(码本坍缩是真实存在的)。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 自编码器 | 编码-解码网络 | x → z → x̂,学 MSE。不生成。 |
| VAE | 带采样器的 AE | 编码器输出一个分布,KL 惩罚塑造码空间。 |
| ELBO | 证据下界 | `log p(x) ≥ recon - KL[q(z |
| 重参数化 | z = μ + σ·ε | 把随机节点改写成确定性 + 纯噪声。让梯度能穿过采样。 |
| 先验 | p(z) | 潜变量的目标分布,通常是 N(0, I)。 |
| 后验坍缩 | 「KL 项赢了」 | 编码器无视 x,直接输出先验;解码器只能瞎编。 |
| β-VAE | 可调 KL 权重 | loss = recon + β·KL。β 越高越解耦但越糊。 |
| VQ-VAE | 离散潜变量 | 把连续的 z 换成最近的码本向量;让 transformer 建模成为可能。 |
生产笔记:VAE 是扩散服务器里最热的路径
在 Stable Diffusion / Flux / SD3 流水线里,VAE 每次请求被调两次——一次编码(如果做 img2img / inpainting),一次解码。在 1024² 下,解码这一趟往往是整条流水线里单个最大的激活内存峰值,因为它要把 128×128×16 的潜变量上采样回 1024×1024×3。两个实际后果:
- 对解码做切片或分块。
diffusers暴露了pipe.vae.enable_slicing()和pipe.vae.enable_tiling()。分块用一点点接缝瑕疵换来O(tile²)而不是O(H·W)的内存。要在消费级 GPU 上跑 1024²+,这是必需的。 - bf16 解码器,最终缩放用 fp32 数值。 SD 1.x 的 VAE 是用 fp32 发布的,在 1024²+ 下被转成 fp16 时会悄悄产生 NaN。SDXL 带了
madebyollin/sdxl-vae-fp16-fix——永远优先用 fp16-fix 变体,或者用 bf16。
延伸阅读
- Kingma & Welling (2013). Auto-Encoding Variational Bayes —— VAE 那篇论文。
- Higgins et al. (2017). β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework —— 解耦的 β-VAE。
- van den Oord et al. (2017). Neural Discrete Representation Learning —— VQ-VAE。
- Vahdat & Kautz (2021). NVAE: A Deep Hierarchical Variational Autoencoder —— 顶尖水平的图像 VAE。
- Rombach et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models —— Stable Diffusion;VAE 作编码器。
- Défossez et al. (2022). High Fidelity Neural Audio Compression —— Encodec,音频 VAE 的标准。