RL 攻克游戏 —— AlphaZero、MuZero 与 LLM 推理时代
1992 年:TD-Gammon 用纯 TD 在西洋双陆棋上击败人类冠军。2016 年:AlphaGo 击败李世石。2017 年:AlphaZero 从零开始横扫国际象棋、将棋和围棋。2024 年:DeepSeek-R1 证明了同一套配方(用 GRPO 换掉 PPO)在推理上也行。游戏是驱动本阶段每个突破的那块基准。
类型: Build 语言: Python 前置要求: Phase 9 · 05(DQN)、Phase 9 · 08(PPO)、Phase 9 · 09(RLHF)、Phase 9 · 10(MARL) 预计时间: ~120 分钟
问题背景
游戏拥有 RL 想要的一切。干净的奖励(赢/输)。无限的 episode(自我对弈自动重置)。完美的仿真(游戏就是仿真器)。离散或小的连续动作空间。逼出对抗稳健性的多 agent 结构。
而且游戏是每个重大 RL 突破被检验的方式。TD-Gammon(西洋双陆棋,1992)。Atari-DQN(2013)。AlphaGo(2016)。AlphaZero(2017)。OpenAI Five(Dota 2,2019)。AlphaStar(《星际争霸 II》,2019)。MuZero(学习式模型,2019)。AlphaTensor(矩阵乘法,2022)。AlphaDev(排序算法,2023)。DeepSeek-R1(数学推理,2025)——最新一次证明游戏 RL 技术在文本上同样有效。
这门收官课通过一个统一的视角来巡览三个里程碑式架构——AlphaZero、MuZero、GRPO:自我对弈 + 搜索 + 策略改进。每一个都是上一个的推广;GRPO 尤其就是 AlphaZero 配方应用到 LLM 推理上,以 token 为动作、以数学验证为获胜信号。
核心概念
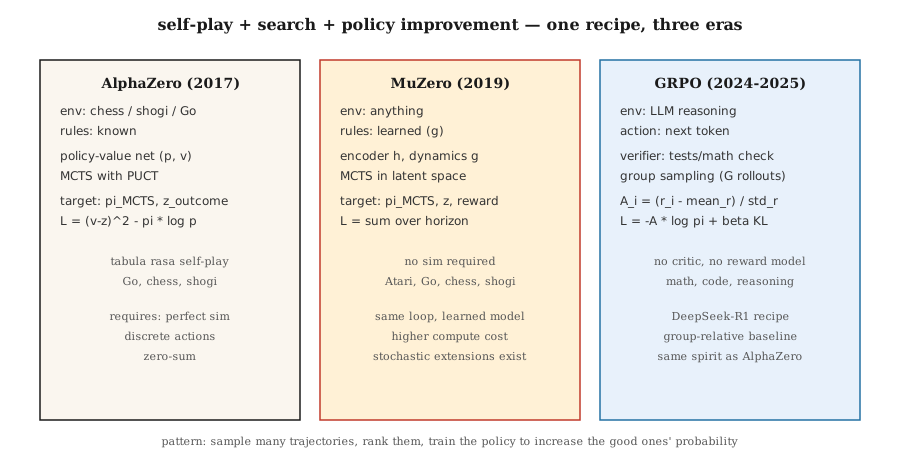
统一的循环。
while True:
    trajectory = self_play(current_policy, search)     # play game against self
    policy_target = search.improved_policy(trajectory) # search improves raw policy
    policy_net.update(policy_target, value_target)     # supervised on search output
AlphaZero(2017)。 Silver 等人。给定一个规则已知的游戏(国际象棋、将棋、围棋):
- 策略-价值网络:单塔
f_θ(s) → (p, v)。p是合法走子上的先验。v是期望对局结果。 - 蒙特卡洛树搜索(MCTS):每一步,展开一棵可能续法的树。用
(p, v)当先验 + 自举。用 UCB(PUCT)选节点:a* = argmax Q(s, a) + c · p(a|s) · √N(s) / (1 + N(s, a))。 - 自我对弈:让 agent 对阵 agent 下棋。在第
t步,MCTS 的访问分布π_t成为策略训练目标。 - 损失:
L = (v - z)² - π · log p + c · ||θ||²。z是对局结果(+1 / 0 / -1)。
零人类知识。零手工启发式。一套配方,各下几千万局自我对弈后就精通了国际象棋、将棋和围棋。
MuZero(2019)。 Schrittwieser 等人。去掉规则必须已知的要求。
- 不用固定环境,而是学一个潜在动力学模型
(h, g, f):h(s):把观测编码成潜在状态。g(s_latent, a):预测下一个潜在状态 + 奖励。f(s_latent):预测策略先验 + 价值。
- MCTS 在学到的潜在空间里跑。同样的搜索,同样的训练循环。
- 在围棋、国际象棋、将棋以及 Atari 上都能用——一个算法,无需规则知识。
Stochastic MuZero(2022)。 加入随机动力学和机会节点;扩展到西洋双陆棋这类游戏。
Muesli、Gumbel MuZero(2022-2024)。 在样本效率和确定性搜索上的改进。
GRPO(2024-2025)。 DeepSeek-R1 配方。同样的 AlphaZero 形状循环,应用到语言模型推理上:
"游戏":回答一道数学 / 编程 / 推理题。"赢" = 验证器(测试用例通过、数值答案对上)返回 1。
策略:LLM。动作:token。状态:prompt + 目前为止的回复。
没有 critic(PPO 式 V_φ)。而是对每个 prompt,从策略采样
G个补全。给每个算奖励。用组相对优势A_i = (r_i - mean_r) / std_r作为 REINFORCE 式更新的信号。到参考策略的 KL 惩罚,防止漂移(像 RLHF)。
完整损失:
<code v-pre>L_GRPO(θ) = -E_{q, {o_i}} [ (1/G) Σ_i A_i · log π_θ(o_i | q) ] + β · KL(π_θ || π_ref)</code>
没有奖励模型,没有 critic,没有 MCTS。组相对基线一举取代了这三者。在推理 benchmark 上以零头的算力匹敌或超过 PPO-RLHF 的质量。
完整的 R1 配方。 DeepSeek-R1(DeepSeek 2025)是一篇论文里的两个模型:
- R1-Zero。 从 DeepSeek-V3 基座模型出发。无 SFT。直接套用 GRPO,配两个奖励分量:准确率奖励(基于规则——最终答案是否解析成正确数字 / 代码是否通过单元测试)和格式奖励(补全是否把思维链裹进
<think>…</think>标签)。经过数千步,平均回复长度从约 100 增长到约 10000 token,数学 benchmark 分数攀升到接近 o1-preview 的水平。模型从零学会了推理。坏处:它的思维链常常不可读、混杂多种语言、缺乏风格打磨。 - R1。 用一条四阶段流水线修掉 R1-Zero 的可读性问题:
- 冷启动 SFT。 收集几千条格式干净的长思维链示范。在它们上对基座模型做监督微调。这给出一个可读的起点。
- 面向推理的 GRPO。 套用 GRPO,用准确率+格式奖励,再加一个语言一致性奖励来防止语言切换。
- 拒绝采样 + 第二轮 SFT。 从 RL 检查点采样约 60 万条推理轨迹,只保留最终答案正确且思维链可读的,再和约 20 万条非推理 SFT 样本(写作、问答、自我认知)合并。再次微调基座。
- 全谱 GRPO。 再做一轮 RL,同时覆盖推理(基于规则的奖励)和通用对齐(基于偏好的有帮助/无害奖励)。
结果在 AIME 和 MATH-500 上以开放权重匹敌 o1,而且小到能蒸馏。同一篇论文还通过在 R1 的推理轨迹上做 SFT,放出了六个蒸馏后的稠密模型(Qwen-1.5B 到 Llama-70B)——学生侧无 RL。在学生的规模上,从一个强 RL 老师蒸馏,始终胜过从零做 RL。
为什么推理用 GRPO 而不是 PPO。 DeepSeekMath 论文(2024 年 2 月)给了三个理由:(1)没有价值网络要训,内存减半;(2)组基线天然处理推理任务产生的稀疏的、轨迹末尾的奖励;(3)逐 prompt 归一化让难度天差地别的题目间的优势可比,这是 PPO 那个单一 critic 做不到的。
无搜索 vs 有搜索。 游戏已经分了岔:
- 长视野完全信息游戏(围棋、国际象棋):仍然有搜索。AlphaZero / MuZero 占主导。
- LLM 推理:生产里还没有 MCTS;在完整 rollout 上跑 GRPO,推理时用 best-of-N。过程奖励模型(PRM)暗示着步级搜索正在被加回来。
f3-selfplay-ladder动手构建
code/main.py 里的代码实现了微缩版 GRPO——一个带多组样本的赌博机。算法和在 LLM 上的一样;只是策略和环境更简单。它教的是 2025 年的创新所在:那个损失和组相对优势。
第 1 步:一个极小的验证器环境
QUESTIONS = [
    {"prompt": "q1", "correct": 3},
    {"prompt": "q2", "correct": 1},
]

def verify(prompt_idx, answer_token):
    return 1.0 if answer_token == QUESTIONS[prompt_idx]["correct"] else 0.0
真 GRPO 里验证器会跑单元测试或检查数学等式。
第 2 步:策略:每个 prompt 上 K 个答案 token 的 softmax
def policy_probs(theta, p_idx):
    return softmax(theta[p_idx])
等价于一个 LLM 以 prompt 为条件的最后一层输出。
第 3 步:组采样与组相对优势
def grpo_step(theta, p_idx, G=8, beta=0.01, lr=0.1, rng=None):
    probs = policy_probs(theta, p_idx)
    samples = [sample(probs, rng) for _ in range(G)]
    rewards = [verify(p_idx, s) for s in samples]
    mean_r = sum(rewards) / G
    std_r = stddev(rewards) + 1e-8
    advs = [(r - mean_r) / std_r for r in rewards]

    for a, A in zip(samples, advs):
        grad = onehot(a) - probs
        for i in range(len(probs)):
            theta[p_idx][i] += lr * A * grad[i]
    # KL penalty: pull theta toward reference
    for i in range(len(probs)):
        theta[p_idx][i] -= beta * (theta[p_idx][i] - reference[p_idx][i])
组相对优势是 2024 年 DeepSeek 的技巧。不需要 critic。"基线"是组均值,归一化用组标准差。
第 4 步:和 REINFORCE 基线对比(无价值)
同样的设置,同样的算力,朴素 REINFORCE。GRPO 收敛更快、更稳。
第 5 步:观察熵和 KL
和 RLHF 一样的诊断量:到参考的平均 KL、策略熵、随时间的奖励。这些稳定下来,训练就完成了。
注意事项
- 靠验证器作弊的奖励 hacking。 GRPO 继承了 RLHF 的风险:如果验证器错了或可被利用,LLM 就会找到那个漏洞。稳健的验证器(多个测试用例、形式化证明)很重要。
- 组太小。 组基线的方差大约按
1/√G走。低于G = 4,优势信号有噪声;标准选择是G = 8到64。 - 长度偏差。 不同长度的 LLM 补全有不同的对数概率。按 token 数归一化,或用序列级对数概率,或截断到最大长度。
- 纯自我对弈循环。 AlphaZero 式训练在一般和博弈上可能卡进支配循环。用多样化对手池缓解(联赛对弈,第 10 课)。
- 搜索-策略失配。 AlphaZero 训练策略去模仿搜索输出。如果策略网络太小、表示不了搜索的分布,训练就停滞。
- 算力门槛。 MuZero / AlphaZero 需要庞大算力。单次消融常常要几百 GPU 小时。有微缩 demo(如四子棋上的 AlphaZero)供学习。
- 验证器覆盖。 对一个有 bug 的解也通过的单元测试会强化那个 bug。设计能抓住边界情况的验证器。
实际使用
2026 年的游戏 RL 全景,按领域:
| 领域 | 主导方法 |
|---|---|
| 双人零和棋盘游戏(围棋、国际象棋、将棋) | AlphaZero / MuZero / KataGo |
| 不完全信息纸牌游戏(扑克) | CFR + 深度学习(DeepStack、Libratus、Pluribus) |
| Atari / 像素游戏 | Muesli / MuZero / IMPALA-PPO |
| 大型多人策略(Dota、星际) | PPO + 自我对弈 + 联赛(OpenAI Five、AlphaStar) |
| LLM 数学/代码推理 | GRPO(DeepSeek-R1、Qwen-RL、开源复现) |
| LLM 对齐 | DPO / RLHF-PPO(不是 GRPO;验证器是偏好而非可验证的) |
| 机器人 | PPO + DR(不是游戏 RL,但用同样的策略梯度工具) |
| 组合问题 | AlphaZero 变体(AlphaTensor、AlphaDev) |
这套配方——自我对弈、搜索增强的改进、策略蒸馏——横跨文本、像素和物理控制。GRPO 是最年轻的实例;还会有更多。
拿去用
存为 outputs/skill-game-rl-designer.md:
---
name: game-rl-designer
description: Design a game-RL or reasoning-RL training pipeline (AlphaZero / MuZero / GRPO) for a given domain.
version: 1.0.0
phase: 9
lesson: 12
tags: [rl, alphazero, muzero, grpo, self-play]
---

Given a target (perfect-info game / imperfect-info / Atari / LLM reasoning / combinatorial), output:

1. Environment fit. Known rules? Markov? Stochastic? Multi-agent? Informs AlphaZero vs MuZero vs GRPO.
2. Search strategy. MCTS (PUCT with learned prior), Gumbel-sampled, best-of-N, or none.
3. Self-play plan. Symmetric self-play / league / offline data / verifier-generated.
4. Target signal. Game outcome / verifier reward / preference / learned model. Include robustness plan.
5. Diagnostics. Win rate vs baseline, ELO curve, verifier pass rate, KL to reference.

Refuse AlphaZero on imperfect-info games (route to CFR). Refuse GRPO without a trusted verifier. Refuse any game-RL pipeline without a fixed baseline opponent set (self-play ELO is uncalibrated otherwise).
练习
- 简单。 在
code/main.py里实现 GRPO 赌博机。在 2 个 prompt × 各 4 个答案 token 上训练。用G=8在 < 1000 次更新内收敛。 - 中等。 接入 PPO(裁剪)和原版 REINFORCE。在同一个赌博机上和 GRPO 对比样本效率和奖励方差。
- 困难。 扩展到一条长度为 2 的"推理链":agent 吐出两个 token,验证器对这一对给奖励。测一下 GRPO 如何处理两步序列上的信用分配。(提示:对每条完整序列算组优势,传播到两个 token 位置。)
关键术语
| 术语 | 大家嘴上怎么说 | 它实际是什么 |
|---|---|---|
| MCTS | "配学习式网络的树搜索" | 蒙特卡洛树搜索;带学习式 (p, v) 先验的 UCB1/PUCT 选择。 |
| AlphaZero | "自我对弈 + MCTS" | 训练成匹配 MCTS 访问和对局结果的策略-价值网络。 |
| MuZero | "学习式模型的 AlphaZero" | 同样的循环,但通过学到的动力学在潜在空间里跑。 |
| GRPO | "无 critic 的 PPO" | 组相对策略优化;带组均值基线 + KL 的 REINFORCE。 |
| PUCT | "AlphaZero 的 UCB" | Q + c · p · √N / (1 + N_a) —— 在价值估计和先验间平衡。 |
| 自我对弈 | "agent 对阵过去的自己" | 零和的标准做法;对称训练信号。 |
| 联赛对弈 | "基于种群的自我对弈" | 把过去 + 当前 + exploiter 采样作对手。 |
| 验证器奖励 | "可验证 RL" | 奖励来自一个确定性检查器(测试通过、答案对上)。 |
| 过程奖励 | "PRM" | 给每个推理步打分,而不只是最终答案。 |
延伸阅读
- Silver et al. (2017). Mastering the game of Go without human knowledge (AlphaGo Zero)。
- Silver et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play (AlphaZero)。
- Schrittwieser et al. (2020). Mastering Atari, Go, chess and shogi by planning with a learned model (MuZero)。
- Vinyals et al. (2019). Grandmaster level in StarCraft II (AlphaStar)。
- DeepSeek-AI (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO) —— 引入 GRPO 和组相对基线的论文。
- DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning —— 完整的四阶段 R1 配方加上 R1-Zero 消融。
- Brown et al. (2019). Superhuman AI for multiplayer poker (Pluribus) —— 大规模 CFR + 深度学习。
- Tesauro (1995). Temporal Difference Learning and TD-Gammon —— 开启这一切的论文。
- Hugging Face TRL — GRPOTrainer —— 用自定义奖励函数套用 GRPO 的生产参考。
- Qwen Team (2024). Qwen2.5-Math — GRPO replication —— 多种规模上对 R1 配方的开源复现。
- Sutton & Barto (2018). Ch. 17 — Frontiers of Reinforcement Learning —— 自我对弈、搜索和"设计式奖励"的教科书框架,R1 在 LLM 规模上把它实例化了。