音频分类 —— 从 MFCC 上的 k-NN 到 AST 和 BEATs
从「狗叫还是警笛」到「这是哪种语言」,全都是音频分类。特征是梅尔。架构每隔十年换一次。评估始终是 AUC、F1 和各类别召回率。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(频谱图与梅尔)、阶段 3 · 06(CNN)、阶段 5 · 08(用于文本的 CNN 与 RNN) 预计时间: ~75 分钟
问题背景
你拿到一段 10 秒的音频,想知道「这是什么」:城市声音(警笛、电钻、狗叫)、语音命令(yes/no/stop)、语种识别(en/es/ar)、说话人情绪(愤怒/中性)或环境声(室内/室外、人声嘈杂)。这些全是音频分类,而 2026 年的基线架构已经成熟:对数梅尔 → CNN 或 Transformer → softmax。
核心难点不在网络,在数据。音频数据集有惨烈的类别不平衡、强烈的域偏移(干净 vs 嘈杂)和标签噪声(谁定的「城市嘈杂声」和「餐厅噪声」的界?)。这个问题 80% 在于数据筛选、增强和评估,而不是把 CNN 换成 Transformer。
核心概念
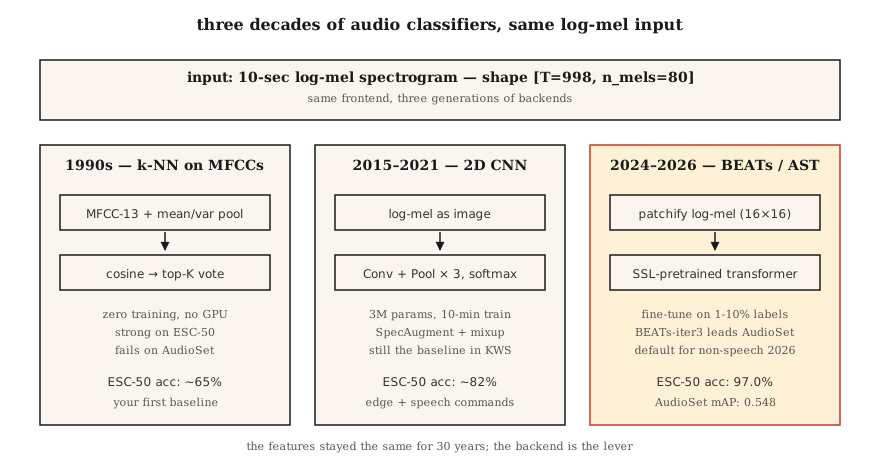
MFCC 上的 k-NN(1990 年代的基线)。 把每段音频的 MFCC 拉平,对一个带标签的库计算余弦相似度,返回 top K 的多数投票。在干净的小数据集上(Speech Commands、ESC-50)强得出乎意料。无需 GPU 就能跑。
对数梅尔上的 2D CNN(2015-2019)。 把 (T, n_mels) 的对数梅尔当成一张图,套 ResNet-18 或 VGG 风格的网络。对时间轴做全局平均池化,在类别上做 softmax。在 2026 年大多数 kaggle 竞赛里仍是基线。
Audio Spectrogram Transformer,AST(2021-2024)。 把对数梅尔切成 patch(比如 16×16),加位置嵌入,喂给一个 ViT。在 AudioSet 上是监督学习的当时最优(mAP 0.485)。
BEATs 和 WavLM-base(2024-2026)。 在数百万小时上做自监督预训练。用你原本所需监督数据的 1-10% 在你的任务上微调。2026 年这是非语音音频的默认起点。BEATs-iter3 在 AudioSet 上比 AST 高 1-2 个 mAP,而算力只用了 1/4。
Whisper 编码器作冻结骨干(2024)。 取 Whisper 的编码器,丢掉解码器,接一个线性分类器。在语种识别和简单事件分类上零音频增强就接近 SOTA。这是「免费午餐」式的基线。
类别不平衡才是真正的挑战
ESC-50:50 个类别,各 40 段——平衡,简单。UrbanSound8K:10 个类别,10:1 不平衡。AudioSet:632 个类别,10 万:1 的长尾。管用的技术:
- 训练时做平衡采样(评估时不做)。
- Mixup:把两段音频(及它们的标签)线性插值,当作增强。
- SpecAugment:随机遮蔽时间和频率条带。简单;关键。
评估
- 多类互斥(Speech Commands):top-1 准确率、top-5 准确率。
- 多类多标签(AudioSet、UrbanSound 这类):平均精度均值(mAP)。
- 严重不平衡:各类别召回率 + 宏观 F1。
你该知道的 2026 年数字:
| 基准 | 基线 | 2026 年 SOTA | 来源 |
|---|---|---|---|
| ESC-50 | 82%(AST) | 97.0%(BEATs-iter3) | BEATs 论文(2024) |
| AudioSet mAP | 0.485(AST) | 0.548(BEATs-iter3) | HEAR 排行榜 2026 |
| Speech Commands v2 | 98%(CNN) | 99.0%(Audio-MAE) | HEAR v2 结果 |
mfcc-pipeline动手构建
第 1 步:特征化
def featurize_mfcc(signal, sr, n_mfcc=13, n_mels=40, frame_len=400, hop=160):
    mag = stft_magnitude(signal, frame_len, hop)
    fb = mel_filterbank(n_mels, frame_len, sr)
    mels = apply_filterbank(mag, fb)
    log = log_transform(mels)
    return [dct_ii(frame, n_mfcc) for frame in log]
第 2 步:定长摘要
def summarize(mfcc_frames):
    n = len(mfcc_frames[0])
    mean = [sum(f[i] for f in mfcc_frames) / len(mfcc_frames) for i in range(n)]
    var = [
        sum((f[i] - mean[i]) ** 2 for f in mfcc_frames) / len(mfcc_frames) for i in range(n)
    ]
    return mean + var
简单但有力:沿时间取均值 + 方差,给 13 系数的 MFCC 一个 26 维的定长嵌入。瞬间跑完。直到 2017 年它还能在 ESC-50 上击败当时最优的神经网络基线。
第 3 步:k-NN
def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a)) or 1e-12
    nb = math.sqrt(sum(x * x for x in b)) or 1e-12
    return dot / (na * nb)

def knn_classify(q, bank, labels, k=5):
    sims = sorted(range(len(bank)), key=lambda i: -cosine(q, bank[i]))[:k]
    votes = Counter(labels[i] for i in sims)
    return votes.most_common(1)[0][0]
第 4 步:升级到对数梅尔上的 CNN
用 PyTorch:
import torch.nn as nn

class AudioCNN(nn.Module):
    def __init__(self, n_mels=80, n_classes=50):
        super().__init__()
        self.body = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        self.head = nn.Linear(128, n_classes)

    def forward(self, x):  # x: (B, 1, T, n_mels)
        return self.head(self.body(x).flatten(1))
300 万参数。在单张 RTX 4090 上约 10 分钟就能在 ESC-50 上训完,准确率 80%+。
第 5 步:2026 年的默认做法——微调 BEATs
from transformers import ASTFeatureExtractor, ASTForAudioClassification

ext = ASTFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
model = ASTForAudioClassification.from_pretrained(
    "MIT/ast-finetuned-audioset-10-10-0.4593",
    num_labels=50,
    ignore_mismatched_sizes=True,
)

inputs = ext(audio, sampling_rate=16000, return_tensors="pt")
logits = model(**inputs).logits
要用 BEATs,就通过 beats 库走 microsoft/BEATs-base;transformers 的 API 形状是一样的。
实际使用
2026 年的工具栈:
| 情形 | 从这里起步 |
|---|---|
| 极小数据集(<1000 段) | MFCC 均值上的 k-NN(你的基线)+ 音频增强 |
| 中等数据集(1K–100K) | 微调 BEATs 或 AST |
| 大数据集(>100K) | 从零训练,或微调 Whisper 编码器 |
| 实时、边缘端 | 40-MFCC 的 CNN,量化到 int8(KWS 风格) |
| 多标签(AudioSet) | BEATs-iter3 + BCE 损失 + mixup + SpecAugment |
| 语种识别 | MMS-LID、SpeechBrain VoxLingua107 基线 |
决策准则:从冻结骨干起步,而不是全新模型。微调一个 BEATs 头几小时就能拿到 95% 的 SOTA,而不是几周。
拿去用
存为 outputs/skill-classifier-designer.md。针对给定的音频分类任务,挑选架构、增强方式、类别平衡策略和评估指标。
练习
- 简单。 跑
code/main.py。它在一个 4 类合成数据集(不同音高的纯音)上训练 k-NN MFCC 基线。报告混淆矩阵。 - 中等。 把
summarize换成 [均值, 方差, 偏度, 峰度]。在同一个合成数据集上,4 阶矩池化能否胜过均值+方差? - 困难。 用
torchaudio在 ESC-50 的 fold 1 上训练一个 2D CNN。报告 5 折交叉验证准确率。加上 SpecAugment(时间遮蔽 = 20,频率遮蔽 = 10),报告差值。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| AudioSet | 音频界的 ImageNet | Google 的 200 万段、632 类弱标注 YouTube 数据集。 |
| ESC-50 | 小型分类基准 | 50 类 × 40 段环境声。 |
| AST | Audio Spectrogram Transformer | 对数梅尔 patch 上的 ViT;2021 年 SOTA。 |
| BEATs | 自监督音频 | 微软的模型,iter3 在 2026 年领跑 AudioSet。 |
| Mixup | 成对增强 | x = λ·x1 + (1-λ)·x2; y = λ·y1 + (1-λ)·y2。 |
| SpecAugment | 基于遮蔽的增强 | 把频谱图随机的时间和频率条带置零。 |
| mAP | 主要的多标签指标 | 跨类别和阈值的平均精度均值。 |
延伸阅读
- Gong, Chung, Glass (2021). AST: Audio Spectrogram Transformer —— 2021–2024 年的标杆架构。
- Chen et al. (2022, rev. 2024). BEATs: Audio Pre-Training with Acoustic Tokenizers —— 2024 年后的默认选择。
- Park et al. (2019). SpecAugment —— 占主导地位的音频增强方法。
- Piczak (2015). ESC-50 dataset —— 经久不衰的 50 类基准。
- Gemmeke et al. (2017). AudioSet —— 632 类 YouTube 分类体系;至今仍是黄金标准。