音频生成
音频是一个 16-48 kHz 的一维信号。一段五秒的片段是 8 万到 24 万个采样点。没有 transformer 能直接注意这么长的序列。2026 年每一个生产音频模型的解法都一样:一个神经编解码器(Encodec、SoundStream、DAC)把音频在 50-75 Hz 压成离散 token,再用一个 transformer 或扩散模型生成 token。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(音频特征)、阶段 6 · 04(ASR)、阶段 8 · 06(DDPM) 预计时间: ~45 分钟
问题背景
三个音频生成任务:
- 文本转语音。 给定文本,产出语音。干净语音是窄带的、有强语音结构——transformer-over-token 解得很好。VALL-E(微软)、NaturalSpeech 3、ElevenLabs、OpenAI TTS。
- 音乐生成。 给定一个 prompt(文本、旋律、和弦进行、流派),产出音乐。分布宽得多。MusicGen(Meta)、Stable Audio 2.5、Suno v4、Udio、Riffusion。
- 音效 / 声音设计。 给定一个 prompt,产出环境声或拟音。AudioGen、AudioLDM 2、Stable Audio Open。
三者都跑在同一套底座上:神经音频编解码器 + token 自回归或扩散生成器。
核心概念
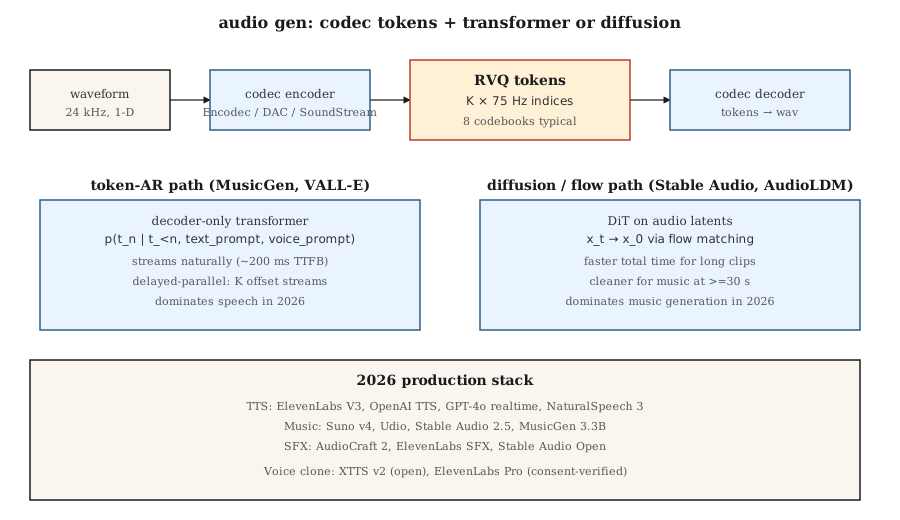
神经音频编解码器
Encodec(Meta, 2022)、SoundStream(Google, 2021)、Descript Audio Codec(DAC, 2023)。一个卷积编码器把波形压成逐时间步的向量;残差向量量化(RVQ)把每个向量转成一串 K 个码本索引。解码器把它反过来。24 kHz 音频在 2 kbps 下用 8 个 RVQ 码本、75 Hz = 每秒 600 个 token。
waveform (16000 samples/sec)
    └─ encoder conv ─┐
                     ├─ RVQ layer 1 → indices at 75 Hz
                     ├─ RVQ layer 2 → indices at 75 Hz
                     ├─ ...
                     └─ RVQ layer 8
上层的两种生成范式
Token 自回归。 把 RVQ token 拉平成一个序列,跑一个 decoder-only transformer。MusicGen 用「延迟并行」来以逐流偏移并行发出 K 个码本流。VALL-E 从一段文本 prompt + 3 秒语音样本生成语音 token。
潜空间扩散。 把编解码器 token 打包成连续潜变量,或用类别扩散给它们建模。Stable Audio 2.5 在连续音频潜变量上用流匹配。AudioLDM 2 用文本到 mel 到音频的扩散。
2024-2026 年的趋势:流匹配在音乐上胜出(推理更快、样本更干净),而 token 自回归在语音上仍占主导,因为它天然是因果的、流式很好。
生产格局
| 系统 | 任务 | 骨干 | 延迟 |
|---|---|---|---|
| ElevenLabs V3 | TTS | Token-AR + 神经声码器 | 首 token 约 300ms |
| OpenAI GPT-4o audio | 全双工语音 | 端到端多模态 AR | ~200ms |
| NaturalSpeech 3 | TTS | 潜空间流匹配 | 非流式 |
| Stable Audio 2.5 | 音乐 / 音效 | 在音频潜变量上 DiT + 流匹配 | 1 分钟片段约 10s |
| Suno v4 | 完整歌曲 | 未公开;疑似 token-AR | 每首约 30s |
| Udio v1.5 | 完整歌曲 | 未公开 | 每首约 30s |
| MusicGen 3.3B | 音乐 | 在 Encodec 32kHz 上做 Token-AR | 实时 |
| AudioCraft 2 | 音乐 + 音效 | 流匹配 | 5s 片段约 5s |
| Riffusion v2 | 音乐 | 频谱图扩散 | ~10s |
score-matching动手构建
code/main.py 模拟核心想法:在合成的「音频 token」序列上训一个迷你 next-token transformer,序列来自两种不同「风格」(风格 A 是低高 token 交替,风格 B 是单调爬升)。以风格为条件采样。
第 1 步:合成音频 token
def make_tokens(style, length, vocab_size, rng):
    if style == 0:  # "speech-like": alternating
        return [i % vocab_size for i in range(length)]
    # "music-like": ramp
    return [(i * 3) % vocab_size for i in range(length)]
第 2 步:训一个迷你 token 预测器
一个以风格为条件的 bigram 风格预测器。重点是那个模式:编解码器 token → 交叉熵训练 → 自回归采样。
第 3 步:条件式采样
给定风格 token 和一个起始 token,从预测分布里采下一个 token。继续 20-40 个 token。
坑
- 编解码器质量封顶了输出质量。 如果编解码器没法忠实表示某个声音,再好的生成器质量也救不了。DAC 是当前开源最佳。
- RVQ 误差累积。 每个 RVQ 层给上一层的残差建模。第 1 层上的误差会传播。在更高层用温度 0 采样有帮助。
- 音乐结构。 30 秒的 token 在 75 Hz 下是 2 万+ 个 token。对 transformer 很难。MusicGen 用滑动窗口 + prompt 续写;Stable Audio 用更短的片段 + 交叉淡化。
- 边界处的伪影。 生成片段之间的交叉淡化需要小心的重叠相加。
- 对干净数据的胃口。 音乐生成器需要数万小时的授权音乐。Suno / Udio 的 RIAA 诉讼(2024)把这事摆到了台面上。
- 声音克隆的伦理。 3 秒样本加一段文本 prompt 就够 VALL-E / XTTS / ElevenLabs 克隆一个声音了。每个生产模型都需要滥用检测 + 退出名单。
实际使用
| 任务 | 2026 年的栈 |
|---|---|
| 商用 TTS | ElevenLabs、OpenAI TTS,或 Azure Neural |
| 声音克隆(已验证同意) | XTTS v2(开源)或 ElevenLabs Pro |
| 背景音乐、快速 | Stable Audio 2.5 API、Suno,或 Udio |
| 带歌词的音乐 | Suno v4 或 Udio v1.5 |
| 音效 / 拟音 | AudioCraft 2、ElevenLabs SFX,或 Stable Audio Open |
| 实时语音 agent | GPT-4o realtime 或 Gemini Live |
| 开源权重音乐研究 | MusicGen 3.3B、Stable Audio Open 1.0、AudioLDM 2 |
| 配音 / 翻译 | HeyGen、ElevenLabs Dubbing |
拿去用
存为 outputs/skill-audio-brief.md。技能接受一份音频需求(任务、时长、风格、声音、许可),输出:模型 + 托管、prompt 格式(流派标签、风格描述符、结构标记)、编解码器 + 生成器 + 声码器链路、种子流程,以及评测计划(MOS / CLAP 分数 / TTS 的 CER / 用户 A/B)。
练习
- 简单。 跑
code/main.py并显式设定风格。验证生成的序列匹配该风格的模式。 - 中等。 加上延迟并行解码:模拟两条必须保持偏移 1 步的 token 流。训一个联合预测器。
- 困难。 用 HuggingFace transformers 在本地跑 MusicGen-small。用三个不同的 prompt 生成 10 秒片段;做风格遵循的 A/B。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 编解码器(Codec) | 「神经压缩」 | 音频的编码器 / 解码器;典型输出是 50-75 Hz 的 token。 |
| RVQ | 「残差 VQ」 | K 个量化器的级联;每个给上一个的残差建模。 |
| token | 「一个编解码器符号」 | 进入某个码本的离散索引;典型 1024 或 2048。 |
| 延迟并行 | 「偏移码本」 | 以错开的偏移发出 K 条 token 流来缩短序列长度。 |
| 流匹配 | 「2024 年音频的胜者」 | 比扩散路径更直的替代方案;采样更快。 |
| 声音 prompt | 「3 秒样本」 | 操纵克隆声音的说话人嵌入或 token 前缀。 |
| mel 频谱图 | 「那个可视图」 | 对数幅度的感知频谱图;许多 TTS 系统用它。 |
| 声码器(Vocoder) | 「mel 转波形」 | 把 mel 频谱图转回音频的神经组件。 |
生产笔记:音频是一个流式问题
音频是唯一一个用户期待边生成边到达而不是一次性出全的输出模态。用生产术语讲,这意味着 TPOT(每个输出 token 的时间)很关键,因为用户的收听速度才是目标吞吐——不是他们的阅读速度。对于在约 75 token/秒(Encodec)下 token 化的 16kHz 音频,服务器必须为每个用户生成 ≥75 token/秒才能让播放流畅。
两个架构后果:
- 流匹配音频模型没法轻易流式。 Stable Audio 2.5 和 AudioCraft 2 一趟渲染一个固定长度的片段。要流式,你得把片段切块并重叠边界——想想滑动窗口扩散——相比编解码器 AR 模型增加 100-300ms 的延迟开销。
如果产品是「实时语音聊天」或「实时音乐续写」,选编解码器 AR 路线。如果是「提交后渲染一段 30 秒片段」,流匹配在质量和总延迟上胜出。
延伸阅读
- Défossez et al. (2022). Encodec: High Fidelity Neural Audio Compression —— 编解码器标准。
- Zeghidour et al. (2021). SoundStream —— 第一个被广泛使用的神经音频编解码器。
- Kumar et al. (2023). High-Fidelity Audio Compression with Improved RVQGAN (DAC) —— DAC。
- Wang et al. (2023). Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers (VALL-E) —— VALL-E。
- Copet et al. (2023). Simple and Controllable Music Generation (MusicGen) —— MusicGen。
- Liu et al. (2023). AudioLDM 2: Learning Holistic Audio Generation with Self-supervised Pretraining —— AudioLDM 2。
- Stability AI (2024). Stable Audio 2.5 —— 2025 年用流匹配做文本转音乐。