频谱图、梅尔标度与音频特征
神经网络吃不好原始波形,但吃频谱图。吃梅尔频谱图更香。2026 年的每一个 ASR、TTS 和音频分类器,成败都系于这一个预处理选择。
类型: Build 语言: Python 前置要求: 阶段 6 · 01(音频基础) 预计时间: ~45 分钟
问题背景
拿一段 10 秒、16 kHz 的音频。那是 160,000 个浮点数,全在 [-1, 1] 区间,几乎和「狗叫」或「cat 这个词」这种标签毫不相关。原始波形里信息是有的,只是模型很难从这种形态里提取出来。同一个音素相隔 100 ms 念两遍,原始采样点完全不同。
频谱图解决了这个问题。它在人类感知忽略的地方(微秒级抖动)压掉时间细节,在感知关注的地方(哪些频率在大约 10–25 ms 的时间窗里能量旺盛)保留结构。
梅尔频谱图更进一步。人类对音高的感知是对数式的:100 Hz 与 200 Hz 之间「听起来的距离」,和 1000 Hz 与 2000 Hz 之间一样。梅尔标度把频率轴扭曲成匹配这种感知。从 2010 到 2026 年,梅尔标度频谱图都是语音 ML 里最重要的单一特征。
核心概念
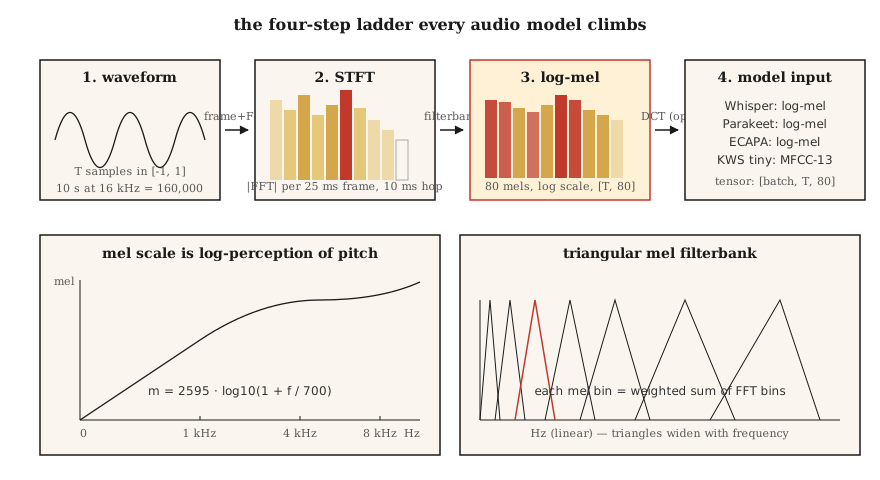
STFT(短时傅里叶变换)。 把波形切成有重叠的帧(典型值:25 ms 窗、10 ms 跳步 = 16 kHz 下的 400 个采样点 / 160 个采样点)。每帧乘以一个窗函数(默认 Hann;Hamming 是略有不同的权衡)。每帧做 FFT。把幅值谱堆成形状为 (n_frames, n_freq_bins) 的矩阵。这就是你的频谱图。
对数幅值(Log-magnitude)。 原始幅值横跨 5-6 个数量级。取 log(|X| + 1e-6) 或 20 * log10(|X|) 来压缩动态范围。每条生产流水线用的都是对数幅值,不是原始幅值。
梅尔标度(Mel scale)。 频率 f(Hz)通过 m = 2595 * log10(1 + f / 700) 映射到梅尔值 m。这个映射在 1 kHz 以下大致线性,以上大致对数。覆盖 0–8 kHz 的 80 个梅尔分箱是标准的 ASR 输入。
梅尔滤波器组(Mel filterbank)。 一组在梅尔标度上等间距排列的三角滤波器。每个滤波器是相邻 FFT 分箱的加权和。把 STFT 幅值乘以滤波器组矩阵,一次矩阵乘法就得到梅尔频谱图。
对数梅尔频谱图(Log-mel spectrogram)。 log(mel_spec + 1e-10)。Whisper 的输入,Parakeet 的输入,SeamlessM4T 的输入。2026 年通用的音频前端。
MFCC。 拿对数梅尔频谱图做一次 DCT(II 型),保留前 13 个系数。让特征去相关并进一步压缩。直到大约 2015 年原始对数梅尔上的 CNN/Transformer 追上来之前,它都是主流特征。如今仍用于说话人识别(x-vectors、ECAPA)。
分辨率权衡。 FFT 越大 = 频率分辨率越好,但时间分辨率越差。25 ms / 10 ms 是音频 ML 的默认值;音乐用 50 ms / 12.5 ms;瞬态检测(鼓点、爆破音)用 5 ms / 2 ms。
spectrogram-window动手构建
第 1 步:给波形分帧
def frame(signal, frame_len, hop):
    n = 1 + (len(signal) - frame_len) // hop
    return [signal[i * hop : i * hop + frame_len] for i in range(n)]
一段 10 秒、16 kHz 的音频,配 frame_len=400, hop=160,得到 998 帧。
第 2 步:Hann 窗
import math

def hann(N):
    return [0.5 * (1 - math.cos(2 * math.pi * n / (N - 1))) for n in range(N)]
FFT 之前逐元素相乘。消除在非零端点处截断所导致的频谱泄漏。
第 3 步:STFT 幅值
def stft_magnitude(signal, frame_len=400, hop=160):
    win = hann(frame_len)
    frames = frame(signal, frame_len, hop)
    return [magnitudes(dft([w * s for w, s in zip(win, f)])) for f in frames]
生产环境用 torch.stft 或 librosa.stft(FFT 支撑、向量化)。这里的循环是为了教学;它在 code/main.py 里只跑短音频。
第 4 步:梅尔滤波器组
def hz_to_mel(f):
    return 2595.0 * math.log10(1.0 + f / 700.0)

def mel_to_hz(m):
    return 700.0 * (10 ** (m / 2595.0) - 1)

def mel_filterbank(n_mels, n_fft, sr, fmin=0, fmax=None):
    fmax = fmax or sr / 2
    mels = [hz_to_mel(fmin) + (hz_to_mel(fmax) - hz_to_mel(fmin)) * i / (n_mels + 1)
            for i in range(n_mels + 2)]
    hzs = [mel_to_hz(m) for m in mels]
    bins = [int(h * n_fft / sr) for h in hzs]
    fb = [[0.0] * (n_fft // 2 + 1) for _ in range(n_mels)]
    for m in range(n_mels):
        for k in range(bins[m], bins[m + 1]):
            fb[m][k] = (k - bins[m]) / max(1, bins[m + 1] - bins[m])
        for k in range(bins[m + 1], bins[m + 2]):
            fb[m][k] = (bins[m + 2] - k) / max(1, bins[m + 2] - bins[m + 1])
    return fb
80 个梅尔覆盖 0–8 kHz、n_fft=400,得到一个 (80, 201) 的矩阵。把 (n_frames, 201) 的 STFT 幅值乘以它的转置,得到 (n_frames, 80) 的梅尔频谱图。
第 5 步:对数梅尔
def log_mel(mel_spec, eps=1e-10):
return [[math.log(max(v, eps)) for v in frame] for frame in mel_spec]常见的替代做法:librosa.power_to_db(以参考值归一化的 dB)、10 * log10(power + eps)。Whisper 用的是更繁琐的裁剪 + 归一化流程(见 Whisper 的 log_mel_spectrogram)。
第 6 步:MFCC
def dct_ii(x, n_coeffs):
    N = len(x)
    return [
        sum(x[n] * math.cos(math.pi * k * (2 * n + 1) / (2 * N)) for n in range(N))
        for k in range(n_coeffs)
    ]
对每一个对数梅尔帧做 DCT,保留前 13 个系数。这就是你的 MFCC 矩阵。第一个系数通常会丢掉(它编码的是整体能量)。
实际使用
2026 年的工具栈:
| 任务 | 特征 |
|---|---|
| ASR(Whisper、Parakeet、SeamlessM4T) | 80 个对数梅尔,10 ms 跳步,25 ms 窗 |
| TTS 声学模型(VITS、F5-TTS、Kokoro) | 80 个梅尔,5–12 ms 跳步做精细时间控制 |
| 音频分类(AST、PANNs、BEATs) | 128 个对数梅尔,10 ms 跳步 |
| 说话人嵌入(ECAPA-TDNN、WavLM) | 80 个对数梅尔,或原始波形 SSL |
| 音乐(MusicGen、Stable Audio 2) | EnCodec 离散 token(不是梅尔) |
| 关键词检测 | 给微型设备用的 40 个 MFCC |
经验法则:只要不是做音乐,就从 80 个对数梅尔起步。 任何偏离这条路的做法都得自己举证。
2026 年仍在上线的坑
- 梅尔数量不匹配。 训练用 80 个梅尔,推理用 128 个梅尔。静默失败。在两头都把特征 shape 打印出来。
- 上游采样率不匹配。 22.05 kHz 算出的梅尔和 16 kHz 长得不一样。在特征化之前把 SR 修对。
- dB 还是 log。 Whisper 期望对数梅尔,不是 dB 梅尔。有些 HF 流水线会自动检测;你的自定义代码不会。
- 归一化漂移。 训练时按每条语音归一化,推理时按全局归一化。这个生产 bug 会让 WER 翻倍。
- padding 引入的泄漏。 在音频末尾补零会让尾部那些帧产生一段平坦的频谱。对称 padding 或做复制填充。
拿去用
存为 outputs/skill-feature-extractor.md。这个 skill 针对给定的模型目标,挑选特征类型、梅尔数量、帧长/跳步和归一化方式。
练习
- 简单。 跑
code/main.py。它合成一段啁啾信号(频率从 200 → 4000 Hz 扫过),并打印每帧的 argmax 梅尔分箱。画出来(可选),确认它与扫频一致。 - 中等。 用
n_mels取\{40, 80, 128\}、frame_len取\{200, 400, 800\}重跑。沿时间轴测量尖峰的带宽。哪种组合把啁啾信号分辨得最好? - 困难。 实现
power_to_db,并在 AudioMNIST 上用一个微型 CNN 分类器比较 ASR 准确率:(a) 原始对数梅尔,(b)ref=max的 dB 梅尔,(c) MFCC-13 + delta + delta-delta。报告 top-1 准确率。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 帧(Frame) | 一个切片 | 喂给一次 FFT 的 25 ms 波形块。 |
| 跳步(Hop) | 步长 | 相邻两帧之间的采样点数;ASR 默认 10 ms。 |
| 窗(Window) | Hann/Hamming 那玩意 | 把帧边缘渐变到零的逐点乘子。 |
| STFT | 频谱图生成器 | 分帧 + 加窗的 FFT;产出 时间 × 频率 的矩阵。 |
| 梅尔(Mel) | 扭曲后的频率 | 对数感知标度;m = 2595·log10(1 + f/700)。 |
| 滤波器组(Filterbank) | 那个矩阵 | 把 STFT 投影到梅尔分箱的三角滤波器。 |
| 对数梅尔(Log-mel) | Whisper 的输入 | log(mel_spec + eps);2026 年的标准化做法。 |
| MFCC | 老派特征 | 对数梅尔的 DCT;13 个系数,去相关。 |
延伸阅读
- Davis, Mermelstein (1980). Comparison of parametric representations for monosyllabic word recognition —— MFCC 那篇论文。
- Stevens, Volkmann, Newman (1937). A Scale for the Measurement of the Psychological Magnitude Pitch —— 最早的梅尔标度。
- OpenAI — Whisper source, log_mel_spectrogram —— 读一读参考实现。
- librosa feature extraction docs ——
mfcc、melspectrogram以及跳步/窗的参考。 - NVIDIA NeMo — audio preprocessing —— Parakeet + Canary 模型的生产级流水线。