潜空间扩散与 Stable Diffusion
在 512×512 图像上做像素空间扩散是一桩算力战争罪。Rombach 等人(2022)注意到,你不需要全部 78.6 万维来生成一张图——你需要的是足够捕捉语义结构的维度,外加一个单独的解码器去管剩下的。在 VAE 的潜空间里跑扩散。就这一个想法,就是 Stable Diffusion。
类型: Build 语言: Python 前置要求: 阶段 8 · 02(VAE)、阶段 8 · 06(DDPM)、阶段 7 · 09(ViT) 预计时间: ~75 分钟
问题背景
512² 下的像素空间扩散意味着 U-Net 跑在形状为 [B, 3, 512, 512] 的张量上。对一个 500M 参数的 U-Net,每个采样步约 100 GFLOPS。五十步就是每张图 5 TFLOPS。在十亿张图上训练,算力账单荒唐到家。
这些 FLOPs 大多花在把感知上无关紧要的细节推过网络——那些有损 VAE 本可以压掉的高频纹理。Rombach 的想法:把 VAE 训一次(第一阶段),冻结它,然后完全在 4 通道 64×64 的潜空间里跑扩散(第二阶段)。同样的 U-Net。1/16 的像素。在可比质量下约少 64 倍的 FLOPs。
这就是 Stable Diffusion 的配方。SD 1.x / 2.x 在 64×64×4 潜变量上用一个 860M 的 U-Net,SDXL 在 128×128×4 上用 2.6B 的 U-Net,SD3 把 U-Net 换成了一个带流匹配的 Diffusion Transformer(DiT)。Flux.1-dev(Black Forest Labs, 2024)上线了一个 12B 参数的 DiT-MMDiT。它们全都跑在同一套两阶段底座上。
核心概念
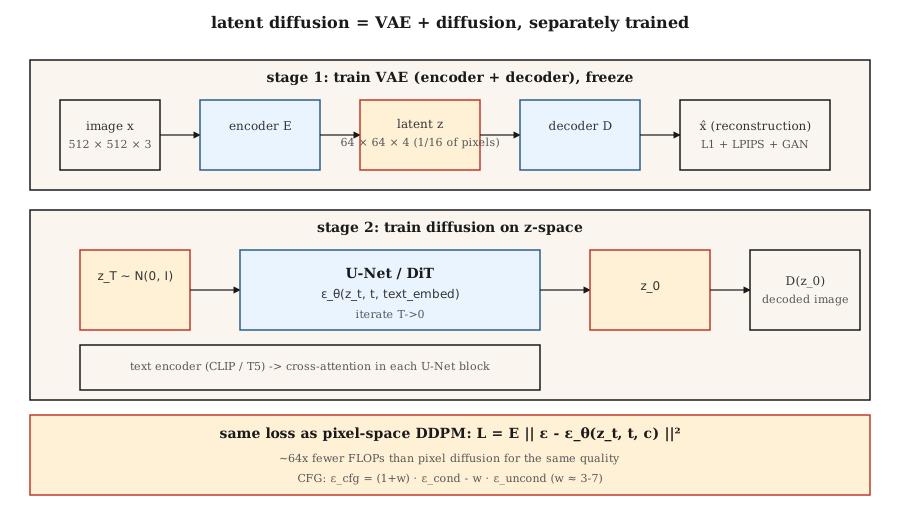
两个阶段,分开训练。
第一阶段 —— VAE。 编码器
E(x) → z,解码器D(z) → x。目标压缩:每个空间轴下采样 8 倍 + 调整通道数,使总潜变量大小约为像素数的 1/16。损失 = 重建(L1 + LPIPS 感知)+ KL(小权重,让z不被逼得太高斯,因为我们不需要从z精确采样)。常常带一个对抗损失训练,使解码出的图像锐利。第二阶段 —— 在
z上做扩散。 把z = E(x_real)当数据。训一个 U-Net(或 DiT)来给z_t去噪。推理时:通过扩散采出z_0,再x = D(z_0)。
文本条件化。 两个额外组件。一个冻结的文本编码器(SD 1.x 用 CLIP-L,SD 2/XL 用 CLIP-L+OpenCLIP-G,SD3 和 Flux 用 T5-XXL)。一个交叉注意力注入:每个 U-Net 块接受 [Q = 图像特征, K = V = 文本 token] 并把它们混进去。这些 token 是文本影响图像的唯一途径。
损失函数和第 06 课完全一致。 同样在噪声上做 DDPM / 流匹配 MSE。你只是换了数据域。
架构变体
| 模型 | 年份 | 骨干 | 潜变量形状 | 文本编码器 | 参数 |
|---|---|---|---|---|---|
| SD 1.5 | 2022 | U-Net | 64×64×4 | CLIP-L(77 token) | 860M |
| SD 2.1 | 2022 | U-Net | 64×64×4 | OpenCLIP-H | 865M |
| SDXL | 2023 | U-Net + refiner | 128×128×4 | CLIP-L + OpenCLIP-G | 2.6B + 6.6B |
| SDXL-Turbo | 2023 | 蒸馏 | 128×128×4 | 同上 | 1-4 步采样 |
| SD3 | 2024 | MMDiT(多模态 DiT) | 128×128×16 | T5-XXL + CLIP-L + CLIP-G | 2B / 8B |
| Flux.1-dev | 2024 | MMDiT | 128×128×16 | T5-XXL + CLIP-L | 12B |
| Flux.1-schnell | 2024 | MMDiT 蒸馏 | 128×128×16 | T5-XXL + CLIP-L | 12B,1-4 步 |
趋势:用 DiT(在潜变量 patch 上的 transformer)替换 U-Net,扩大文本编码器(在 prompt 遵循上 T5 胜过 CLIP),增加潜变量通道(4 → 16 给出更多细节余量)。
noise-schedule动手构建
code/main.py 在第 06 课的 DDPM 之上叠了一个玩具一维「VAE」(恒等编码器 + 解码器,用作演示;真正的 VAE 会是卷积网络),并加上带无分类器引导的类别条件。它表明同一个扩散损失无论你跑在原始一维值上还是编码后的值上都管用——这就是关键洞见。
第 1 步:编码器/解码器
def encode(x):    return x * 0.5          # toy "compression" to smaller scale
def decode(z):    return z * 2.0
真正的 VAE 有训出来的权重。出于教学目的,这个线性映射足以说明扩散作用在 z 上而不关心原始数据空间。
第 2 步:在 z 空间里做扩散
跟第 06 课一样的 DDPM。网络看到的数据是 z = E(x)。采出 z_0 后,用 D(z_0) 解码。
第 3 步:无分类器引导
训练时 10% 概率丢掉类别标签(换成一个空 token)。推理时算出 ε_cond 和 ε_uncond 两者,然后:
eps_cfg = (1 + w) * eps_cond - w * eps_uncondw = 0 = 不引导(完全多样),w = 3 = 默认,w = 7+ = 饱和 / 过锐。
第 4 步:文本条件化(概念,不是代码)
把类别标签换成一个冻结文本编码器的输出。通过交叉注意力把文本嵌入喂给 U-Net:
h = h + CrossAttention(Q=h, K=text_embed, V=text_embed)这是一个类别条件扩散模型和 Stable Diffusion 之间唯一实质性的区别。
坑
- VAE 缩放不匹配。 SD 1.x 的 VAE 在编码后会乘一个缩放常数(
scaling_factor ≈ 0.18215)。忘了它会让 U-Net 训练在方差大错特错的潜变量上。每个检查点都带着一个。 - 文本编码器悄悄出错。 SD3 需要 T5-XXL 且 token 数 >=128,回退到只用 CLIP 是有损的。永远检查
use_t5=True,否则 prompt 保真度暴跌。 - 混用潜空间。 SDXL、SD3、Flux 用的都是不同的 VAE。在 SDXL 潜变量上训的 LoRA 在 SD3 上不会工作。Hugging Face diffusers 0.30+ 会拒绝加载不匹配的检查点。
- CFG 太高。
w > 10产出饱和、油腻的图像,以多样性为代价过拟合 prompt。甜点区是w = 3-7。 - 负面 prompt 泄露。 空的负面 prompt 变成空 token;填了内容的负面 prompt 变成
ε_uncond。这两者不是一回事;有些流水线会悄悄默认成空 token。
实际使用
2026 年的生产栈:
| 目标 | 推荐骨干 |
|---|---|
| 窄领域、成对数据、从零训一个模型 | SDXL 微调(LoRA / 全量)——上线最快 |
| 开放领域文生图、开源权重 | Flux.1-dev(12B,Apache / 非商用)或 SD3.5-Large |
| 最快推理、开源权重 | Flux.1-schnell(1-4 步,Apache)或 SDXL-Lightning |
| 最佳 prompt 遵循、托管 | GPT-Image / DALL-E 3(仍然行)、Midjourney v7、Imagen 4 |
| 编辑工作流 | Flux.1-Kontext(2024 年 12 月)——原生接受图像 + 文本 |
| 研究、基线 | SD 1.5——古老但研究得很透 |
拿去用
存为 outputs/skill-sd-prompter.md。技能接受一个文本 prompt + 目标风格,输出:模型 + 检查点、CFG 强度、采样器、负面 prompt、分辨率、可选的 ControlNet/IP-Adapter 组合,以及一份逐步的 QA 清单。
练习
- 简单。 用引导
w ∈ \{0, 1, 3, 7, 15\}跑code/main.py。按类别记录平均样本。w到多少时类别均值偏过了真实数据的均值? - 中等。 把玩具线性编码器换成一对带重建损失的 tanh-MLP 编码器/解码器。在新的潜变量上重训扩散。样本质量变了吗?
- 困难。 用 diffusers 搭一个真正的 Stable Diffusion 推理:加载
sdxl-base,跑 30 步 Euler、CFG=7,计时。然后换成sdxl-turbo,4 步、CFG=0。同一个主体,不同质量——描述变了什么、为什么。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 第一阶段 | 「那个 VAE」 | 训出来的编码器/解码器对;把 512² 压成 64²。 |
| 第二阶段 | 「那个 U-Net」 | 潜空间上的扩散模型。 |
| CFG | 「引导强度」 | (1+w)·ε_cond - w·ε_uncond;调条件作用的强度。 |
| 空 token | 「空 prompt 嵌入」 | 用作 ε_uncond 的无条件嵌入。 |
| 交叉注意力 | 「文本怎么进来的」 | 每个 U-Net 块把文本 token 当 K 和 V 来注意。 |
| DiT | 「Diffusion Transformer」 | 用一个在潜变量 patch 上的 transformer 替换 U-Net;扩展性更好。 |
| MMDiT | 「多模态 DiT」 | SD3 的架构:文本流和图像流做联合注意力。 |
| VAE 缩放因子 | 「魔法数字」 | 把潜变量除以约 5.4,让扩散在单位方差空间里工作。 |
生产笔记:在一块 8GB 消费级 GPU 上跑 Flux-12B
那个参考 Flux 集成是经典的「我有一块消费级 GPU,能上线这个吗?」配方。诀窍就是生产推理文献列出的那同样三个旋钮,套在一个扩散 DiT 上:
- 错峰加载。 Flux 有三个网络永远不需要同时待在显存里:T5-XXL 文本编码器(fp32 下约 10 GB)、CLIP-L(小)、12B 的 MMDiT,以及 VAE。先编码 prompt,删掉编码器,加载 DiT,去噪,删掉 DiT,加载 VAE,解码。消费级 8GB GPU 一次只装得下一个阶段。
- 通过 bitsandbytes 做 4-bit 量化。 对 T5 编码器和 DiT 都用
BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.bfloat16)。内存砍 8 倍,按 Aritra 的基准(笔记本里有链接)文生图的质量下降感知不到。 - CPU offload。
pipe.enable_model_cpu_offload()随着每次前向推进自动在 CPU 和 GPU 之间换模块。加 10-20% 延迟,但让流水线根本跑得起来。
内存账是这样算的:10 GB T5 / 8 = 1.25 GB 量化后,12 B 参数 × 0.5 字节 = ~6 GB 量化后的 DiT,再加上激活。用 stas00 的话说这是 TP=1 推理的极端端——没有模型并行,最大量化。生产上你会在 H100 上跑 TP=2 或 TP=4;对单台开发笔记本,这就是那个配方。
延伸阅读
- Rombach et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models —— Stable Diffusion。
- Podell et al. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis —— SDXL。
- Peebles & Xie (2023). Scalable Diffusion Models with Transformers (DiT) —— DiT。
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis —— SD3,MMDiT。
- Ho & Salimans (2022). Classifier-Free Diffusion Guidance —— CFG。
- Labs (2024). Flux.1 — Black Forest Labs announcement —— Flux.1 家族。
- Hugging Face Diffusers docs —— 上面每个检查点的参考实现。