StyleGAN
大多数生成器把
z同时搅进每一层。StyleGAN 把它拆开了:先把z映成一个中间的w,再通过 AdaIN 在每个分辨率层级上注入w。就这一个改动解开了潜空间的纠缠,让写实人脸连续七年都是一个已解决的问题。
类型: Build 语言: Python 前置要求: 阶段 8 · 03(GAN)、阶段 4 · 08(归一化)、阶段 3 · 07(CNN) 预计时间: ~45 分钟
问题背景
DCGAN 通过一摞转置卷积把 z 映成图像。问题是:z 控制一切——姿态、光照、身份、背景——全纠缠在一起。沿 z 的某一个轴移动,这四样一起变。你没法对模型说「同一个人,不同姿态」,因为这个表示就不是那么分解的。
Karras 等人(2019,NVIDIA)提出:别再把 z 直接喂进卷积层。把一个常数 4×4×512 张量作为网络输入。学一个 8 层 MLP,把 z ∈ Z → w ∈ W。通过自适应实例归一化(AdaIN)在每个分辨率上注入 w:先归一化每张卷积特征图,再用 w 的仿射投影来缩放和平移它。再加上逐层噪声来产生随机细节(皮肤毛孔、发丝)。
结果是:W 大致有正交的轴,分别管「高层风格」(姿态、身份)和「精细风格」(光照、颜色)。你可以在两张图像之间交换风格——低分辨率层级用图像 A 的 w,高分辨率层级用图像 B 的 w。这解锁了编辑、跨域风格化,以及整条「StyleGAN 反演」研究线。
核心概念
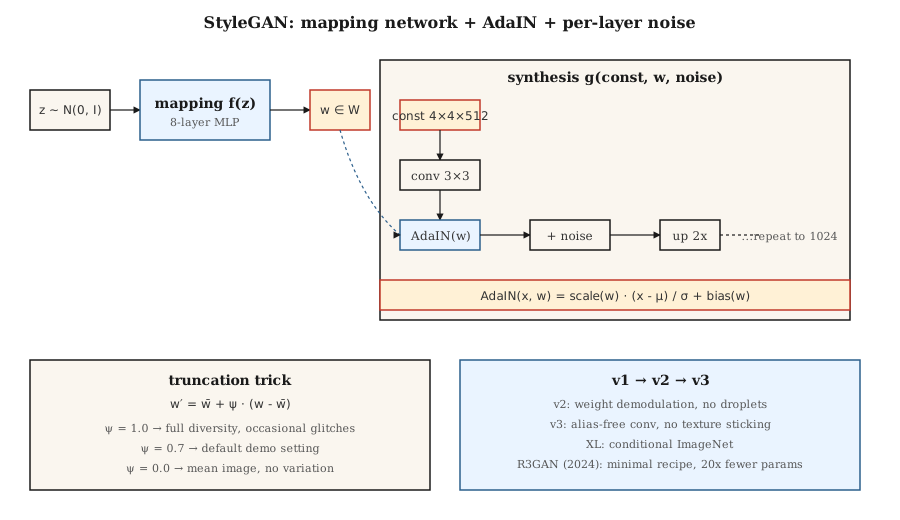
映射网络。 f: Z → W,一个 8 层 MLP。Z = N(0, I)^512。W 不被强制为高斯——它学出一个适配数据的形状。
合成网络。 从一个学出来的常数 4×4×512 开始。每个分辨率块:upsample → conv → AdaIN(w_i) → noise → conv → AdaIN(w_i) → noise。分辨率翻倍:4、8、16、32、64、128、256、512、1024。
AdaIN。
AdaIN(x, y) = y_scale · (x - mean(x)) / std(x) + y_bias其中 y_scale 和 y_bias 来自 w 的仿射投影。逐特征图归一化,然后重新上风格。这里的「风格」就是特征图的一阶和二阶统计量。
逐层噪声。 给每张特征图加上单通道高斯噪声,按一个学出来的逐通道因子缩放。在不影响全局结构的前提下控制随机细节。
截断技巧。 推理时,采样 z,算 w = mapping(z),再 w' = ŵ + ψ·(w - ŵ),其中 ŵ 是大量样本上 w 的均值。ψ < 1 用多样性换质量。几乎每个 StyleGAN 演示都用 ψ ≈ 0.7。
StyleGAN 1 → 2 → 3
| 版本 | 年份 | 创新 |
|---|---|---|
| StyleGAN | 2019 | 映射网络 + AdaIN + 噪声 + 渐进式增长。 |
| StyleGAN2 | 2020 | 权重解调替换 AdaIN(修了水滴伪影);skip/残差架构;路径长度正则化。 |
| StyleGAN3 | 2021 | 无混叠卷积 + 等变核;消除纹理粘在像素网格上的问题。 |
| StyleGAN-XL | 2022 | 类别条件、1024²、ImageNet。 |
| R3GAN | 2024 | 用更强的正则化重新包装;在 FFHQ-1024 上以少 20 倍的参数追平扩散。 |
到 2026 年,StyleGAN3 在以下场景仍是默认:(a) 高帧率下的窄领域写实,(b) 少样本域适应(用 100 张图训一个新数据集,冻结映射网络),(c) 基于反演的编辑(找出能重建一张真照片的那个 w,再编辑这个 w)。对于开放领域文生图,它不是趁手的工具——扩散才是。
gx-stylegan-mapping动手构建
code/main.py 在一维上实现一个玩具版「style-GAN lite」:一个映射 MLP、一个合成函数(接受一个学出来的常数向量,用 w 派生的 scale/bias 来调制它),以及逐层噪声。它表明通过仿射调制注入 w 能追平甚至胜过把 z 拼接进生成器的输入。
第 1 步:映射网络
def mapping(z, M):
    h = z
    for i in range(num_layers):
        h = leaky_relu(add(matmul(M[f"W{i}"], h), M[f"b{i}"]))
    return h
第 2 步:自适应实例归一化
def adain(x, w_scale, w_bias):
    mu = mean(x)
    sd = std(x)
    x_norm = [(xi - mu) / (sd + 1e-8) for xi in x]
    return [w_scale * xi + w_bias for xi in x_norm]
逐特征图的 scale 和 bias 通过线性投影从 w 得来。
第 3 步:逐层噪声
def add_noise(x, sigma, rng):
    return [xi + sigma * rng.gauss(0, 1) for xi in x]
逐通道的 sigma 是可学习的。
坑
- 水滴伪影。 StyleGAN 1 在特征图里产生一个团块状的水滴,因为 AdaIN 把均值归了零。StyleGAN 2 的权重解调改成缩放卷积权重来修这个问题。
- 纹理粘连。 StyleGAN 1 和 2 的纹理跟着像素坐标走,而不是物体坐标(插值时看得见)。StyleGAN 3 的无混叠卷积用加窗 sinc 滤波器修了它。
- 模式覆盖。 截断
ψ < 0.7看着干净,但采样自一个狭窄的锥;如果你需要多样性就用ψ = 1.0。 - 反演有损。 把一张真照片反演进
W通常靠优化或一个编码器(e4e、ReStyle、HyperStyle)。结果会在多次迭代中漂移。
实际使用
| 使用场景 | 做法 |
|---|---|
| 写实人脸(动漫、产品、窄领域) | StyleGAN3 FFHQ / 自定义微调 |
| 从一张照片做人脸编辑 | e4e 反演 + StyleSpace / InterFaceGAN 方向 |
| 换脸 / 表情重演 | StyleGAN + 编码器 + 融合 |
| 头像流水线 | 带 ADA 的 StyleGAN3,用于低数据微调 |
| 从几张图做域适应 | 冻结映射网络,微调合成网络 |
| 多模态或文本条件生成 | 别——用扩散 |
对于答案就是「某个人脸的照片」的产品级演示,在相同质量门槛下,StyleGAN 在推理成本(单次前向、4090 上 <10ms)和锐度上都胜过扩散。
拿去用
存为 outputs/skill-stylegan-inversion.md。技能接受一张真照片,输出:反演方法(e4e / ReStyle / HyperStyle)、预期的潜变量损失、编辑预算(在 W 里能移多远才不出伪影),以及一份已知好用的编辑方向清单(年龄、表情、姿态)。
练习
- 简单。 分别用
adain_on=True和adain_on=False跑code/main.py。比较固定潜变量与扰动潜变量下输出的离散程度。 - 中等。 实现混合正则化:对一个训练批,算出
w_a、w_b,合成的前半段用w_a、后半段用w_b。解码器学出解耦的风格了吗? - 困难。 拿一个预训练的 StyleGAN3 FFHQ 模型(ffhq-1024.pkl)。在带标签的样本上训练一个 SVM,找出控制「微笑」的那个
w方向;报告在身份开始漂移之前你能推多远。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 映射网络 | 「那个 MLP」 | f: Z → W,8 层,把潜变量几何与数据统计解耦。 |
| W 空间 | 「风格空间」 | 映射网络的输出;大致解耦。 |
| AdaIN | 「自适应实例归一化」 | 归一化特征图,再用 w 投影来缩放 + 平移。 |
| 截断技巧 | 「Psi」 | w = mean + ψ·(w - mean),ψ<1 用多样性换质量。 |
| 路径长度正则化 | 「PL reg」 | 惩罚单位 w 变化引起的图像大变化;让 W 更平滑。 |
| 权重解调 | 「StyleGAN2 的修法」 | 归一化卷积权重而不是激活;干掉水滴伪影。 |
| 无混叠 | 「StyleGAN3 的招数」 | 加窗 sinc 滤波器;消除纹理粘在像素网格上。 |
| 反演 | 「为一张真图找 w」 | 优化或编码 x → w,使 G(w) ≈ x。 |
生产笔记:为什么 2026 年 StyleGAN 仍在上线
StyleGAN3 在 4090 上生成一张 1024² 的 FFHQ 人脸不到 10 ms——num_steps = 1,没有 VAE 解码,没有交叉注意力趟。用生产术语讲,这是任何图像生成器的延迟下限。同分辨率下一条 50 步的 SDXL + VAE 解码流水线约 3 秒。这是 300 倍的差距,对于窄领域产品(头像服务、证件流水线、库存人脸生成)来说,它在 TCO 上胜出。
两个运营后果:
- 没有调度器,没有批处理器。 在目标占用率上跑静态批就是最优。连续批处理(对 LLM 和扩散至关重要)在这里零收益,因为每个请求 FLOPs 相同。
- 截断
ψ是那个安全旋钮。ψ < 0.7采样自映射网络值域里的一个狭窄锥。这是服务层对样本方差唯一的杠杆。高峰负载时把ψ调低,给付费用户调高。
延伸阅读
- Karras et al. (2019). A Style-Based Generator Architecture for GANs —— StyleGAN。
- Karras et al. (2020). Analyzing and Improving the Image Quality of StyleGAN —— StyleGAN2。
- Karras et al. (2021). Alias-Free Generative Adversarial Networks —— StyleGAN3。
- Tov et al. (2021). Designing an Encoder for StyleGAN Image Manipulation —— e4e 反演。
- Sauer et al. (2022). StyleGAN-XL: Scaling StyleGAN to Large Diverse Datasets —— StyleGAN-XL。
- Huang et al. (2024). R3GAN: The GAN is dead; long live the GAN! —— 现代极简 GAN 配方。