为什么需要 transformer —— RNN 的那些毛病
RNN 一次只处理一个 token,transformer 一次处理所有 token。就是这一个架构上的赌注,改写了 2017 年之后深度学习里的每一条 scaling 曲线。
类型: Learn 语言: Python 前置要求: 阶段 3(深度学习核心)、阶段 5 · 09(序列到序列)、阶段 5 · 10(注意力机制) 预计时间: ~45 分钟
问题背景
2017 年之前,地球上每一个最先进的序列模型——语言、翻译、语音——都是循环神经网络。LSTM 和 GRU 在长达五年的时间里横扫各类翻译基准(相当于翻译界的 ImageNet)。它们是大家手里唯一的工具。
它们有三个致命弱点。第一,串行计算意味着你没法沿时间轴并行:token t+1 需要 token t 的隐藏状态。一个 1024 token 的序列,就是在一块每周期能做 100 万次浮点运算的 GPU 上跑 1024 个串行步骤。在一个为并行而设计的硬件上,训练的墙钟时间却随序列长度线性增长。
第二,梯度消失意味着 50 个 token 之前的信息,已经被压过了 50 层非线性变换。门控循环单元(LSTM、GRU)缓和了这种碾压,但从未消除它。长程依赖——"我去年夏天在飞往京都的飞机上读的那本书是……"——经常就断了。
第三,固定宽度的隐藏状态意味着编码器要把整个源序列挤进一个向量里,解码器才看得到东西。源序列是 5 个 token 还是 500 个 token 都无所谓,瓶颈的形状一样大。
2017 年的论文《Attention Is All You Need》提出了一个激进的想法:彻底丢掉循环。让每个位置并行地关注其他所有位置。用一次大矩阵乘法来训练,而不是 1024 次串行运算。
结果是,到 2026 年它统治了每一种模态。语言(GPT-5、Claude 4、Llama 4)、视觉(ViT、DINOv2、SAM 3)、音频(Whisper)、生物(AlphaFold 3)、机器人(RT-2)。同一个 block,喂进不同的输入。
核心概念
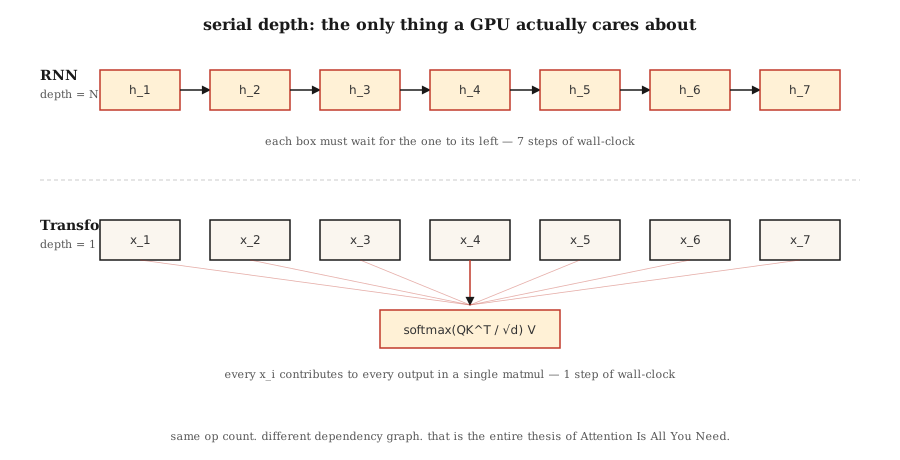
循环是个瓶颈。 RNN 计算的是 h_t = f(h_\{t-1\}, x_t)。每一步都依赖上一步。你没法在算出 h_4 之前算 h_5。在拥有上万个并行核心的现代 GPU 上,处理长序列时这会浪费掉 99% 的硅片。
注意力是一种广播。 self-attention 对每一对 (i, j) 同时计算 output_i = sum_j(a_ij * v_j)。整个 N×N 的注意力矩阵在一次批量 matmul 里就填满了。没有哪一步依赖另一步。GPU 喜欢这个。
这个加速不是一个常数倍。 它是 O(N) 串行深度和 O(1) 串行深度之间的差别。实践中,在同等硬件、N=512 的条件下,transformer 每个 epoch 训练快 5–10 倍,而且这个差距随序列长度越拉越大,直到你撞上注意力的 O(N²) 显存墙(这一点后来被 Flash Attention 解决了——见第 12 课)。
transformer 的代价。 注意力的显存按 O(N²) 增长。2K 上下文没问题。128K 上下文你就得用滑动窗口、RoPE 外推、Flash Attention 分块,或者线性注意力变体。循环在时间和显存上都是 O(N);transformer 拿时间换显存,然后又靠并行把时间赚回来。
归纳偏置的转变。 RNN 假设局部性和近期性。transformer 什么都不假设——每一对位置都是注意力的候选。这就是为什么 transformer 要更多数据才能训好,但一旦有了数据就能扩展得更远。Chinchilla(2022)把这件事形式化了:只要 token 足够多,同等参数量下 transformer 永远打得过 RNN。
rnn-vs-parallel动手构建
这里没有神经网络——我们用数值方式模拟核心瓶颈,让你在自己的笔记本上就能感受到这个差距。
第 1 步:测量串行深度
见 code/main.py。我们写两个函数。一个把序列编码成一串加法链(串行,像 RNN)。一个把它编码成并行归约(广播,像注意力)。数学一样,依赖图不同。
def rnn_style(xs):
    h = 0.0
    for x in xs:
        h = 0.9 * h + x   # 没法并行:h 依赖前一个 h
    return h

def attention_style(xs):
    return sum(xs) / len(xs)  # 每个 x 都是独立的
我们对长度最高到 100,000 的序列给两者计时。RNN 版本是 O(N),单条 CPU 流水线。即便是纯 Python,注意力风格的归约在长度 ≥ 1000 时也会赢,因为 Python 的 sum() 是用 C 实现的,每一步迭代都没有解释器开销。
第 2 步:数一数理论运算量
两个算法都做 N 次加法。区别在于依赖深度:在下一步能开始之前,必须串行发生多少次运算。RNN 深度 = N。注意力深度:树形归约是 log(N),并行扫描是 1。决定 GPU 时间的是深度,不是运算总数。
第 3 步:长序列上的实测扩展
我们打印一张计时表,把 O(N) 的差距可视化出来。在一台 2026 年的 Mac 笔记本上,1000 个元素以下的序列快到测不出来。100,000 的序列则显示出一条干净的线性扫描曲线。把这个扩展到一个 16,384 token 的 transformer 和一个等价的 12 层 LSTM,你就明白为什么 2016 年训练墙钟时间是个拦路虎了。
实际使用
2026 年什么时候还该选 RNN:
| 场景 | 选择 |
|---|---|
| 流式推理、一次一个 token、恒定显存 | RNN 或状态空间模型(Mamba、RWKV) |
| 注意力显存爆炸的超长序列(>1M token) | 线性注意力、Mamba 2、Hyena |
| 没有 matmul 加速器的边缘设备 | 深度可分离 RNN 在 FLOPs/瓦特上仍占优 |
| 其他一切(训练、批量推理、最高 128K 上下文) | Transformer |
像 Mamba 这样的状态空间模型(SSM)本质上是带结构化参数化的 RNN,这让它们兼得两边的好处:O(N) 的扫描显存、靠选择性扫描实现的并行训练。它们能恢复 transformer 90% 的质量,而长上下文扩展更好。2026 年大多数前沿实验室训练的是 SSM+transformer 混合模型(比如 Jamba、Samba)——循环没死,它成了一个组件。
拿去用
见 outputs/skill-architecture-picker.md。这个 skill 会根据长度、吞吐量和训练预算约束,为一个新的序列问题挑选架构。对于超过 10 亿 token 的训练任务,它在不说明权衡取舍的情况下,应该永远拒绝推荐纯 RNN。
练习
- 简单。 拿
code/main.py里的rnn_style,把标量隐藏状态换成一个长度 64 的隐藏状态向量。重新测量。串行开销随隐藏状态维度增长多少? - 中等。 用纯 Python 实现一个并行前缀和(Hillis-Steele 扫描)。验证它在长度 1024 上产生的数值输出和串行扫描一致。数一数深度。
- 困难。 把注意力风格的归约移植到 GPU 上的 PyTorch。把序列长度从 64 扫到 65,536,给两者计时。画出曲线并解释它的形状。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 循环(Recurrence) | "RNN 是串行的" | 步骤 t 依赖步骤 t-1 的计算,强制沿时间轴串行执行。 |
| 串行深度 | "图有多深" | 最长的依赖运算链;即便硬件无限,它也约束墙钟时间。 |
| Attention | "让 token 互相看一眼" | 加权和 sum_j a_ij v_j,其中 a_ij 来自位置 i 和 j 之间的相似度分数。 |
| 上下文窗口 | "模型能看到多少" | 一个注意力层能接收的位置数;二次方显存代价随它增长。 |
| 归纳偏置 | "烙进架构里的假设" | 关于数据长什么样的先验;CNN 假设平移不变性,RNN 假设近期性。 |
| 状态空间模型 | "背后有代数的 RNN" | 用结构化状态空间矩阵参数化、以支持并行训练的循环。 |
| 二次方瓶颈 | "为什么上下文这么贵" | 注意力显存在序列长度上是 O(N²);Flash Attention 藏的是常数项,不是这个扩展规律。 |
延伸阅读
- Vaswani et al. (2017). Attention Is All You Need —— 终结主流 NLP 中循环结构的那篇论文。
- Bahdanau, Cho, Bengio (2014). Neural MT by Jointly Learning to Align and Translate —— 注意力诞生的地方,当时还是焊在 RNN 上的。
- Hochreiter, Schmidhuber (1997). Long Short-Term Memory —— 最初的 LSTM 论文,留个底。
- Gu, Dao (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces —— 对 transformer 的现代循环回应。