从零构建一个 Transformer —— 收官项目
十三课。一个模型。不走捷径。
类型: Build 语言: Python 前置要求: 阶段 7 · 01 到 13。别跳。 预计时间: ~120 分钟
问题背景
你读完了每篇论文。你实现了注意力、多头拆分、位置编码、编码器和解码器 block、BERT 和 GPT 的损失、MoE、KV 缓存。现在让它们在一个真实任务上协同工作。
收官项目:在一个字符级语言建模任务上端到端训练一个小型纯解码器 transformer。它读莎士比亚。它生成新的莎士比亚。它小到能在笔记本上 10 分钟内训完。它正确到换上更大的数据集和更长的训练就能给你一个真正的 LM。
这是本课程的"nanoGPT"。它不原创——Karpathy 2023 年的 nanoGPT 教程是每个学生至少写一遍的参考实现。我们借用它的形态,围绕我们讲过的东西重新装配。
核心概念
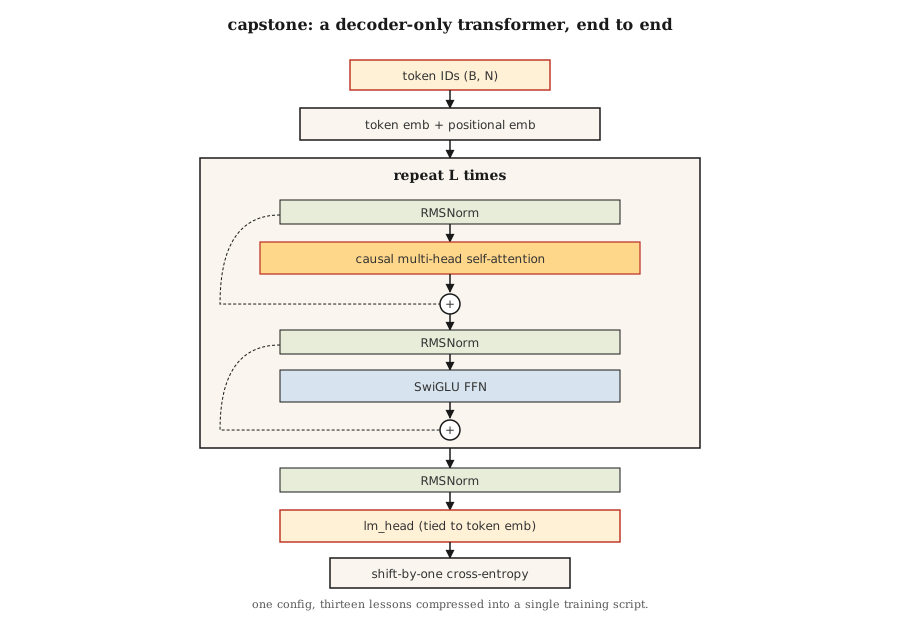
加了注解的架构:
input tokens (B, N)
   │
   ▼
token embedding + positional embedding  ◀── 第 04 课(RoPE 可选)
   │
   ▼
┌──── block × L ────────────────────┐
│  RMSNorm                          │  ◀── 第 05 课
│  MultiHeadAttention (causal)      │  ◀── 第 03 + 07 课(因果掩码)
│  residual                         │
│  RMSNorm                          │
│  SwiGLU FFN                       │  ◀── 第 05 课
│  residual                         │
└────────────────────────────────── ┘
   │
   ▼
final RMSNorm
   │
   ▼
lm_head (tied to token embedding)
   │
   ▼
logits (B, N, V)
   │
   ▼
shift-by-one cross-entropy            ◀── 第 07 课
我们交付什么
GPTConfig—— 配置所有超参数的唯一地方。MultiHeadAttention—— 因果、批量,带可选的 Flash 风格路径(PyTorch 的scaled_dot_product_attention)。SwiGLUFFN—— 现代 FFN。Block—— pre-norm、残差包裹的注意力 + FFN。GPT—— 嵌入、堆叠的 block、LM 头、generate()。- 带 AdamW、余弦 LR、梯度裁剪的训练循环。
- 莎士比亚文本上的字符级分词器。
我们不交付什么
- RoPE —— 第 04 课已在概念上实现。这里为简单起见用学习式位置嵌入。练习要求你换上 RoPE。
- 生成期的 KV 缓存 —— 每个生成步都对整个前缀重算注意力。更慢但更简单。练习要求你加上 KV 缓存。
- Flash Attention —— PyTorch 2.0+ 在输入匹配时自动派发;我们用
F.scaled_dot_product_attention。 - MoE —— 每个 block 单个 FFN。你在第 11 课见过 MoE。
目标指标
在一台 Mac M2 笔记本上,一个 4 层、4 头、d_model=128 的 GPT 在 tinyshakespeare.txt 上训 2,000 步:
- 训练损失约 6 分钟内从 ~4.2(随机)收敛到 ~1.5。
- 采样输出看着像莎士比亚的样子:古风词、换行、像 "ROMEO:" 这样的专名涌现出来。
- 验证损失(留出的最后 10% 文本)和训练损失贴得很近;在这个规模/预算下不过拟合。
n5-block-stack动手构建
这节课用 PyTorch。装 torch(CPU 版就行)。见 code/main.py。脚本负责:
- 缺失时下载
tinyshakespeare.txt(或读本地副本)。 - 字节级字符分词器。
- 90/10 训练/验证切分。
- 在支持的硬件上用 bf16 autocast 的训练循环。
- 训练完成后采样。
第 1 步:数据
text = open("tinyshakespeare.txt").read()
chars = sorted(set(text))
stoi = {c: i for i, c in enumerate(chars)}
itos = {i: c for c, i in stoi.items()}
encode = lambda s: [stoi[c] for c in s]
decode = lambda xs: "".join(itos[x] for x in xs)
65 个唯一字符。极小的词表。塞进一个 4 字节的 vocab_size。没有 BPE,没有分词器的破事。
第 2 步:模型
见 code/main.py。block 是第 05 课的教科书做法——pre-norm、RMSNorm、SwiGLU、因果 MHA。4/4/128 的参数量:~80 万。
第 3 步:训练循环
取一个长度 256 的 token 窗口的随机批次。前向。错位一格交叉熵。反向。AdamW 步。记录。重复。
for step in range(max_steps):
    x, y = get_batch("train")
    logits = model(x)
    loss = F.cross_entropy(logits.view(-1, vocab_size), y.view(-1))
    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
    opt.step()
    opt.zero_grad()
第 4 步:采样
给一个 prompt,反复前向、从 top-p logits 采样、追加、继续。500 个 token 后停。
第 5 步:读输出
2,000 步之后:
ROMEO:
Away and mild will not thy friend, that thou shalt wit:
The chief that well shame and hath been his friends,
...
不是莎士比亚。但是莎士比亚的样子。对约 80 万参数、笔记本上 6 分钟来说,这是个明确的胜利。
实际使用
这个收官项目是一个参考架构。三个扩展能把它推向真东西:
- 换分词器。 用 BPE(如
tiktoken.get_encoding("cl100k_base"))。词表大小从 65 跳到约 50,000。模型容量得相应扩大来补偿。 - 在更大的语料上训练。 用
OpenWebText或fineweb-edu(HuggingFace)。单块 A100 上,一个 125M 参数的 GPT 训 100 亿 token 约需 24 小时。 - 加 RoPE + KV 缓存 + Flash Attention。 下面的练习带你逐个走一遍。
最后这会变成一个生成流畅英语的 125M 参数 GPT。不是前沿模型。但同一条代码路径——只是更大——正是 Karpathy、EleutherAI 和 Allen Institute 在 2026 年训练研究 checkpoint 用的。
拿去用
见 outputs/skill-transformer-review.md。这个 skill 会针对前面全部 13 课的正确性审查一个从零构建的 transformer 实现。
练习
- 简单。 跑
code/main.py。验证你训好的模型最终步验证损失低于 2.0。把max_steps从 2,000 改到 5,000——验证损失还在改善吗? - 中等。 把学习式位置嵌入换成 RoPE。在
MultiHeadAttention内部对 Q 和 K 应用旋转。训练并验证验证损失至少一样低。 - 中等。 在采样循环里实现 KV 缓存。带缓存和不带缓存各生成 500 个 token。笔记本上墙钟应该改善 5–20 倍。
- 困难。 给模型加第二个头,预测再下一个 token(MTP —— 来自 DeepSeek-V3 的多 token 预测)。联合训练。有帮助吗?
- 困难。 把每个 block 的单个 FFN 换成一个 4 专家 MoE。路由器 + top-2 路由。看在同等激活参数下验证损失怎么变。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| nanoGPT | "Karpathy 的教程 repo" | 极简纯解码器 transformer 训练代码,约 300 行;规范参考。 |
| tinyshakespeare | "标准玩具语料" | 约 1.1 MB 文本;2015 年以来每个字符 LM 教程都用它。 |
| 绑定嵌入 | "共享输入/输出矩阵" | LM 头权重 = token 嵌入矩阵的转置;省参数,提质量。 |
| bf16 autocast | "训练精度把戏" | 前向/反向用 bf16 跑,优化器状态保留 fp32;2021 年起的标准。 |
| 梯度裁剪 | "压住尖峰" | 把全局梯度范数封顶在 1.0;防训练炸掉。 |
| 余弦 LR 调度 | "2020+ 默认" | LR 线性爬升(warmup)后按余弦形衰减到峰值的 10%。 |
| MFU | "Model FLOP Utilization" | 达成 FLOPs / 理论峰值;2026 年稠密 40%、MoE 30% 算强。 |
| 验证损失 | "留出损失" | 模型从没见过的数据上的交叉熵;过拟合探测器。 |
延伸阅读
- The Annotated Transformer (Harvard NLP) —— 经典的带注解实现。