评测 —— FID、CLIP 分数、人类偏好
每一个生成模型排行榜都引用 FID、CLIP 分数,以及来自人类偏好竞技场的胜率。每个数字都有一个执着的研究者能刷的失效模式。如果你不懂这些失效模式,你就分不清一次真正的提升和一次刷分的运行。
类型: Build 语言: Python 前置要求: 阶段 8 · 01(分类)、阶段 2 · 04(评测指标) 预计时间: ~45 分钟
问题背景
一个生成模型按样本质量和条件遵循度来评判。两者都没有闭式的度量。你的模型得渲染 1 万张图;得有东西给它们打上数字;你得跨模型家族、跨分辨率、跨架构地信任这些数字。三个指标熬过了 2014-2026 这场严酷考验:
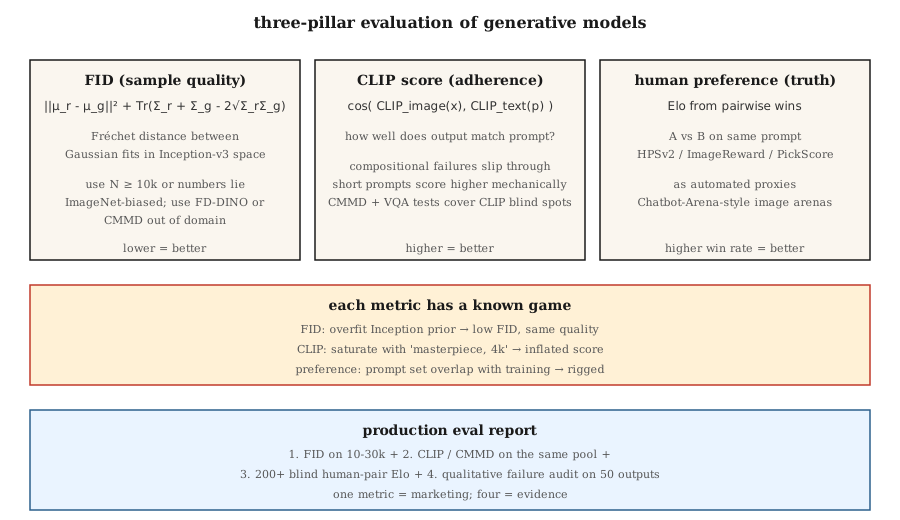
- FID(Fréchet Inception Distance)。 真实分布和生成分布在一个 Inception 网络特征空间里的距离。越低越好。
- CLIP 分数。 生成图像的 CLIP 图像嵌入和一段 prompt 的 CLIP 文本嵌入之间的余弦相似度。越高越好。衡量 prompt 遵循度。
- 人类偏好。 在同一个 prompt 上让两个模型正面对决,让人(或一个 GPT-4 级模型)挑出更好的那个,聚合成一个 Elo 分。
你还会看到:IS(inception 分数,基本退役了)、KID、CMMD、ImageReward、PickScore、HPSv2、MJHQ-30k。每个都纠正前一个的某个缺陷。
核心概念
FID —— 样本质量
Heusel et al. (2017)。步骤:
- 为 N 张真实图和 N 张生成图提取 Inception-v3 特征(2048 维)。
- 给每一池拟合一个高斯:算均值
μ_r, μ_g和协方差Σ_r, Σ_g。 - FID =
||μ_r - μ_g||² + Tr(Σ_r + Σ_g - 2 · (Σ_r · Σ_g)^0.5)。
解读:特征空间里两个多元高斯之间的 Fréchet 距离。越低 = 分布越相似。
失效模式:
- 小 N 上有偏。 FID 是在特征分布上的均方——小 N 会低估协方差,给出假性偏低的 FID。永远用 N ≥ 10,000。
- 依赖 Inception。 Inception-v3 是在 ImageNet 上训的。离 ImageNet 很远的领域(人脸、艺术、文字图像)算出来的 FID 毫无意义。用一个领域专属的特征提取器。
- 刷分。 过拟合 Inception 先验能在没有视觉质量提升的情况下拿到低 FID。用 CMMD(下文)来对付它。
CLIP 分数 —— prompt 遵循度
Radford et al. (2021)。对一张生成图 + prompt:
clip_score = cos_sim( CLIP_image(x_gen), CLIP_text(prompt) )在 3 万张生成图上取平均 → 一个模型之间可比的标量。
失效模式:
- CLIP 自身的盲区。 CLIP 的组合推理很弱(「蓝球上的红方块」常常失败)。模型可以在 CLIP 分数上排得很高,却没真正遵循复杂 prompt。
- 短 prompt 偏好。 短 prompt 在野外有更多 CLIP 图像匹配。长 prompt 机械地拿到更低的 CLIP 分数。
- prompt 刷分。 在 prompt 里塞「high quality, 4k, masterpiece」会抬高 CLIP 分数,却不改善图文绑定。
CMMD(Jayasumana et al., 2024)修了其中一些:用 CLIP 特征而非 Inception,用最大均值差异而非 Fréchet。在检测细微质量差异上更好。
人类偏好 —— 那个真值
挑一池 prompt。用模型 A 和模型 B 生成。把成对结果给人看(或一个强 LLM 裁判)。把胜负聚合成一个 Elo 或 Bradley-Terry 分。基准:
- PartiPrompts(Google):1,600 个多样 prompt,12 个类别。
- HPSv2:10.7 万条人类标注,被广泛用作自动化代理。
- ImageReward:13.7 万对 prompt-图像偏好,MIT 许可。
- PickScore:在 Pick-a-Pic 的 260 万偏好上训练。
- Chatbot-Arena 风格的图像竞技场:https://imagearena.ai/ 等。
失效模式:
- 裁判方差。 非专家和专家的偏好不同。两者都用。
- prompt 分布。 精挑细选的 prompt 偏向某个家族。永远记录在案。
- LLM 裁判的奖励黑客。 GPT-4 裁判会被「好看但错」的输出骗到。用人类来三角验证。
一起用
一份生产评测报告应该包含:
- 在 1-3 万个样本上、相对一个留出真实分布的 FID(样本质量)。
- 在同一批样本上、相对它们 prompt 的 CLIP 分数 / CMMD(遵循度)。
- 在一个盲测竞技场里相对上一个模型的胜率(整体偏好)。
- 失效模式分析:随机抽 50 个输出,按已知问题标记(手部解剖、文字渲染、物体数量一致性)。
任何单个指标都是个谎。三个互相印证的指标 + 定性审阅才是一个主张。
gx-fid-distributions动手构建
code/main.py 在合成的「特征向量」上实现 FID、类 CLIP 分数和 Elo 聚合(我们用 4 维向量代替 Inception 特征)。你看到:
- 小 N 和大 N 上的 FID 计算——那个偏差。
- 「CLIP 分数」作为特征池之间的余弦相似度。
- 来自一条合成偏好流的 Elo 更新规则。
第 1 步:四行写出 FID
def fid(real_features, gen_features):
    mu_r, cov_r = mean_and_cov(real_features)
    mu_g, cov_g = mean_and_cov(gen_features)
    mean_diff = sum((a - b) ** 2 for a, b in zip(mu_r, mu_g))
    trace_term = trace(cov_r) + trace(cov_g) - 2 * sqrt_cov_product(cov_r, cov_g)
    return mean_diff + trace_term
第 2 步:CLIP 风格的余弦相似度
def clip_like(image_feat, text_feat):
    dot = sum(a * b for a, b in zip(image_feat, text_feat))
    norm = math.sqrt(dot_self(image_feat) * dot_self(text_feat))
    return dot / max(norm, 1e-8)
第 3 步:Elo 聚合
def elo_update(r_a, r_b, winner, k=32):
    expected_a = 1 / (1 + 10 ** ((r_b - r_a) / 400))
    actual_a = 1.0 if winner == "a" else 0.0
    r_a_new = r_a + k * (actual_a - expected_a)
    r_b_new = r_b - k * (actual_a - expected_a)
    return r_a_new, r_b_new
坑
- N=1000 时的 FID。 在 N=10k 以下这个启发式不可靠。报告低 N FID 的论文在刷分。
- 跨分辨率比 FID。 Inception 的 299×299 缩放改变了特征分布。只在匹配的分辨率下比较。
- 只报一个种子。 至少跑 3 个种子。报告标准差。
- 通过负面 prompt 抬高 CLIP 分数。 有些流水线靠过拟合 prompt 来抬 CLIP。检查视觉饱和度。
- prompt 重叠造成的 Elo 偏差。 如果两个模型训练时都见过一个基准 prompt,Elo 就毫无意义。用留出的 prompt 集。
- 付费众包人评的偏斜。 Prolific、MTurk 标注者偏年轻 / 偏技术友好。和招募来的艺术/设计专家混着用。
实际使用
2026 年的生产评测流程:
| 支柱 | 最低要求 | 推荐 |
|---|---|---|
| 样本质量 | 在 1 万张上相对留出真实集的 FID | + 5 千张上的 CMMD + 每类子集上的 FID |
| prompt 遵循度 | 3 万张上的 CLIP 分数 | + HPSv2 + ImageReward + VQA 式问答 |
| 偏好 | 相对基线的 200 对盲测 | + 2000 对人评 + LLM 裁判 + Chatbot Arena |
| 失效分析 | 50 个手工标记 | 500 个手工标记 + 自动化安全分类器 |
一份报告里四个支柱齐全 = 主张。任何单独一个 = 营销。
拿去用
存为 outputs/skill-eval-report.md。技能接受一个新模型检查点 + 基线,输出一份完整评测计划:样本量、指标、失效模式探针、放行标准。
练习
- 简单。 跑
code/main.py。在同样的合成分布上比较 N=100 vs N=1000 的 FID。报告偏差量级。 - 中等。 从合成的 CLIP 风格特征实现 CMMD(公式见 Jayasumana et al., 2024)。比较它对质量差异的敏感度与 FID。
- 困难。 复现 HPSv2 的设置:从 Pick-a-Pic 的一个子集取 1000 对图像-prompt,在这些偏好上微调一个基于 CLIP 的小评分器,测量它与一个留出集的一致性。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| FID | 「Fréchet Inception Distance」 | 真实 vs 生成的 Inception 特征高斯拟合之间的 Fréchet 距离。 |
| CLIP 分数 | 「图文相似度」 | CLIP 图像和文本嵌入之间的余弦相似度。 |
| CMMD | 「FID 的替代」 | CLIP 特征的 MMD;偏差更小,无高斯假设。 |
| IS | 「Inception 分数」 | Exp KL(p(y |
| HPSv2 / ImageReward / PickScore | 「学出来的偏好代理」 | 在人类偏好上训的小模型;用作自动裁判。 |
| Elo | 「国际象棋评分」 | 成对胜负的 Bradley-Terry 聚合。 |
| PartiPrompts | 「那个基准 prompt 集」 | Google 精选的 1,600 个 prompt,跨 12 个类别。 |
| FD-DINO | 「自监督替代」 | 用 DINOv2 特征的 FD;对 ImageNet 之外的领域更好。 |
生产笔记:评测也是一种推理负载
在 1 万个样本上跑 FID 意味着生成 1 万张图。对单块 L4 上 1024² 的 50 步 SDXL base,那是约 11 小时的单请求推理。评测预算是真金白银,而这个框架恰好是离线推理场景(最大化吞吐,忽略 TTFT):
- 狠狠批处理,忘掉延迟。 离线评测 = 在内存装得下的最大尺寸上做静态批处理。在 80GB H100 上用
num_images_per_prompt=8跑pipe(...).images的墙钟比单请求快 4-6 倍。 - 缓存真实特征。 在真实参考集上的 Inception(FID)或 CLIP(CLIP 分数、CMMD)特征提取只跑一次,存成一个
.npz。别每次评测都重算。
CI / 回归门禁:每个 PR 在 500 样本子集上跑 FID + CLIP 分数(约 30 分钟);每晚跑完整的 1 万 FID + HPSv2 + Elo。
延伸阅读
- Heusel et al. (2017). GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium (FID) —— FID 那篇论文。
- Jayasumana et al. (2024). Rethinking FID: Towards a Better Evaluation Metric for Image Generation (CMMD) —— CMMD。
- Radford et al. (2021). Learning Transferable Visual Models from Natural Language Supervision (CLIP) —— CLIP。
- Wu et al. (2023). HPSv2: A Comprehensive Human Preference Score —— HPSv2。
- Xu et al. (2023). ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation —— ImageReward。
- Yu et al. (2023). Scaling Autoregressive Models for Content-Rich Text-to-Image Generation (Parti + PartiPrompts) —— PartiPrompts。
- Stein et al. (2023). Exposing flaws of generative model evaluation metrics —— 失效模式综述。