BERT —— 掩码语言建模
GPT 预测下一个词。BERT 预测缺失的词。一句话的差别——撑起了之后五年里所有和 embedding 沾边的东西。
类型: Build 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 5 · 02(文本表示) 预计时间: ~45 分钟
问题背景
2018 年,每个 NLP 任务——情感、NER、问答、蕴含——都在自己的标注数据上从零训练自己的模型。没有一个预训练好的"懂英语"的 checkpoint 供你微调。ELMo(2018)证明你可以用双向 LSTM 预训练上下文嵌入;它有帮助,但没法泛化。
BERT(Devlin et al. 2018)问了一个问题:如果我们拿一个 transformer 编码器,在互联网上每个句子上训练它,逼它根据两侧的上下文预测缺失的词,会怎样?然后你在下游任务上微调一个头。参数效率是一次启示。
结果是:18 个月内,BERT 及其变体(RoBERTa、ALBERT、ELECTRA)横扫了当时存在的每一个 NLP 排行榜。到 2020 年,地球上每个搜索引擎、内容审核流水线、语义搜索系统里都装着一个 BERT。
2026 年,纯编码器模型仍然是分类、检索和结构化抽取的正确工具——它们每 token 跑得比解码器快 5–10 倍,而且它们的嵌入是每个现代检索栈的脊梁。ModernBERT(2024 年 12 月)用 Flash Attention + RoPE + GeGLU 把这个架构推到了 8K 上下文。
核心概念
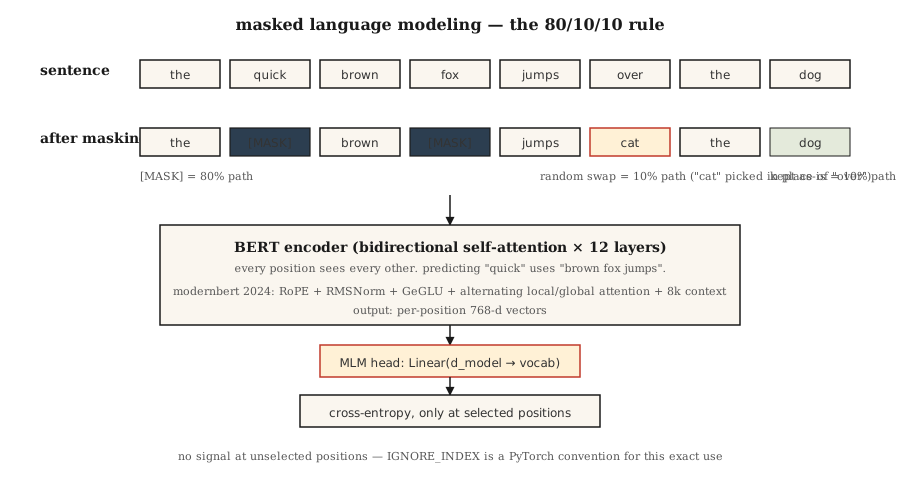
训练信号
取一个句子:the quick brown fox jumps over the lazy dog。
随机掩掉 15% 的 token:
input:  the [MASK] brown fox jumps [MASK] the lazy dog
target: the  quick brown fox jumps  over  the lazy dog
训练模型在被掩位置预测原始 token。因为编码器是双向的,预测位置 1 的 [MASK] 可以用上位置 2 及之后的 brown fox jumps。这正是 GPT 做不到的事。
BERT 的掩码规则
在被选中预测的那 15% token 里:
- 80% 被换成
[MASK]。 - 10% 被换成一个随机 token。
- 10% 保持不变。
为什么不总是 [MASK]?因为 [MASK] 在推理时从不出现。训练模型在 100% 的被掩位置都期待 [MASK],会在预训练和微调之间制造分布偏移。10% 随机 + 10% 不变让模型保持诚实。
Next Sentence Prediction(NSP)——以及它为什么被砍了
最初的 BERT 还训练了 NSP:给两个句子 A 和 B,预测 B 是否跟在 A 后面。RoBERTa(2019)把它消融了,证明 NSP 帮倒忙,不是帮忙。现代编码器跳过它。
2026 年变了什么:ModernBERT
2024 年的 ModernBERT 论文用 2026 年的原语重建了这个 block:
| 组件 | 原始 BERT(2018) | ModernBERT(2024) |
|---|---|---|
| 位置 | 学习式绝对位置 | RoPE |
| 激活 | GELU | GeGLU |
| 归一化 | LayerNorm | Pre-norm RMSNorm |
| 注意力 | 完整稠密 | 交替的局部(128)+ 全局 |
| 上下文长度 | 512 | 8192 |
| 分词器 | WordPiece | BPE |
而且不像 2018 年的栈,它是 Flash-Attention 原生的。在序列长度 8K 时,推理比 DeBERTa-v3 快 2–3 倍,GLUE 分数还更高。
2026 年仍然选编码器的用例
| 任务 | 为什么编码器胜过解码器 |
|---|---|
| 检索 / 语义搜索嵌入 | 双向上下文 = 每 token 更好的嵌入质量 |
| 分类(情感、意图、毒性) | 一次前向;无生成开销 |
| NER / token 标注 | 逐位置输出,原生双向 |
| 零样本蕴含(NLI) | 编码器之上加分类头 |
| RAG 的重排器 | 交叉编码器打分,比 LLM 重排器快 10 倍 |
transformer-residual动手构建
第 1 步:掩码逻辑
见 code/main.py。函数 create_mlm_batch 接收一个 token ID 列表、词表大小和掩码概率。返回输入 ID(已应用掩码)和标签(只在被掩位置,其余处为 -100——PyTorch 的 ignore index 约定)。
def create_mlm_batch(tokens, vocab_size, mask_prob=0.15, rng=None):
    input_ids = list(tokens)
    labels = [-100] * len(tokens)
    for i, t in enumerate(tokens):
        if rng.random() < mask_prob:
            labels[i] = t
            r = rng.random()
            if r < 0.8:
                input_ids[i] = MASK_ID
            elif r < 0.9:
                input_ids[i] = rng.randrange(vocab_size)
            # else: 保持原样
    return input_ids, labels
第 2 步:在一个微型语料上跑 MLM 预测
在一个 20 个词的词表、200 个句子上训练一个 2 层编码器 + MLM 头。不算梯度——我们做前向通过的健全性检查。完整训练需要 PyTorch。
第 3 步:对比掩码类型
展示三分规则如何让模型在没有 [MASK] 的情况下仍然可用。在一个未掩的句子和一个被掩的句子上预测。两者都应产生合理的 token 分布,因为模型在训练时见过这两种模式。
第 4 步:微调头
在一个玩具情感数据集上,把 MLM 头换成分类头。只有头在训练;编码器冻结。这是每个 BERT 应用遵循的范式。
实际使用
from transformers import AutoModel, AutoTokenizer

tok = AutoTokenizer.from_pretrained("answerdotai/ModernBERT-base")
model = AutoModel.from_pretrained("answerdotai/ModernBERT-base")

text = "Attention is all you need."
inputs = tok(text, return_tensors="pt")
out = model(**inputs).last_hidden_state   # (1, N, 768)
嵌入模型就是微调过的 BERT。 像 all-MiniLM-L6-v2 这样的 sentence-transformers 模型是用对比损失训练的 BERT。编码器一样,变的是损失。
交叉编码器重排器也是微调过的 BERT。 在 [CLS] query [SEP] doc [SEP] 上做配对分类。query 和 doc 之间的双向注意力,正是交叉编码器相比双编码器质量更高的来源。
2026 年什么时候别选 BERT。 任何生成式任务。编码器没有合理的方式自回归地产出 token。还有:任何 1B 参数以下、用一个小解码器就能以更高灵活性匹配质量的场景(Phi-3-Mini、Qwen2-1.5B)。
拿去用
见 outputs/skill-bert-finetuner.md。这个 skill 为一个新的分类或抽取任务规划一次 BERT 微调(骨干选择、头规格、数据、评测、停止条件)。
练习
- 简单。 跑
code/main.py,打印 10,000 个 token 上的掩码分布。确认约 15% 被选中,其中约 80% 变成[MASK]。 - 中等。 实现整词掩码:如果一个词被分成多个子词,要么把所有子词一起掩掉,要么都不掩。在一个 500 句的语料上测一测这是否提升 MLM 准确率。
- 困难。 在一个公开数据集的 10,000 个句子上训练一个极小(2 层,d=64)的 BERT。为 SST-2 情感微调
[CLS]token。在同等参数下和一个纯解码器基线对比——谁赢?
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| MLM | "掩码语言建模" | 训练信号:随机把 15% 的 token 换成 [MASK],预测原词。 |
| 双向 | "两边都看" | 编码器注意力没有因果掩码——每个位置都看到其他每个位置。 |
[CLS] | "池化 token" | 加在每个序列前的特殊 token;它的最终嵌入用作句子级表示。 |
[SEP] | "段分隔符" | 分隔配对序列(如 query/doc、句子 A/B)。 |
| NSP | "下一句预测" | BERT 的第二个预训练任务;RoBERTa 证明它没用,2019 年后被砍。 |
| 微调 | "适配到任务" | 编码器大体冻结;在上面训一个小头做下游任务。 |
| 交叉编码器 | "一个重排器" | 把 query 和 doc 都作为输入、输出相关性分数的 BERT。 |
| ModernBERT | "2024 年翻新" | 用 RoPE、RMSNorm、GeGLU、交替的局部/全局注意力、8K 上下文重建的编码器。 |
延伸阅读
- Devlin et al. (2018). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding —— 原始论文。
- Liu et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach —— 怎么把 BERT 训对;干掉了 NSP。
- Clark et al. (2020). ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators —— 在同等算力下,替换 token 检测胜过 MLM。
- Warner et al. (2024). Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder —— ModernBERT 论文。
- HuggingFace
modeling_bert.py—— 规范的编码器参考。