T5、BART —— 编码器-解码器模型
编码器负责理解。解码器负责生成。把它们拼回去,你就得到一个为输入 → 输出任务而生的模型:翻译、摘要、改写、转录。
类型: Learn 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 7 · 06(BERT)、阶段 7 · 07(GPT) 预计时间: ~45 分钟
问题背景
纯解码器 GPT 和纯编码器 BERT 各自为不同目标精简了 2017 年的架构。但许多任务天然就是输入-输出的:
- 翻译:英语 → 法语。
- 摘要:5,000 token 的文章 → 200 token 的摘要。
- 语音识别:音频 token → 文本 token。
- 结构化抽取:散文 → JSON。
对这些,编码器-解码器是最干净的契合。编码器产出源的稠密表示。解码器生成输出,每一步都对那个表示做 cross-attention。训练在输出端是错位一格。和 GPT 一样的损失,只是以编码器输出为条件。
两篇论文定义了现代的打法:
- T5(Raffel et al. 2019)。"Text-to-Text Transfer Transformer"。每个 NLP 任务都重构成文本进、文本出。单一架构、单一词表、单一损失。在掩码 span 预测上预训练(破坏输入里的 span,在输出里解出来)。
- BART(Lewis et al. 2019)。"Bidirectional and Auto-Regressive Transformer"。去噪自编码器:以多种方式破坏输入(打乱、掩码、删除、旋转),让解码器重建原文。
2026 年,编码器-解码器格式在输入结构重要的地方延续着:
- Whisper(语音 → 文本)。
- 谷歌的翻译栈。
- 一些有鲜明的上下文-编辑结构的代码补全/修复模型。
- 用于结构化推理任务的 Flan-T5 及变体。
纯解码器抢走了聚光灯,但编码器-解码器从未消失。
核心概念
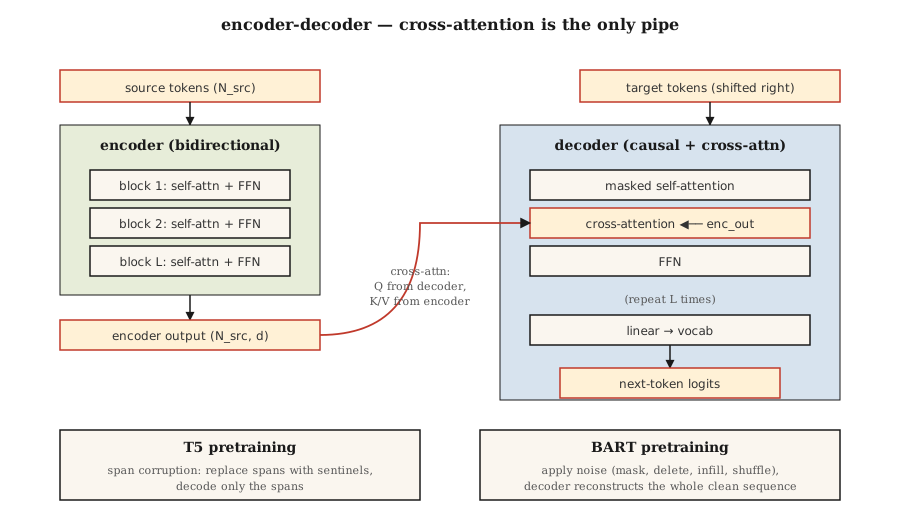
前向循环
source tokens ─▶ encoder ─▶ (N_src, d_model)  ──┐
                                                 │
target tokens ─▶ decoder block                   │
                 ├─▶ masked self-attention       │
                 ├─▶ cross-attention ◀───────────┘
                 └─▶ FFN
                ↓
next-token logits关键在于,编码器每个输入只跑一次。解码器自回归地跑,但每一步都对同一个编码器输出做 cross-attention。缓存编码器输出对长输入是免费的加速。
T5 预训练 —— span 破坏
挑输入的随机 span(平均长度 3 个 token,总共 15%)。把每个 span 换成一个唯一的哨兵:<extra_id_0>、<extra_id_1> 等等。解码器只输出被破坏的 span 及其哨兵前缀:
source: The quick <extra_id_0> fox jumps <extra_id_1> dog
target: <extra_id_0> brown <extra_id_1> over the lazy
比预测整个序列更便宜的信号。在 T5 论文的消融里,它和 MLM(BERT)、prefix-LM(UniLM)不相上下。
BART 预训练 —— 多重噪声去噪
BART 尝试五种加噪函数:
- token 掩码。
- token 删除。
- 文本填充(掩掉一个 span,解码器插入正确的长度)。
- 句子排列。
- 文档旋转。
组合文本填充 + 句子排列产生了最好的下游数字。解码器始终重建原文。BART 的输出是完整序列,不只是被破坏的 span——所以预训练算力比 T5 高。
推理
和 GPT 一样的自回归生成。贪心 / beam / top-p 采样都适用。beam search(宽度 4–5)对翻译和摘要是标准做法,因为输出分布比聊天更窄。
2026 年什么时候选哪个变体
| 任务 | 编码器-解码器? | 为什么 |
|---|---|---|
| 翻译 | 通常是 | 源序列清晰;输出分布固定;beam search 有效 |
| 语音转文本 | 是(Whisper) | 输入模态不同于输出;编码器塑造音频特征 |
| 聊天 / 推理 | 否,纯解码器 | 没有持久的"输入"——对话本身就是序列 |
| 代码补全 | 通常否 | 长上下文的纯解码器赢;像 Qwen 2.5 Coder 这样的代码模型是纯解码器 |
| 摘要 | 都行 | BART、PEGASUS 打败更早的纯解码器基线;现代纯解码器 LLM 与之持平 |
| 结构化抽取 | 都行 | T5 很干净,因为"文本 → 文本"能吸收任何输出格式 |
约 2022 年以来的趋势:纯解码器接管了过去属于编码器-解码器的任务,因为 (a) 指令微调的纯解码器 LLM 靠 prompting 就能泛化到任何东西,(b) 一个架构比两个更易扩展,(c) RLHF 假设有个解码器。编码器-解码器守住了输入模态不同(语音、图像)或 beam search 质量重要的地方。
encoder-decoder动手构建
见 code/main.py。我们为一个玩具语料实现 T5 风格的 span 破坏——这是本课最有用的一块,因为它出现在此后每个编码器-解码器预训练配方里。
第 1 步:span 破坏
def corrupt_spans(tokens, mask_rate=0.15, mean_span=3.0, rng=None):
    """挑出加起来约占 mask_rate 比例的 span。返回 (corrupted_input, target)。"""
    n = len(tokens)
    n_mask = max(1, int(n * mask_rate))
    n_spans = max(1, int(round(n_mask / mean_span)))
    ...
目标格式是 T5 约定:<sent0> span0 <sent1> span1 ...。被破坏的输入在 span 位置把未改动的 token 和哨兵 token 交织起来。
第 2 步:验证往返
给定被破坏的输入和目标,重建原句。如果你的破坏是可逆的,前向通过就是良定义的。这是一次健全性检查——真实训练从不这么做,但这个测试很便宜,能抓住你 span 记账里的差一错误。
第 3 步:BART 加噪
五个函数:token_mask、token_delete、text_infill、sentence_permute、document_rotate。组合其中两个并展示结果。
实际使用
HuggingFace 参考:
from transformers import T5ForConditionalGeneration, T5Tokenizer
tok = T5Tokenizer.from_pretrained("google/flan-t5-base")
model = T5ForConditionalGeneration.from_pretrained("google/flan-t5-base")

inputs = tok("translate English to French: Attention is all you need.", return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=32)
print(tok.decode(out[0], skip_special_tokens=True))
T5 的把戏:任务名写进输入文本里。同一个模型搞定几十种任务,因为每个任务都是文本进、文本出。2026 年这个模式被指令微调的纯解码器模型推广了,但 T5 最先把它编成了定式。
拿去用
见 outputs/skill-seq2seq-picker.md。这个 skill 会根据输入-输出结构、延迟和质量目标,在编码器-解码器和纯解码器之间为一个新任务做选择。
练习
- 简单。 跑
code/main.py,对一个 30 token 的句子应用 span 破坏,验证把非哨兵的源 token 和解出的目标 span 拼接起来能还原原句。 - 中等。 实现 BART 的
text_infill噪声:用单个<mask>token 替换随机 span,解码器必须推断出正确的 span 长度加内容。展示一个例子。 - 困难。 在一个微型英语 → pig-Latin 语料(200 对)上微调
flan-t5-small。在留出的 50 对集合上测 BLEU。和用同样数据、同样算力微调Llama-3.2-1B做对比。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 编码器-解码器 | "seq2seq transformer" | 两个栈:处理输入的双向编码器,带 cross-attention、处理输出的因果解码器。 |
| Cross-attention | "源和目标对话的地方" | 解码器的 Q × 编码器的 K/V。编码器信息进入解码器的唯一地方。 |
| span 破坏 | "T5 的预训练把戏" | 用哨兵 token 替换随机 span;解码器输出这些 span。 |
| 去噪目标 | "BART 的玩法" | 对输入施加一个噪声函数,训练解码器重建干净序列。 |
| 哨兵 token | "<extra_id_N> 占位符" | 在源里标记被破坏 span、并在目标里重新标记它们的特殊 token。 |
| Flan | "指令微调的 T5" | 在 >1,800 个任务上微调的 T5;让编码器-解码器在指令跟随上有了竞争力。 |
| Beam search | "解码策略" | 每步保留 top-k 个部分序列;翻译/摘要的标准做法。 |
| Teacher forcing | "训练期输入" | 训练期间给解码器喂真实的前一个输出 token,不是采样出来的那个。 |
延伸阅读
- Raffel et al. (2019). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer —— T5。
- Lewis et al. (2019). BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension —— BART。
- Chung et al. (2022). Scaling Instruction-Finetuned Language Models —— Flan-T5。
- Radford et al. (2022). Robust Speech Recognition via Large-Scale Weak Supervision —— Whisper,2026 年规范的编码器-解码器。
- HuggingFace
modeling_t5.py—— 参考实现。