Positional Encoding —— Sinusoidal、RoPE、ALiBi
注意力对排列不敏感。没有位置信号时,"The cat sat on the mat"和"mat the on sat cat the"产生相同的输出。三种算法来修这个问题——每种对"位置"的含义下了不同的赌注。
类型: Build 语言: Python 前置要求: 阶段 7 · 02(Self-Attention)、阶段 7 · 03(Multi-Head Attention) 预计时间: ~45 分钟
问题背景
缩放点积注意力对顺序是盲的。注意力矩阵 softmax(Q K^T / √d) V 是从两两相似度算出来的。把 X 的行打乱,输出的行就以同样方式打乱。注意力内部没有任何东西在乎位置。
在词袋模型里这不是 bug。但对语言、代码、音频、视频——任何顺序承载意义的东西——它是致命的。
修法是想办法把位置注入嵌入。三个时代的答案:
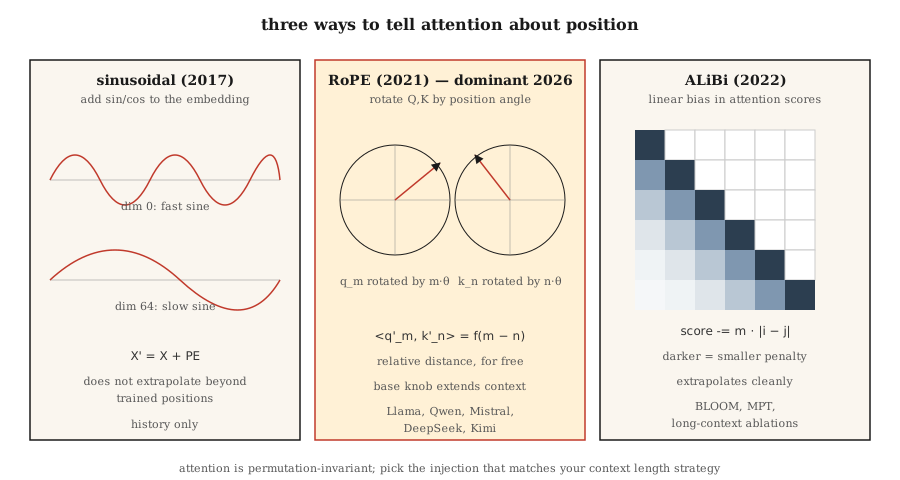
- 绝对正弦(absolute sinusoidal)(Vaswani 2017)。把位置的
sin/cos加到嵌入上。简单、无需学习参数、超出训练长度后外推很差。 - RoPE —— 旋转位置嵌入(Rotary Position Embeddings)(Su 2021)。按与位置成比例的角度旋转 Q 和 K 向量。直接在点积里编码相对位置。2026 年的主流。
- ALiBi —— 带线性偏置的注意力(Attention with Linear Biases)(Press 2022)。完全跳过嵌入;根据距离给注意力分数加一个每头的线性惩罚。长度外推极佳。
到 2026 年,基本上每个前沿开源模型都用 RoPE:Llama 2/3/4、Qwen 2/3、Mistral、Mixtral、DeepSeek-V3、Kimi。少数长上下文模型用 ALiBi 或其现代变体。绝对正弦已成历史。
核心概念
绝对正弦
预计算一个形状为 (max_len, d_model) 的固定矩阵 PE:
PE[pos, 2i]   = sin(pos / 10000^(2i / d_model))
PE[pos, 2i+1] = cos(pos / 10000^(2i / d_model))
然后在注意力之前 X' = X + PE[:N]。每个维度是一个不同频率的正弦波。模型学着从相位模式里读出位置。超过 max_len 就失败:模型只见过位置 0–2047,没人告诉它位置 2048 发生什么。
RoPE
旋转 Q 和 K 向量(不是嵌入)。对一对维度 (2i, 2i+1):
[q'_2i    ]   [ cos(pos·θ_i)  -sin(pos·θ_i) ] [q_2i   ]
[q'_2i+1  ] = [ sin(pos·θ_i)   cos(pos·θ_i) ] [q_2i+1 ]

θ_i = base^(-2i / d_head),  base = 10000 by default
对 key 在位置 pos_k 上应用同样的旋转。点积 q'_m · k'_n 就变成只关于 (m - n) 的函数。也就是说:注意力分数只取决于相对距离,尽管旋转是按绝对位置定的。漂亮的把戏。
扩展 RoPE:base 可以被缩放(NTK-aware、YaRN、LongRoPE),在不重训的情况下外推到更长的上下文。Llama 3 就这样把上下文从 8K 扩到了 128K。
ALiBi
跳过嵌入这个把戏。直接给注意力分数加偏置:
attn_score[i, j] = (q_i · k_j) / √d - m_h · |i - j|其中 m_h 是一个每头的斜率(如 1 / 2^(8·h/H))。近的 token 被抬高;远的 token 被惩罚。无训练期成本。论文显示其长度外推胜过正弦,在原训练长度上与 RoPE 持平。
2026 年怎么选
| 变体 | 外推 | 训练成本 | 谁在用 |
|---|---|---|---|
| 绝对正弦 | 差 | 免费 | 最初的 transformer、早期 BERT |
| 学习式绝对 | 无 | 极小 | GPT-2、GPT-3 |
| RoPE | 配缩放后良好 | 免费 | Llama 2/3/4、Qwen 2/3、Mistral、DeepSeek-V3、Kimi |
| RoPE + YaRN | 极佳 | 微调阶段 | Qwen2-1M、Llama 3.1 128K |
| ALiBi | 极佳 | 免费 | BLOOM、MPT、Baichuan |
RoPE 胜出,因为它能插进注意力而不改架构、编码相对位置,而且它的 base 超参给了长上下文微调一个干净的旋钮。
rope-explorer动手构建
第 1 步:正弦编码
见 code/main.py。一段 4 行的计算:
def sinusoidal(N, d):
    pe = [[0.0] * d for _ in range(N)]
    for pos in range(N):
        for i in range(d // 2):
            theta = pos / (10000 ** (2 * i / d))
            pe[pos][2 * i]     = math.sin(theta)
            pe[pos][2 * i + 1] = math.cos(theta)
    return pe
在第一个注意力层之前把它加到嵌入矩阵上。
第 2 步:把 RoPE 应用到 Q、K
RoPE 在 Q 和 K 上原地操作。对每一对维度:
def apply_rope(x, pos, base=10000):
    d = len(x)
    out = list(x)
    for i in range(d // 2):
        theta = pos / (base ** (2 * i / d))
        c, s = math.cos(theta), math.sin(theta)
        a, b = x[2 * i], x[2 * i + 1]
        out[2 * i]     = a * c - b * s
        out[2 * i + 1] = a * s + b * c
    return out
关键:对位置 m 的 Q 和位置 n 的 K 应用同一个函数。它们的点积在每个坐标对上都带出一个 cos((m-n)·θ_i) 因子。注意力免费学到相对位置。
第 3 步:ALiBi 斜率和偏置
def alibi_bias(n_heads, seq_len):
    # slope_h = 2 ** (-8 * h / n_heads), h = 1..n_heads
    slopes = [2 ** (-8 * (h + 1) / n_heads) for h in range(n_heads)]
    bias = []
    for m in slopes:
        row = [[-m * abs(i - j) for j in range(seq_len)] for i in range(seq_len)]
        bias.append(row)
    return bias  # 在 softmax 之前加到注意力分数上
把 bias[h] 加到头 h 的 (seq_len, seq_len) 注意力分数矩阵上,然后 softmax。
第 4 步:验证 RoPE 的相对距离性质
挑两个随机向量 a, b。按 (pos_a, pos_b) 旋转。再按 (pos_a + k, pos_b + k) 旋转。两个点积必须在浮点误差内一致。这个性质就是 RoPE 的全部意义——它对绝对偏移不变,只有相对差距才重要。
实际使用
PyTorch 2.5+ 在 torch.nn.functional 里自带 RoPE 工具。大多数生产代码用 flash_attn 或 xformers,RoPE 在注意力 kernel 内部应用。
from transformers import AutoModel
model = AutoModel.from_pretrained("meta-llama/Llama-3.2-3B")
# model.config.rope_scaling → {"type": "yarn", "factor": 32.0, "original_max_position_embeddings": 8192}
2026 年的长上下文招数:
- NTK-aware 插值。 从 4K 扩到 16K+ 时,把
base重新缩放到base * (scale_factor)^(d/(d-2))。 - YaRN。 更聪明的插值,在长上下文上保住注意力熵。Llama 3.1 128K 用它。
- LongRoPE。 微软 2024 年的方法,用进化搜索来挑每个维度的缩放因子。Phi-3-Long 用它。
- 位置插值 + 微调。 直接把位置按扩展因子缩小,再微调 1–5B token。意外地有效。
拿去用
见 outputs/skill-positional-encoding-picker.md。这个 skill 会根据目标上下文长度、外推需求和训练预算,为一个新模型挑选编码策略。
练习
- 简单。 对
max_len=512, d=128把正弦PE矩阵画成热力图。确认"维度索引越大、条纹越宽"的模式。 - 中等。 实现 NTK-aware RoPE 缩放。在长度 256 的序列上训练一个极小的 LM,然后分别在带缩放和不带缩放的情况下测长度 1024。测困惑度。
- 困难。 在同一个注意力模块里实现 ALiBi 和 RoPE。在长度 512 的序列的复制任务上训练一个 4 层 transformer。测试时外推到 2048。对比退化程度。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 位置编码 | "告诉注意力顺序" | 任何加到嵌入或注意力上、编码位置的信号。 |
| Sinusoidal | "最初那个" | 几何频率的 sin/cos 加到嵌入上;不外推。 |
| RoPE | "旋转嵌入" | 按位置相关的角度旋转 Q、K;点积编码相对距离。 |
| ALiBi | "线性偏置把戏" | 给注意力分数加 `-m· |
| base | "RoPE 的旋钮" | RoPE 里的频率缩放器;调大可在推理时扩展上下文。 |
| NTK-aware | "一种 RoPE 缩放招数" | 重缩放 base,让高频维度在上下文扩展时不被挤压。 |
| YaRN | "高级那个" | 每个维度的插值+外推,保住注意力熵。 |
| 外推(Extrapolation) | "超出训练长度也能用" | 位置方案能否在超过训练所见 max_len 的位置上给出正确输出? |
延伸阅读
- Vaswani et al. (2017). Attention Is All You Need §3.5 —— 最初的正弦编码。
- Su et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding —— RoPE 论文。
- Press, Smith, Lewis (2021). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation —— ALiBi。
- Peng et al. (2023). YaRN: Efficient Context Window Extension of Large Language Models —— 最先进的 RoPE 缩放。
- Chen et al. (2023). Extending Context Window of Large Language Models via Positional Interpolation —— Meta 的 Llama 2 长上下文论文。
- Ding et al. (2024). LongRoPE: Extending LLM Context Window Beyond 2 Million Tokens —— Phi-3-Long 用的、上面"上手使用"一节引用的微软方法。
- HuggingFace Transformers —
modeling_rope_utils.py—— 每种 RoPE 缩放方案的生产级实现(default、linear、dynamic、YaRN、LongRoPE、Llama-3)。