神经音频编解码 —— EnCodec、SNAC、Mimi、DAC,以及语义-声学的切分
2026 年的音频生成几乎全靠 token。EnCodec、SNAC、Mimi 和 DAC 把连续波形变成 transformer 能预测的离散序列。语义-声学 token 的切分——第一个码本当语义、其余当声学——是自 Transformer 以来音频领域最重要的架构转变。
类型: Learn 语言: Python 前置要求: 阶段 6 · 02(频谱图)、阶段 10 · 11(量化)、阶段 5 · 19(子词分词) 预计时间: ~60 分钟
问题背景
语言模型在离散 token 上工作。音频是连续的。如果你想要一个语音 / 音乐的 LLM 式模型——MusicGen、Moshi、Sesame CSM、VibeVoice、Orpheus——你首先需要一个神经音频编解码:一个学习得到的编码器把音频离散成一个小词表的 token,再配一个解码器重建波形。
冒出来两个流派:
- 重建优先的编解码——EnCodec、DAC。优化感知音频质量。token 是「声学」的——它们捕获一切,包括说话人身份、音色、背景噪声。
- 语义优先的编解码——Mimi(Kyutai)、SpeechTokenizer。强迫第一个码本编码语言 / 音素内容(常通过从 WavLM 蒸馏)。后续码本是声学细节。
2024-2026 年的洞见:纯重建编解码在你试图从文本生成时会给你糊掉的语音。 编解码 token 上的 LLM 得在同一个码本里同时学习语言结构和声学结构,这扩展不动。把它们分开——语义码本 0、声学码本 1-N——这才是 Moshi 和 Sesame CSM 能跑起来的原因。
核心概念
核心技巧:残差向量量化(RVQ)
不用一个大码本(要好质量得上百万个码),所有现代音频编解码都用 RVQ:一串小码本的级联。第一个码本量化编码器输出;第二个量化残差;以此类推。每个码本 1024 个码。8 个码本 = 有效词表 1024^8 = 10^24。
推理时,解码器把每帧选中的所有码加起来重建。
2026 年要紧的四个编解码
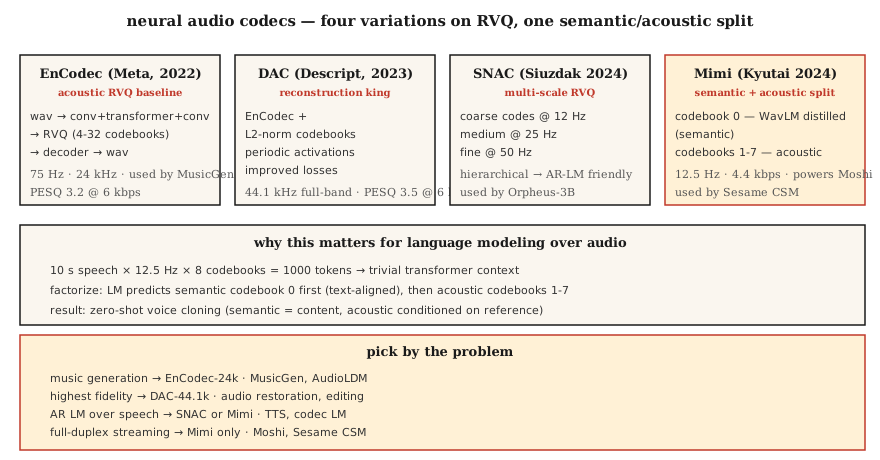
EnCodec(Meta,2022)。 基线。波形上的编码器-解码器,RVQ 瓶颈。24 kHz,最多 32 个码本,默认 4 个码本 @ 1.5 kbps。用 1D conv + transformer + 1D conv 架构。MusicGen 用的就是它。
DAC(Descript,2023)。 带 L2 归一化码本、周期激活函数、改进损失的 RVQ。任何开源编解码里重建保真度最高的——12 个码本时有时和原始语音分不出来。44.1 kHz 全频带。
SNAC(Hubert Siuzdak,2024)。 多尺度 RVQ——粗码本以比细码本更低的帧率工作。实际上对音频做分层建模:约 12 Hz 的粗「草图」加 50 Hz 的细节。Orpheus-3B 用它,因为这种分层结构很好地映射到基于 LM 的生成上。
Mimi(Kyutai,2024)。 2026 年的游戏规则改变者。12.5 Hz 帧率(极低),8 个码本 @ 4.4 kbps。码本 0 是从 WavLM 蒸馏来的——训练它去预测 WavLM 的语音内容特征。码本 1-7 是声学残差。这个切分驱动了 Moshi(第 15 课)和 Sesame CSM。
帧率对语言建模很重要
帧率越低 = 序列越短 = LM 越快。
| 编解码 | 帧率 | 1 s = N 帧 | 适合 |
|---|---|---|---|
| EnCodec-24k | 75 Hz | 75 | 音乐、通用音频 |
| DAC-44.1k | 86 Hz | 86 | 高保真音乐 |
| SNAC-24k(粗) | ~12 Hz | 12 | AR-LM 高效 |
| Mimi | 12.5 Hz | 12.5 | 流式语音 |
12.5 Hz 下,一段 10 秒语音只有 125 个编解码帧——transformer 轻松就能预测它们。
语义 token vs 声学 token
frame_t → [semantic_token_t, acoustic_token_0_t, acoustic_token_1_t, ..., acoustic_token_6_t]- 语义 token(Mimi 里的码本 0)。 编码说了什么——音素、词、内容。通过辅助预测损失从 WavLM 蒸馏而来。
- 声学 token(码本 1-7)。 编码音色、说话人身份、韵律、背景噪声、细节。
一个 AR LM 先预测语义 token(以文本为条件),再预测声学 token(以语义 + 说话人参考为条件)。这种因子分解正是现代 TTS 能零样本克隆声音的原因:语义模型管内容;声学模型管音色。
2026 年重建质量(比特每秒,码率越低越好)
| 编解码 | 码率 | PESQ | ViSQOL |
|---|---|---|---|
| Opus-20kbps | 20 kbps | 4.0 | 4.3 |
| EnCodec-6kbps | 6 kbps | 3.2 | 3.8 |
| DAC-6kbps | 6 kbps | 3.5 | 4.0 |
| SNAC-3kbps | 3 kbps | 3.3 | 3.8 |
| Mimi-4.4kbps | 4.4 kbps | 3.1 | 3.7 |
像 Opus 这样的传统编解码在每比特感知质量上仍然胜出。神经编解码胜在离散 token(Opus 不产出这个)和生成模型质量(LM 拿这些 token 能干什么)。
rvq-codec-cascade动手构建
第 1 步:用 EnCodec 编码
from encodec import EncodecModel
import torch

model = EncodecModel.encodec_model_24khz()
model.set_target_bandwidth(6.0)  # kbps

wav = torch.randn(1, 1, 24000)
with torch.no_grad():
    encoded = model.encode(wav)
codes, scale = encoded[0]
# codes: (1, n_codebooks, n_frames), dtype=int64
6 kbps 下 n_codebooks=8。每个码是 0-1023(10 比特)。
第 2 步:解码并测量重建
with torch.no_grad():
    wav_recon = model.decode([(codes, scale)])

from torchaudio.functional import compute_deltas
import torch.nn.functional as F

mse = F.mse_loss(wav_recon[:, :, :wav.shape[-1]], wav).item()
第 3 步:语义-声学切分(Mimi 风格)
from moshi.models import loaders
mimi = loaders.get_mimi()

with torch.no_grad():
    codes = mimi.encode(wav)  # shape (1, 8, frames@12.5Hz)

semantic = codes[:, 0]
acoustic = codes[:, 1:]
语义码本 0 是和 WavLM 对齐的。你可以训练一个文本到语义的 transformer——词表比直接到音频小得多。然后一个单独的声学到波形解码器以说话人参考为条件。
第 4 步:为什么编解码 token 上的 AR LM 行得通
对一段 10 秒语音,按 Mimi 的 12.5 Hz × 8 码本:
N_tokens = 10 * 12.5 * 8 = 1000 tokens1000 个 token 对 transformer 来说是个微不足道的上下文。一个 256M 参数的 transformer 在现代 GPU 上几毫秒就能生成 10 秒语音。
实际使用
把问题映射到编解码:
| 任务 | 编解码 |
|---|---|
| 通用音乐生成 | EnCodec-24k |
| 最高保真重建 | DAC-44.1k |
| 语音上的 AR LM(TTS) | SNAC 或 Mimi |
| 流式全双工语音 | Mimi(12.5 Hz) |
| 带文本的音效库 | EnCodec + T5 条件 |
| 细粒度音频编辑 | DAC + 局部重绘 |
经验法则:做生成模型就从 Mimi 或 SNAC 起步。做压缩流水线就用 Opus。
坑
- 码本太多。 加码本线性提升保真度,但 LM 序列长度也线性增长。停在 8-12 个。
- 帧率不匹配。 在 12.5 Hz Mimi 上训 LM 再到 50 Hz EnCodec 上微调,会静默失败。
- 以为所有码本平等。 在 Mimi 里,码本 0 承载内容;丢了它就毁掉可懂度。丢码本 7 几乎察觉不到。
- 只用重建质量当指标。 一个编解码可以重建很好,但如果语义结构差,对基于 LM 的生成就毫无用处。
拿去用
存为 outputs/skill-codec-picker.md。为给定的生成或压缩任务挑选一个编解码。
练习
- 简单。 跑
code/main.py。它实现一个玩具的标量 + 残差量化器,随着你加码本测量重建误差。 - 中等。 装上
encodec,在一段留出语音上比较 1、4、8、32 个码本。画 PESQ 或 MSE 对码率的曲线。 - 困难。 加载 Mimi。编码一段音频。把码本 0 替换成随机整数;解码。然后同样替换码本 7。比较这两种破坏——码本 0 的破坏应该毁掉可懂度;码本 7 的破坏应该几乎不改变什么。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| RVQ | 残差量化 | 一串小码本级联;每个量化前一个的残差。 |
| 帧率 | 编解码速度 | 每秒多少个 token 帧。越低 = LM 越快。 |
| 语义码本 | 码本 0(Mimi) | 从 SSL 特征蒸馏的码本;编码内容。 |
| 声学码本 | 其余一切 | 音色、韵律、噪声、细节。 |
| PESQ / ViSQOL | 感知质量 | 与 MOS 相关的客观指标。 |
| EnCodec | Meta 编解码 | RVQ 基线;MusicGen 用它。 |
| Mimi | Kyutai 编解码 | 12.5 Hz 帧率;语义-声学切分;驱动 Moshi。 |
延伸阅读
- Défossez et al. (2023). EnCodec —— RVQ 基线。
- Kumar et al. (2023). Descript Audio Codec (DAC) —— 保真度最高的开源。
- Siuzdak (2024). SNAC —— 多尺度 RVQ。
- Kyutai (2024). Mimi codec —— 语义-声学切分,WavLM 蒸馏。
- Borsos et al. (2023). AudioLM —— 两阶段语义/声学范式。
- Zeghidour et al. (2021). SoundStream —— 最早的可流式 RVQ 编解码。