音频-语言模型 —— Qwen2.5-Omni、Audio Flamingo、GPT-4o Audio
2026 年的音频-语言模型能在语音 + 环境声 + 音乐上做推理。Qwen2.5-Omni-7B 在 MMAU-Pro 上追平 GPT-4o Audio。Audio Flamingo Next 在 LongAudioBench 上击败 Gemini 2.5 Pro。开源和闭源之间的差距基本抹平了——除了多音频任务,那上面所有人都接近随机。
类型: Learn 语言: Python 前置要求: 阶段 6 · 04(ASR)、阶段 12 · 03(视觉-语言模型)、阶段 7 · 10(音频 Transformer) 预计时间: ~45 分钟
问题背景
你有 5 秒音频:狗叫,有人喊「stop!」,然后是静音。有用的问题横跨多个维度:
- 转写。 「说了什么?」——ASR 的地盘。
- 语义推理。 「这个人有危险吗?」——需要联合理解狗叫 + 喊叫 + 静音。
- 音乐推理。 「是哪些乐器在演奏旋律?」
- 长音频检索。 「这段 90 分钟的讲座里,讲师在哪儿讲了梯度下降?」
一个用一条 prompt 就能回答所有这些的单一模型,就是音频-语言模型(LALM / ALM)。它和纯 ASR 不同:LALM 产出自由形式的自然语言答案,不只是转写文本。
核心概念
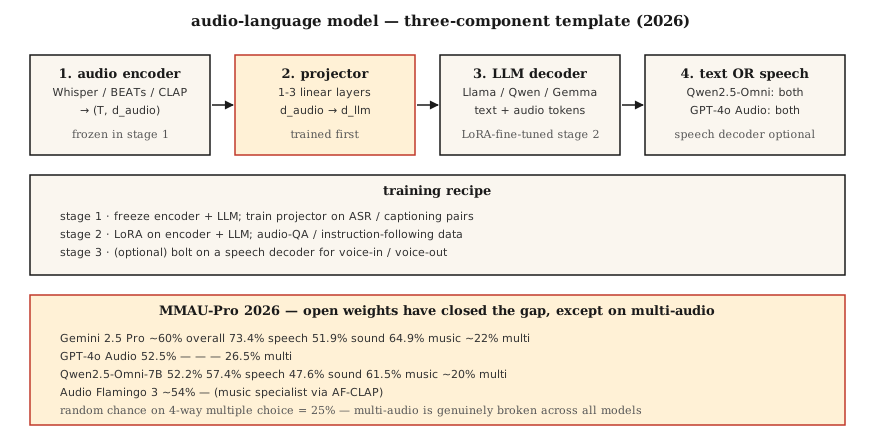
三组件模板
2026 年的每个 LALM 都是同一副骨架:
- 音频编码器。 Whisper 编码器 · BEATs · CLAP · WavLM · 或每个模型自定义的编码器。
- 投影器(Projector)。 线性层或 MLP,把音频编码器特征桥接进 LLM 的 token 嵌入空间。
- LLM。 基于 Llama / Qwen / Gemma 的解码器。接收交错的 文本 + 音频 token;生成文本。
训练:
- 阶段 1。 冻结编码器 + LLM;只在 ASR / 字幕数据上训练投影器。
- 阶段 2。 在指令跟随的音频任务(问答、推理、音乐理解)上做全量 / LoRA 微调。
- 阶段 3(可选)。 语音进 / 语音出,加一个语音解码器。Qwen2.5-Omni 和 AF3-Chat 这么做。
2026 年模型地图
| 模型 | 骨干 | 音频编码器 | 输出模态 | 获取方式 |
|---|---|---|---|---|
| Qwen2.5-Omni-7B | Qwen2.5-7B | 自定义 + Whisper | 文本 + 语音 | Apache-2.0 |
| Qwen3-Omni | Qwen3 | 自定义 | 文本 + 语音 | Apache-2.0 |
| Audio Flamingo 3 | Qwen2 | AF-CLAP | 文本 | NVIDIA 非商用 |
| Audio Flamingo Next | Qwen2 | AF-CLAP v2 | 文本 | NVIDIA 非商用 |
| SALMONN | Vicuna | Whisper + BEATs | 文本 | Apache-2.0 |
| LTU / LTU-AS | Llama | CAV-MAE | 文本 | Apache-2.0 |
| GAMA | Llama | AST + Q-Former | 文本 | Apache-2.0 |
| Gemini 2.5 Flash/Pro (闭源) | Gemini | 专有 | 文本 + 语音 | API |
| GPT-4o Audio (闭源) | GPT-4o | 专有 | 文本 + 语音 | API |
基准现实核查(2026)
MMAU-Pro。 1800 个问答对,覆盖 语音 / 声音 / 音乐 / 混合。含多音频子集。
| 模型 | 总体 | 语音 | 声音 | 音乐 | 多音频 |
|---|---|---|---|---|---|
| Gemini 2.5 Pro | ~60% | 73.4% | 51.9% | 64.9% | ~22% |
| Gemini 2.5 Flash | ~57% | 73.4% | 50.5% | 64.9% | 21.2% |
| GPT-4o Audio | 52.5% | — | — | — | 26.5% |
| Qwen2.5-Omni-7B | 52.2% | 57.4% | 47.6% | 61.5% | ~20% |
| Audio Flamingo 3 | ~54% | — | — | — | — |
| Audio Flamingo Next | LongAudioBench 上 SOTA | — | — | — | — |
多音频那一列对所有人都是当头一棒。 四选一选择题的随机命中率 = 25%;大多数模型就在那附近。LALM 至今还很难比较两段音频。
LALM 在 2026 年哪里有用
- 呼叫中心录音的合规审计。 「客服有没有提到必须的披露内容?」
- 无障碍。 给聋人用户描述声音事件(不只是转写)。
- 内容审核。 检测暴力语言 + 威胁语气 + 背景上下文。
- 播客 / 会议分章。 语义摘要,而不只是说话人轮次。
- 音乐曲库分析。 「找出所有 B 段有转调的曲目。」
它们(暂时)还不有用的地方
- 细粒度的乐理(和弦级别以下)。
- 长对话中带说话人归属的推理(超过 10 分钟就退化)。
- 多音频比较(22-26% 勉强高于随机)。
- 实时流式推理(大多数是离线批量推理)。
figure
v4-alm-tokens动手构建
第 1 步:查询 Qwen2.5-Omni
python
from transformers import AutoModelForCausalLM, AutoProcessor

processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-Omni-7B")
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-Omni-7B", torch_dtype="auto")

audio, sr = load_wav("clip.wav", sr=16000)
messages = [{
    "role": "user",
    "content": [
        {"type": "audio", "audio": audio},
        {"type": "text", "text": "What sounds do you hear, and what's happening?"},
    ],
}]
inputs = processor.apply_chat_template(messages, tokenize=True, return_tensors="pt")
output = model.generate(**inputs, max_new_tokens=200)
print(processor.decode(output[0], skip_special_tokens=True))
第 2 步:投影器模式
python
import torch.nn as nn

class AudioProjector(nn.Module):
    def __init__(self, audio_dim=1280, llm_dim=4096):
        super().__init__()
        self.down = nn.Linear(audio_dim, llm_dim)
        self.act = nn.GELU()
        self.up = nn.Linear(llm_dim, llm_dim)

    def forward(self, audio_features):
        return self.up(self.act(self.down(audio_features)))
就这些。投影器通常是 1-3 个线性层。在 ASR 对(音频 → 转写)上训练它,就是阶段 1 的前置任务。
第 3 步:在 MMAU / LongAudioBench 上跑基准
python
from datasets import load_dataset
mmau = load_dataset("MMAU/MMAU-Pro")

correct = 0
for item in mmau["test"]:
    answer = call_model(item["audio"], item["question"], item["choices"])
    if answer == item["correct_choice"]:
        correct += 1
print(f"Accuracy: {correct / len(mmau['test']):.3f}")
按类别(语音 / 声音 / 音乐 / 多音频)分别报告。汇总数字会掩盖模型在哪里失败。
实际使用
| 任务 | 2026 年选 |
|---|---|
| 自由形式音频问答(开源) | Qwen2.5-Omni-7B |
| 长音频上最强的开源 | Audio Flamingo Next |
| 最强闭源 | Gemini 2.5 Pro |
| 语音进 / 语音出 agent | Qwen2.5-Omni 或 GPT-4o Audio |
| 音乐推理 | Audio Flamingo 3 或 2(音乐专用的 AF-CLAP) |
| 呼叫中心审计 | 通过 API 用 Gemini 2.5 Pro,对你的政策文档做 RAG |
坑
- 在多音频上过度信任。 如果你的任务需要「哪段音频里有 X」,随机命中率级别的表现是真的。
- 长音频退化。 超过 10 分钟,大多数模型的说话人归属就崩了。先做说话人分离(第 6 课),再做摘要。
- 静音上的幻觉。 用 Whisper 编码器的 LALM 继承了同样的 Whisper 式问题。VAD 把门。
- 基准挑樱桃。 厂商博文专挑表现最好的类别。自己跑一遍 MMAU-Pro 的多音频子集。
拿去用
存为 outputs/skill-alm-picker.md。为给定的音频理解任务挑选 LALM + 基准子集 + 输出模态(文本 vs 语音)。
练习
- 简单。 跑
code/main.py,看一个玩具投影器模式 + 假的 LALM 把 (音频嵌入, 文本 token) → 输出 token 的路由。 - 中等。 在 100 个 MMAU-Pro 语音条目上给 Qwen2.5-Omni-7B 打分。对比论文报告的数字。
- 困难。 搭一个最小的音频字幕基线:BEATs 编码器 + 2 层投影器 + 冻结的 Llama-3.2-1B。只在 AudioCaps 上微调投影器。在 Clotho-AQA 上对比 SALMONN。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| LALM | 音频版 ChatGPT | 音频编码器 + 投影器 + LLM 解码器。 |
| 投影器(Projector) | 适配器 | 把音频特征映射进 LLM 嵌入空间的小 MLP。 |
| MMAU | 那个基准 | 横跨语音、声音、音乐的 1 万个音频问答对。 |
| MMAU-Pro | 更难的 MMAU | 1800 个多音频 / 重推理的问题。 |
| LongAudioBench | 长音频评估 | 带语义查询的数分钟片段。 |
| 语音进 / 语音出 | 语音原生 | 模型直接吃语音、吐语音,不绕文本。 |
延伸阅读
- Chu et al. (2024). Qwen2-Audio —— 参考架构。
- Alibaba (2025). Qwen2.5-Omni —— 语音进语音出。
- NVIDIA (2025). Audio Flamingo 3 —— 开源长音频领跑者。
- NVIDIA (2026). Audio Flamingo Next —— LongAudioBench SOTA。
- Tang et al. (2023). SALMONN —— 双编码器先驱。
- MMAU-Pro leaderboard —— 2026 年实时排名。