子词分词 —— BPE、WordPiece、Unigram、SentencePiece
词级分词器在没见过的词上卡壳。字符级分词器把序列长度撑爆。子词分词器折中。每个现代 LLM 都靠它出货。
类型: Learn 语言: Python 前置要求: Phase 5 · 01(文本处理)、Phase 5 · 04(GloVe / FastText / 子词) 预计时间: ~60 分钟
问题背景
你的词表有 50000 个词。用户敲下 "untokenizable"。你的分词器返回 [UNK]。模型现在对这个词没有任何信号。更糟的是:你语料里 90 百分位的文档有 40 个罕见词,意味着每篇文档丢 40 比特信息。
子词分词解决了这个。常见词保持单 token。罕见词分解成有意义的零件:untokenizable → un、token、izable。训练数据覆盖一切,因为任何字符串归根结底都是一串字节。
2026 年每个前沿 LLM 都靠三种算法之一出货(BPE、Unigram、WordPiece),包在三个库之一里(tiktoken、SentencePiece、HF Tokenizers)。你不挑一个就没法出货一个语言模型。
核心概念
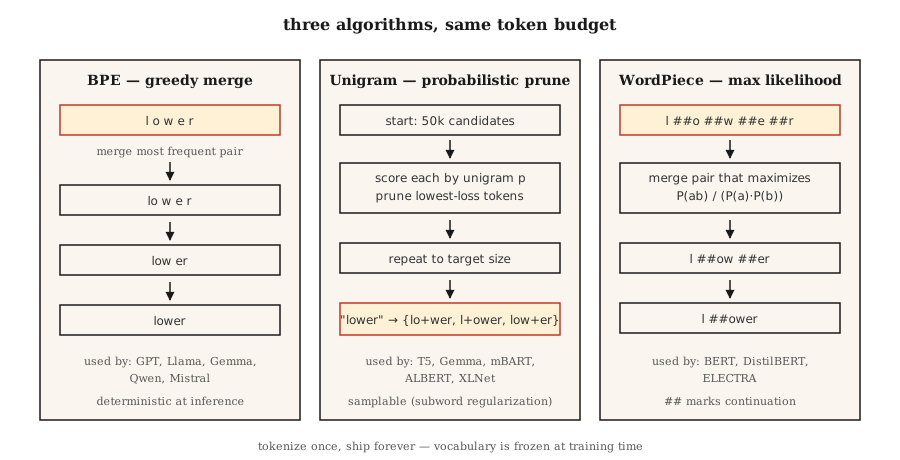
BPE(字节对编码)。 从字符级词表开始。数每一对相邻。把最频繁的对合并成新 token。重复,直到达到目标词表大小。主导算法:GPT-2/3/4、Llama、Gemma、Qwen2、Mistral。
字节级 BPE。 同样的算法,但作用在原始字节(256 个基础 token)而非 Unicode 字符上。保证零 [UNK] token——任何字节序列都能编码。GPT-2 用 50257 个 token(256 字节 + 50000 次合并 + 1 个特殊 token)。
Unigram。 从一个庞大词表开始。给每个 token 一个一元概率。迭代地剪掉那些去掉后最少增加语料对数似然的 token。推理时是概率式的:能采样分词(通过子词正则化做数据增强很有用)。T5、mBART、ALBERT、XLNet、Gemma 用它。
WordPiece。 合并那些最大化训练语料似然的对,而非原始频率。BERT、DistilBERT、ELECTRA 用它。
SentencePiece vs tiktoken。 SentencePiece 是那个直接在原始 Unicode 文本上训练词表(BPE 或 Unigram)的库,把空白编码成 ▁。tiktoken 是 OpenAI 针对预建词表的快速编码器;它不训练。
经验法则:
- 训练一个新词表: SentencePiece(多语言,无需预分词)或 HF Tokenizers。
- 针对 GPT 词表做快速推理: tiktoken(cl100k_base、o200k_base)。
- 两者都要: HF Tokenizers —— 一个库,训练 + 服务。
bpe-merge动手构建
第 1 步:从零实现 BPE
见 code/main.py。循环是:
def train_bpe(corpus, num_merges):
    vocab = {tuple(word) + ("</w>",): count for word, count in corpus.items()}
    merges = []
    for _ in range(num_merges):
        pairs = Counter()
        for symbols, freq in vocab.items():
            for a, b in zip(symbols, symbols[1:]):
                pairs[(a, b)] += freq
        if not pairs:
            break
        best = pairs.most_common(1)[0][0]
        merges.append(best)
        vocab = apply_merge(vocab, best)
return merges算法编码了三个事实。</w> 标记词尾,让 "low"(后缀)和 "lower"(前缀)保持可区分。频率加权让高频对早早胜出。合并列表是有序的——推理时按训练顺序施加合并。
第 2 步:用学到的合并来编码
def encode_bpe(word, merges):
    symbols = list(word) + ["</w>"]
    for a, b in merges:
        i = 0
        while i < len(symbols) - 1:
            if symbols[i] == a and symbols[i + 1] == b:
                symbols = symbols[:i] + [a + b] + symbols[i + 2:]
            else:
                i += 1
    return symbols
朴素的 O(n·|merges|)。生产实现(tiktoken、HF Tokenizers)用合并秩查找加优先队列,跑在近线性时间。
第 3 步:实践中的 SentencePiece
import sentencepiece as spm

spm.SentencePieceTrainer.train(
    input="corpus.txt",
    model_prefix="my_tokenizer",
    vocab_size=8000,
    model_type="bpe",          # 或 "unigram"
    character_coverage=0.9995, # CJK 调低(如英语 0.9995,日语 0.995)
    normalization_rule_name="nmt_nfkc",
)

sp = spm.SentencePieceProcessor(model_file="my_tokenizer.model")
print(sp.encode("untokenizable", out_type=str))
# ['▁un', 'token', 'izable']
注意:无需预分词,空格编码成 ▁,character_coverage 控制罕见字符被保留还是被映射成 <unk> 的激进程度。
第 4 步:tiktoken 用于 OpenAI 兼容词表
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
print(enc.encode("untokenizable"))        # [127340, 101028]
print(len(enc.encode("Hello, world!")))   # 4
仅编码。快(Rust 后端)。在字节计数、成本估算、上下文窗口预算上和 GPT-4/5 的分词精确一致。
2026 年仍在上线的坑
- 分词器漂移。 在词表 A 上训练,部署时针对词表 B。token ID 不同;模型输出垃圾。在 CI 里检查
tokenizer.json的哈希。 - 空白歧义。 BPE 里 "hello" vs " hello" 产出不同 token。永远显式指定
add_special_tokens和add_prefix_space。 - 多语言训练不足。 偏英语的语料产出的词表,把非拉丁文字切成 5-10 倍的 token。在 GPT-3.5 上,同一个 prompt 用日语/阿拉伯语贵 5-10 倍。o200k_base 部分修了这个。
- emoji 切分。 单个 emoji 可能占 5 个 token。预算上下文时核查 emoji 处理。
实际使用
2026 年的栈:
| 场景 | 选择 |
|---|---|
| 从零训练一个单语言模型 | HF Tokenizers(BPE) |
| 训练一个多语言模型 | SentencePiece(Unigram,character_coverage=0.9995) |
| 服务一个 OpenAI 兼容 API | tiktoken(GPT-4+ 用 o200k_base) |
| 领域专用词表(代码、数学、蛋白质) | 在领域语料上训自定义 BPE,与基础词表合并 |
| 边缘推理、小模型 | Unigram(更小的词表效果更好) |
词表大小是一个 scaling 决策,不是常量。粗略经验:<1B 参数用 32k,1-10B 用 50-100k,多语言/前沿用 200k+。
拿去用
存为 outputs/skill-bpe-vs-wordpiece.md:
---
name: tokenizer-picker
description: Pick tokenizer algorithm, vocab size, library for a given corpus and deployment target.
version: 1.0.0
phase: 5
lesson: 19
tags: [nlp, tokenization]
---

Given a corpus (size, languages, domain) and deployment target (training from scratch / fine-tuning / API-compatible inference), output:

1. Algorithm. BPE, Unigram, or WordPiece. One-sentence reason.
2. Library. SentencePiece, HF Tokenizers, or tiktoken. Reason.
3. Vocab size. Rounded to nearest 1k. Reason tied to model size and language coverage.
4. Coverage settings. `character_coverage`, `byte_fallback`, special-token list.
5. Validation plan. Average tokens-per-word on held-out set, OOV rate, compression ratio, round-trip decode equality.

Refuse to train a character-coverage <0.995 tokenizer on corpora with rare-script content. Refuse to ship a vocab without a frozen `tokenizer.json` hash check in CI. Flag any monolingual tokenizer under 16k vocab as likely under-spec.
练习
- 简单。 在
code/main.py的小语料上训练一个 500 次合并的 BPE。编码三个留出词。有几个恰好产出 1 个 token vs >1 个 token? - 中等。 在 100 句英语维基百科上对比
cl100k_base、o200k_base和你训练的一个 vocab=32k 的 SentencePiece BPE 之间的 token 数。报告各自的压缩比。 - 困难。 用 BPE、Unigram、WordPiece 在同一语料上训练。在一个小情感分类器上分别用它们,测量下游准确率。这个选择会让指标动超过 1 个点的 F1 吗?
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| BPE | 字节对编码 | 贪心合并最高频字符对,直到达到目标词表大小。 |
| 字节级 BPE | 永不出现未知 token | 在原始 256 字节上的 BPE;GPT-2 / Llama 用它。 |
| Unigram | 概率式分词器 | 用对数似然从一个大候选集里剪枝;T5、Gemma 用它。 |
| SentencePiece | 管空白的那个 | 在原始文本上训练 BPE/Unigram 的库;空格编码成 ▁。 |
| tiktoken | 快的那个 | OpenAI 用 Rust 写的、针对预建词表的 BPE 编码器。不训练。 |
| 合并列表 | 那些魔法数字 | (a, b) → ab 合并的有序列表;推理时按序施加。 |
| 字符覆盖率 | 多罕见才算太罕见? | 分词器必须覆盖的训练语料字符比例;~0.9995 是典型值。 |
延伸阅读
- Sennrich, Haddow, Birch (2015). Neural Machine Translation of Rare Words with Subword Units —— BPE 论文。
- Kudo (2018). Subword Regularization with Unigram Language Model —— Unigram 论文。
- Kudo, Richardson (2018). SentencePiece: A simple and language independent subword tokenizer —— 那个库。
- Hugging Face — Summary of the tokenizers —— 简明参考。
- OpenAI tiktoken repo —— cookbook + 编码列表。