Vision Transformers (ViT)
一张图像是一格格 patch。一个句子是一格格 token。同一个 transformer 两者通吃。
类型: Build 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 4 · 03(CNN)、阶段 4 · 14(Vision Transformers 入门) 预计时间: ~45 分钟
问题背景
2020 年之前,计算机视觉就意味着卷积。ImageNet、COCO 和检测基准上每个 SOTA 都用 CNN 骨干。transformer 是给语言用的。
Dosovitskiy et al.(2020)——《An Image is Worth 16x16 Words》——证明你可以彻底丢掉卷积。把图像切成固定大小的 patch,把每个 patch 线性投影成一个嵌入,把这个序列喂给一个普通的 transformer 编码器。在足够规模下(ImageNet-21k 预训练或更大),ViT 追平甚至打败基于 ResNet 的模型。
ViT 是 2026 年一个更广泛模式的开端:一个架构,多种模态。Whisper 把音频 token 化。ViT 把图像 token 化。机器人的动作 token。视频的像素 token。transformer 不在乎——喂它一个序列,它就学。
到 2026 年,ViT 及其后代(DeiT、Swin、DINOv2、ViT-22B、SAM 3)占据了视觉的大部分。CNN 在边缘设备和延迟敏感任务上仍然赢。其他一切的栈里某处都有个 ViT。
核心概念
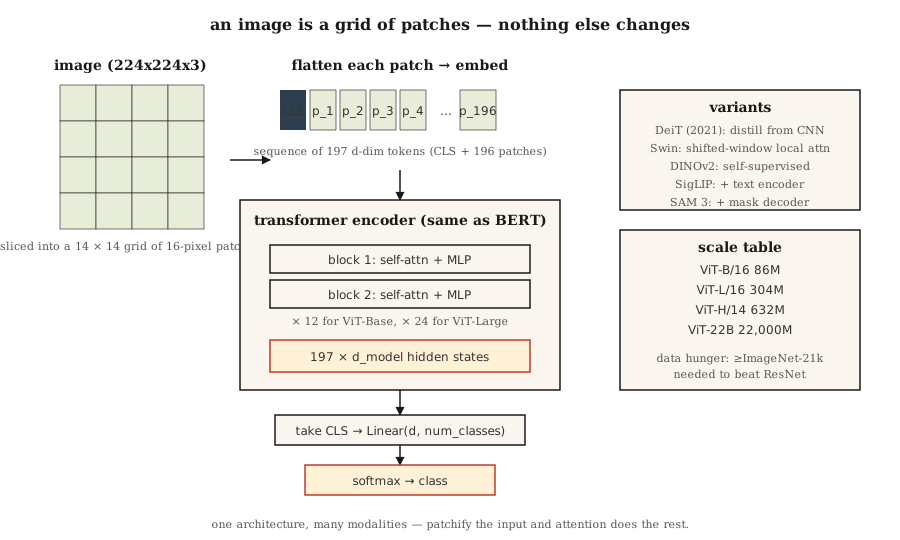
第 1 步 —— patchify
把一张 H × W × C 的图像切成一个 N × (P·P·C) 的扁平 patch 序列。典型设置:224 × 224 图像,16 × 16 patch → 196 个 patch,每个 768 个值。
image (224, 224, 3) → 14 × 14 grid of 16x16x3 patches → 196 vectors of length 768patch 大小是那个杠杆。patch 越小 = 越多 token、分辨率越好、注意力代价二次方增长。patch 越大 = 越粗、越便宜。
第 2 步 —— 线性嵌入
一个学到的矩阵把每个扁平 patch 投影到 d_model。等价于一个 kernel 大小为 P、stride 为 P 的卷积。在 PyTorch 里这就是 nn.Conv2d(C, d_model, kernel_size=P, stride=P)——2 行实现。
第 3 步 —— 在前面加 [CLS] token,加位置嵌入
- 在前面加一个可学习的
[CLS]token。它的最终隐藏状态就是用于分类的图像表示。 - 加可学习的位置嵌入(ViT 原版)或正弦 2D(后来的变体)。
- 2024+ 把 RoPE 扩展到 2D 来表位置,有时不带显式嵌入。
第 4 步 —— 标准 transformer 编码器
堆 L 个 LayerNorm → Self-Attention → + → LayerNorm → MLP → + 的 block。和 BERT 一模一样。没有视觉专用层。这是论文教学上的妙处。
第 5 步 —— 头
分类用:取 [CLS] 隐藏状态 → 线性 → softmax。DINOv2 或 SAM 则丢掉 [CLS],直接用 patch 嵌入。
有分量的变体
| 模型 | 年份 | 改了什么 |
|---|---|---|
| ViT | 2020 | 原版。固定 patch 大小,完整全局注意力。 |
| DeiT | 2021 | 蒸馏;只用 ImageNet-1k 就能训。 |
| Swin | 2021 | 带移位窗口的层级结构。修成了次二次代价。 |
| DINOv2 | 2023 | 自监督(无标签)。最好的通用视觉特征。 |
| ViT-22B | 2023 | 22B 参数;scaling laws 适用。 |
| SigLIP | 2023 | ViT + 语言配对,sigmoid 对比损失。 |
| SAM 3 | 2025 | 万物分割;ViT-Large + 可提示的掩码解码器。 |
为什么花了点时间
ViT 需要大量数据才能追平 CNN,因为它没有任何 CNN 的归纳偏置(平移不变性、局部性)。没有 >1 亿张标注图像或强自监督预训练,CNN 在同等算力下仍然赢。DeiT 在 2021 年用蒸馏招数修了这点;DINOv2 在 2023 年用自监督把它永久修好了。
n5-patch-stream动手构建
见 code/main.py。纯标准库的 patchify + 线性嵌入 + 健全性检查。不训练——任何现实规模的 ViT 都需要 PyTorch 和数小时 GPU 时间。
第 1 步:假图像
一张 24 × 24 的 RGB 图像,表示为一个个 (R, G, B) 元组行的列表。我们用 6×6 的 patch → 16 个 patch,每个 108 维嵌入向量。
第 2 步:patchify
def patchify(image, P):
    H = len(image)
    W = len(image[0])
    patches = []
    for i in range(0, H, P):
        for j in range(0, W, P):
            patch = []
            for di in range(P):
                for dj in range(P):
                    patch.extend(image[i + di][j + dj])
            patches.append(patch)
    return patches
光栅顺序:在网格上按行主序。每个 ViT 都用这个顺序。
第 3 步:线性嵌入
把每个扁平 patch 乘一个随机的 (patch_flat_size, d_model) 矩阵。在前面加上 [CLS] 后,验证输出形状是 (N_patches + 1, d_model)。
第 4 步:为一个现实的 ViT 数参数
打印 ViT-Base 的参数量:12 层、12 头、d=768、patch=16。和 ResNet-50(~25M)比一比。ViT-Base 落在 ~86M。ViT-Large ~307M。ViT-Huge ~632M。
实际使用
from transformers import ViTImageProcessor, ViTModel
import torch
from PIL import Image

processor = ViTImageProcessor.from_pretrained("google/vit-base-patch16-224-in21k")
model = ViTModel.from_pretrained("google/vit-base-patch16-224-in21k")

img = Image.open("cat.jpg")
inputs = processor(img, return_tensors="pt")
out = model(**inputs).last_hidden_state   # (1, 197, 768): [CLS] + 196 个 patch
cls_emb = out[:, 0]                       # 图像表示
DINOv2 嵌入是 2026 年图像特征的默认选择。 冻结骨干,训一个小头。分类、检索、检测、描述都能用。Meta 的 DINOv2 checkpoint 在每个非文本视觉任务上都胜过 CLIP。
patch 大小怎么挑。 小模型用 16×16(ViT-B/16)。密集预测(分割)用 8×8 或 14×14(SAM、DINOv2)。超大模型用 14×14。
拿去用
见 outputs/skill-vit-configurator.md。这个 skill 会根据数据集大小、分辨率和算力预算,为一个新视觉任务挑选 ViT 变体和 patch 大小。
练习
- 简单。 跑
code/main.py。验证 patch 数等于(H/P) * (W/P),扁平 patch 维度等于P*P*C。 - 中等。 实现 2D 正弦位置嵌入——为每个 patch 的
row和col各算一套独立的正弦码,拼起来。把它们喂进一个小 PyTorch ViT,在 CIFAR-10 上和可学习位置嵌入比准确率。 - 困难。 搭一个 3 层 ViT(PyTorch),用 4×4 patch 在 1,000 张 MNIST 图像上训练。测测试准确率。现在在同样的 1,000 张图像上加 DINOv2 预训练(简化版:就训编码器从被掩 patch 预测 patch 嵌入)。准确率提升了吗?
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| Patch | "vision transformer 的 token" | 图像中一个 P × P × C 区域的像素值扁平向量。 |
| Patchify | "切 + 摊平" | 把图像切成不重叠的 patch,每个摊平成向量。 |
[CLS] token | "图像摘要" | 加在前面的可学习 token;它的最终嵌入是图像表示。 |
| 归纳偏置 | "模型假设了什么" | ViT 的先验比 CNN 少;要更多数据来补这个差距。 |
| DINOv2 | "自监督 ViT" | 用图像增强 + 动量教师在无标签下训练。2026 年最好的通用图像特征。 |
| SigLIP | "CLIP 的继任者" | ViT + 文本编码器,用 sigmoid 对比损失训练;在同等算力下比 CLIP 好。 |
| Swin | "窗口化 ViT" | 带局部注意力 + 移位窗口的层级 ViT;次二次。 |
| Register token | "2023 年的招" | 几个额外的可学习 token,吸收注意力汇(attention sink);提升 DINOv2 特征。 |
延伸阅读
- Dosovitskiy et al. (2020). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale —— ViT 论文。
- Touvron et al. (2021). Training data-efficient image transformers & distillation through attention —— DeiT。
- Liu et al. (2021). Swin Transformer: Hierarchical Vision Transformer using Shifted Windows —— Swin。
- Oquab et al. (2023). DINOv2: Learning Robust Visual Features without Supervision —— DINOv2。
- Darcet et al. (2023). Vision Transformers Need Registers —— DINOv2 的 register-token 修法。