音频基础 —— 波形、采样、傅里叶变换
波形是原始信号,频谱图是它的表示形式,梅尔特征则是对 ML 友好的形态。每一条现代 ASR 和 TTS 流水线都要爬完这道阶梯,而第一级台阶就是搞懂采样和傅里叶。
类型: Learn 语言: Python 前置要求: 阶段 1 · 06(向量与矩阵)、阶段 1 · 14(概率分布) 预计时间: ~45 分钟
问题背景
麦克风产出的是一段「压强随时间变化」的信号,而你的神经网络吃的是张量。两者之间隔着一摞约定,一旦违反就会冒出静默 bug:模型训练得好好的,WER 却翻了一倍;TTS 上线后带着嘶嘶的底噪;语音克隆系统记住的是麦克风,而不是说话人。
语音系统里的每个 bug,最终都能追溯到三个问题之一:
- 数据是用什么采样率录的,模型又期望什么采样率?
- 信号有没有发生混叠?
- 你操作的是原始采样点,还是某种频域表示?
把这三点弄对,第 6 阶段剩下的内容就都好办了。弄错了,哪怕是 Whisper-Large-v4 也只会吐垃圾。
核心概念
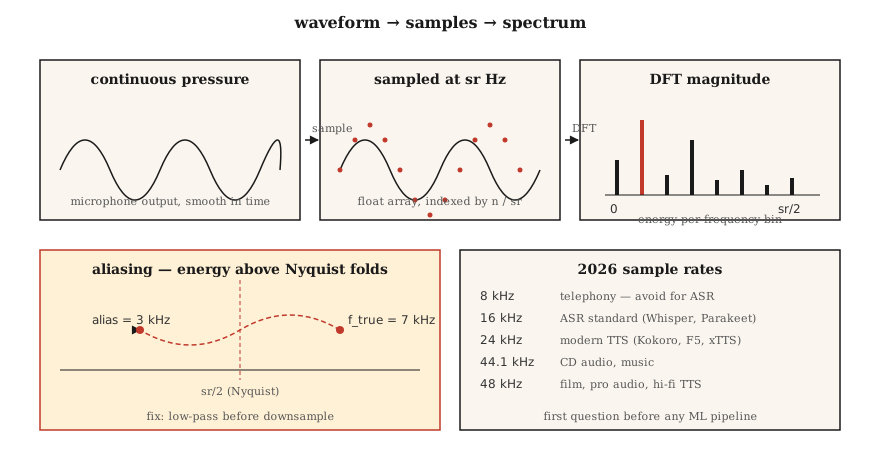
波形(Waveform)。 一个一维浮点数组,取值在 [-1.0, 1.0],用采样点序号索引。换算成秒就除以采样率:t = n / sr。一段 16 kHz 的 10 秒音频,就是 160,000 个浮点数的数组。
采样率(sr)。 每秒采多少个样本。2026 年常见的采样率:
| 采样率 | 用途 |
|---|---|
| 8 kHz | 电话语音、老式 VOIP。奈奎斯特频率只有 4 kHz,辅音都被砍掉。ASR 别用。 |
| 16 kHz | ASR 标准。Whisper、Parakeet、SeamlessM4T v2 吃的都是 16 kHz。 |
| 22.05 kHz | 老模型的 TTS 声码器训练。 |
| 24 kHz | 现代 TTS(Kokoro、F5-TTS、xTTS v2)。 |
| 44.1 kHz | CD 音频、音乐。 |
| 48 kHz | 影视、专业音频、高保真 TTS(VALL-E 2、NaturalSpeech 3)。 |
奈奎斯特-香农(Nyquist-Shannon)。 采样率 sr 能毫无歧义地表示的频率上限是 sr/2。sr/2 这条边界就是奈奎斯特频率。超过奈奎斯特的能量会发生混叠(aliasing)——被折叠到更低的频率上去——把信号搞坏。降采样之前一定先做低通滤波。
位深(Bit depth)。 16-bit PCM(有符号 int16,范围 ±32,767)是通用的交换格式。音乐用 24-bit,内部 DSP 处理用 32-bit 浮点。像 soundfile 这样的库读进来是 int16,但对外暴露的是 [-1, 1] 区间的 float32 数组。
傅里叶变换(Fourier Transform)。 任何有限信号都是不同频率正弦波之和。离散傅里叶变换(DFT)对 N 个采样点算出 N 个复系数——每个频率分箱一个。bin k 对应频率 k · sr / N Hz,幅值是该频率上的振幅,相角是相位。
FFT。 快速傅里叶变换:当 N 是 2 的幂时,计算 DFT 的 O(N log N) 算法。所有音频库底层用的都是 FFT。16 kHz 下做一个 1024 点的 FFT,能得到 512 个可用频率分箱,覆盖 0–8 kHz,分辨率 15.6 Hz。
分帧 + 加窗(Framing + window)。 我们不会对整段音频做一次 FFT,而是把它切成有重叠的帧(通常 25 ms 一帧,10 ms 跳步),每帧乘以一个窗函数(Hann、Hamming)来消除边缘的不连续,然后对每一帧做 FFT。这就是短时傅里叶变换(STFT)。第 02 课接着往下讲。
mel-scale动手构建
第 1 步:读入一段音频并画出波形
code/main.py 只用标准库里的 wave 模块,让示例零依赖。生产环境里你会用 soundfile 或 torchaudio.load(两者都返回 (waveform, sr) 元组):
import soundfile as sf
waveform, sr = sf.read("clip.wav", dtype="float32")  # shape (T,), sr=int
第 2 步:从第一性原理合成一个正弦波
import math

def sine(freq_hz, sr, seconds, amp=0.5):
    n = int(sr * seconds)
    return [amp * math.sin(2 * math.pi * freq_hz * i / sr) for i in range(n)]
16 kHz 下时长 1 秒的 440 Hz 正弦波(音乐会标准音 A)就是 16,000 个浮点数。用 wave.open(..., "wb") 以 16-bit PCM 编码写出。
第 3 步:手算 DFT
def dft(x):
    N = len(x)
    out = []
    for k in range(N):
        re = sum(x[n] * math.cos(-2 * math.pi * k * n / N) for n in range(N))
        im = sum(x[n] * math.sin(-2 * math.pi * k * n / N) for n in range(N))
        out.append((re, im))
return outO(N²)——拿 N=256 验证正确性还行,对真实音频毫无用处。真实代码会调 numpy.fft.rfft 或 torch.fft.rfft。
第 4 步:找出主频
幅值峰值所在的索引 k_star 对应频率 k_star * sr / N。在那个 440 Hz 正弦波上跑这一步,应该在 440 * N / sr 这个分箱处出现峰值。
第 5 步:演示混叠
用 10 kHz 去采样一个 7 kHz 的正弦波(奈奎斯特频率 = 5 kHz)。7 kHz 的音高超过了奈奎斯特,被折叠到 10 − 7 = 3 kHz。FFT 峰值就出现在 3 kHz。这是经典的混叠演示,也正是每个 DAC/ADC 都自带一道陡峭低通滤波器的原因。
实际使用
2026 年你真正会用上线的那套工具:
| 任务 | 库 | 为什么 |
|---|---|---|
| 读写 WAV/FLAC/OGG | soundfile(libsndfile 封装) | 最快、稳定、返回 float32。 |
| 重采样 | torchaudio.transforms.Resample 或 librosa.resample | 内置了正确的抗混叠。 |
| STFT / 梅尔 | torchaudio 或 librosa | GPU 友好;PyTorch 生态。 |
| 实时流式 | sounddevice 或 pyaudio | 跨平台的 PortAudio 绑定。 |
| 查看一个文件 | ffprobe 或 soxi | 命令行、快、报告 sr/声道数/编码格式。 |
决策准则:先对齐采样率,再对齐别的一切。Whisper 期望 16 kHz 单声道 float32。喂给它 44.1 kHz 立体声,你只会得到一堆看起来像模型 bug 的垃圾。
拿去用
存为 outputs/skill-audio-loader.md。这个 skill 帮你检查音频输入是否符合下游模型的期望,不符合时正确地重采样。
练习
- 简单。 在 16 kHz 下合成一段 1 秒、混合了 220 Hz + 440 Hz + 880 Hz 的音频。跑一遍 DFT,确认在预期分箱处出现三个峰值。
- 中等。 用 48 kHz 录一段 3 秒的自己的声音存成 WAV。用
torchaudio.transforms.Resample(带抗混叠)降到 16 kHz,再用朴素抽取(每隔三个取一个采样点)降到 16 kHz。两个都做 FFT。混叠出现在哪里? - 困难。 只用
math和第 3 步的 DFT 从零搭出 STFT。帧长 400,跳步 160,Hann 窗。用matplotlib.pyplot.imshow画出幅值。这就是第 02 课要讲的频谱图。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 采样率 | 每秒采多少个样本 | ADC 测量信号的频率,单位 Hz。 |
| 奈奎斯特 | 你能表示的最高频率 | sr/2;超过它的能量会折叠回来。 |
| 位深 | 每个采样点的分辨率 | int16 = 65,536 个量化级;float32 = [-1, 1] 区间内的 24 位精度。 |
| DFT | 序列的傅里叶变换 | N 个采样点 → N 个复频率系数。 |
| FFT | 快速版 DFT | O(N log N) 算法,要求 N 是 2 的幂。 |
| Bin(分箱) | 频率列 | k · sr / N Hz;分辨率 = sr / N。 |
| STFT | 频谱图的底层 | 在时间轴上做分帧 + 加窗的 FFT。 |
| 混叠 | 诡异的频率鬼影 | 超过奈奎斯特的能量镜像折叠到更低的分箱。 |
延伸阅读
- Shannon (1949). Communication in the Presence of Noise —— 采样定理背后的那篇论文。
- Smith — The Scientist and Engineer's Guide to Digital Signal Processing —— 免费、经典的 DSP 教科书。
- librosa docs — audio primer —— 带代码的实操走查。
- Heinrich Kuttruff — Room Acoustics (6th ed.) —— 解释为什么真实世界的音频不是一条干净正弦波的参考书。
- Steve Eddins — FFT Interpretation notebook —— 10 分钟讲清楚频率分箱的直觉。