音频评估 —— WER、MOS、UTMOS、MMAU、FAD,以及那些开放排行榜
测不了的东西你就交付不了。这一课给每个音频任务点名 2026 年的指标:ASR(WER、CER、RTFx)、TTS(MOS、UTMOS、SECS、ASR 往返 WER)、音频-语言(MMAU、LongAudioBench)、音乐(FAD、CLAP)、说话人(EER)。还有你拿来对比的那些排行榜。
类型: Learn 语言: Python 前置要求: 阶段 6 · 04、06、07、09、10;阶段 2 · 09(模型评估) 预计时间: ~60 分钟
问题背景
每个音频任务都有多个指标,各自衡量不同的维度。用错指标,就会交付一个仪表盘上看着很棒、生产里烂得一塌糊涂的模型。2026 年的经典清单:
| 任务 | 主指标 | 次指标 |
|---|---|---|
| ASR | WER | CER · RTFx · 首 token 延迟 |
| TTS | MOS / UTMOS | SECS · ASR 往返 WER · CER · TTFA |
| 语音克隆 | SECS(ECAPA 余弦) | MOS · CER |
| 说话人验证 | EER | minDCF · 工作点处的 FAR / FRR |
| 说话人分离 | DER | JER · 说话人混淆 |
| 音频分类 | top-1 · mAP | 宏观 F1 · 各类别召回率 |
| 音乐生成 | FAD | CLAP · 听评小组 MOS |
| 音频语言模型 | MMAU-Pro | LongAudioBench · AudioCaps FENSE |
| 流式 S2S | 延迟 P50/P95 | WER · MOS |
核心概念
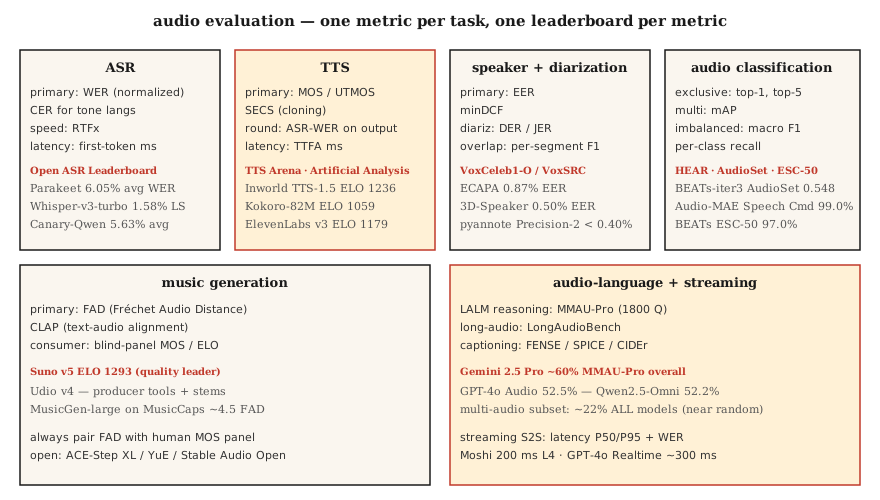
ASR 指标
WER(词错误率)。 (S + D + I) / N。打分前先小写化、去标点、归一化数字。用 jiwer 或 OpenAI 的 whisper_normalizer。< 5% = 朗读语音达人类水平。
CER(字符错误率)。 同样的公式,字符级别。用于词切分有歧义的声调语言(普通话、粤语)。
RTFx(实时因子的倒数)。 每墙钟秒处理的音频秒数。越高越好。Parakeet-TDT 达到 3380×。Whisper-large-v3 约 30×。
首 token 延迟。 从音频输入到第一个转写 token 的墙钟时间。流式场景关键。Deepgram Nova-3:约 150 ms。
TTS 指标
MOS(平均意见得分)。 1-5 人工评分。黄金标准但慢。每个样本收 20+ 名听众,每个模型 100+ 个样本。
UTMOS(2022-2026)。 学习得到的 MOS 预测器。在标准基准上与人类 MOS 相关性约 0.9。F5-TTS:UTMOS 3.95;真值:4.08。
SECS(说话人编码器余弦相似度)。 用于语音克隆。参考和克隆输出之间的 ECAPA 嵌入余弦。> 0.75 = 可辨认的克隆。
ASR 往返 WER。 把 Whisper 跑在 TTS 输出上,对输入文本算 WER。抓可懂度退化。2026 年 SOTA:< 2% CER。
TTFA(首音频时间)。 墙钟延迟。Kokoro-82M:约 100 ms;F5-TTS:约 1 s。
语音克隆专属
SECS + MOS + CER 三件套。SECS 高但 MOS 低的克隆意味着音色对但不自然;反过来则是声音自然但说话人错了。
说话人验证
EER(等错误率)。 误接受率等于误拒绝率的那个阈值。ECAPA 在 VoxCeleb1-O 上:0.87%。
minDCF(最小检测代价)。 在选定工作点(常取 FAR=0.01)处的加权代价。比 EER 更贴近生产。
说话人分离
DER(说话人分离错误率)。 (FA + Miss + Confusion) / total_speaker_time。漏检语音 + 误报语音 + 说话人混淆,各占一个比例。AMI 会议:DER 约 10-20% 是现实的。pyannote 3.1 + Precision-2 商用:录音良好时 <10% DER。
JER(杰卡德错误率)。 DER 的替代,对短段偏差更鲁棒。
音频分类
多标签:所有类别上的 mAP(平均精度均值)。AudioSet:BEATs-iter3 是 0.548 mAP。
多类互斥:top-1、top-5 准确率。Speech Commands v2:99.0% top-1(Audio-MAE)。
不平衡:宏观 F1 + 各类别召回率。按类别报告——汇总准确率会掩盖哪些类别失败。
音乐生成
FAD(Fréchet 音频距离)。 真实与生成音频的 VGGish 嵌入分布之间的距离。MusicGen-small 在 MusicCaps 上:4.5。MusicLM:4.0。越低越好。
CLAP 分数。 用 CLAP 嵌入的文本-音频对齐分数。> 0.3 = 合理的对齐。
听评小组 MOS。 对消费级音乐仍是最终裁决。Suno v5 在 TTS Arena 上 ELO 1293(来自成对人类偏好)。
音频-语言基准
MMAU(大规模多音频理解)。 1 万个音频问答对。
MMAU-Pro。 1800 个难题,四个类别:语音 / 声音 / 音乐 / 多音频。四选一随机命中率 25%。Gemini 2.5 Pro 总体约 60%;所有模型在多音频上约 22%。
LongAudioBench。 带语义查询的数分钟片段。Audio Flamingo Next 击败 Gemini 2.5 Pro。
AudioCaps / Clotho。 字幕基准。SPICE、CIDEr、FENSE 指标。
流式语音到语音
延迟 P50 / P95 / P99。 从用户说完到第一个可闻回应的墙钟时间。Moshi:200 ms;GPT-4o Realtime:300 ms。
输出上的 WER / MOS。
插话响应性。 从用户打断到助手静音的时间。目标 < 150 ms。
2026 年的排行榜
| 排行榜 | 赛道 | URL |
|---|---|---|
| Open ASR Leaderboard (HF) | 英语 + 多语种 + 长音频 | huggingface.co/spaces/hf-audio/open_asr_leaderboard |
| TTS Arena (HF) | 英语 TTS | huggingface.co/spaces/TTS-AGI/TTS-Arena |
| Artificial Analysis Speech | TTS + STT,成对投票算 ELO | artificialanalysis.ai/speech |
| MMAU-Pro | LALM 推理 | mmaubenchmark.github.io |
| SpeakerBench / VoxSRC | 说话人识别 | voxsrc.github.io |
| MMAU 音乐子集 | 音乐 LALM | (在 MMAU 内) |
| HEAR benchmark | 自监督音频 | hearbenchmark.com |
sp-wer-align动手构建
第 1 步:带归一化的 WER
from jiwer import wer, Compose, ToLowerCase, RemovePunctuation, Strip

transform = Compose([ToLowerCase(), RemovePunctuation(), Strip()])
score = wer(
    truth="Please turn on the lights.",
    hypothesis="please turn on the light",
    truth_transform=transform,
    hypothesis_transform=transform,
)
# ~0.17
第 2 步:TTS 往返 WER
def ttr_wer(tts_model, asr_model, texts):
    errors = []
    for txt in texts:
        audio = tts_model.synthesize(txt)
        recog = asr_model.transcribe(audio)
        errors.append(wer(truth=txt, hypothesis=recog))
    return sum(errors) / len(errors)
第 3 步:语音克隆的 SECS
from speechbrain.inference.speaker import EncoderClassifier
sv = EncoderClassifier.from_hparams("speechbrain/spkrec-ecapa-voxceleb")

emb_ref = sv.encode_batch(load_wav("reference.wav"))
emb_clone = sv.encode_batch(load_wav("cloned.wav"))
secs = torch.nn.functional.cosine_similarity(emb_ref, emb_clone, dim=-1).item()
第 4 步:音乐生成的 FAD
from frechet_audio_distance import FrechetAudioDistance
fad = FrechetAudioDistance()
score = fad.get_fad_score("generated_folder/", "reference_folder/")
第 5 步:说话人验证的 EER(和第 6 课同样的代码)
def eer(same_scores, diff_scores):
    thresholds = sorted(set(same_scores + diff_scores))
    best = (1.0, 0.0)
    for t in thresholds:
        far = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
        frr = sum(1 for s in same_scores if s < t) / len(same_scores)
        if abs(far - frr) < best[0]:
            best = (abs(far - frr), (far + frr) / 2)
    return best[1]
实际使用
每次部署都配一个固定的评估测试台,每次模型更新都跑。三条铁律:
- 打分前先归一化。 小写化、去标点、展开数字。把归一化规则写清楚。
- 报告分布,不是平均值。 延迟用 P50/P95/P99。分类用各类别召回率。MMAU 用各类别。
- 跑一个经典的公开基准。 即便你的生产数据不同,在 Open ASR / TTS Arena / MMAU 上报告能让评审者苹果对苹果地比较。
坑
- UTMOS 外推。 在 VCTK 风格的干净语音上训练;对嘈杂 / 克隆 / 带情绪的音频打分很差。
- MOS 小组偏差。 20 个 Amazon Mechanical Turk 工人 ≠ 20 个目标用户。利害关系大就花钱请领域小组。
- FAD 取决于参考集。 跨模型对比时用同一个参考分布。
- 汇总 WER。 总体 5% WER 可能掩盖带口音语音上的 30% WER。按人群切片报告。
- 公开基准饱和。 大多数前沿模型在标准基准上接近天花板。建一个反映你流量的内部留出集。
拿去用
存为 outputs/skill-audio-evaluator.md。为任意音频模型发布挑选指标、基准和报告格式。
练习
- 简单。 跑
code/main.py。在玩具输入上计算 WER / CER / EER / SECS / 类 FAD / 类 MMAU。 - 中等。 搭一个 TTS 往返 WER 测试台。把你的 Kokoro 或 F5-TTS 输出过一遍 Whisper。在 50 个 prompt 上算 WER。标出 WER > 10% 的 prompt。
- 困难。 在 MMAU-Pro 的语音 + 多音频子集(各 50 项)上给你第 10 课选的 LALM 打分。报告各类别准确率,并和公布的数字对比。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| WER | ASR 分数 | 归一化后词级别的 (S+D+I)/N。 |
| CER | 字符版 WER | 用于声调语言或字符级系统。 |
| MOS | 人类意见 | 1-5 评分;20+ 名听众 × 100 个样本。 |
| UTMOS | ML MOS 预测器 | 学习得到的模型;与人类 MOS 相关性约 0.9。 |
| SECS | 语音克隆相似度 | 参考和克隆之间的 ECAPA 余弦。 |
| EER | 说话人验证分数 | FAR = FRR 的那个阈值。 |
| DER | 说话人分离分数 | (FA + Miss + Confusion) / total。 |
| FAD | 音乐生成质量 | VGGish 嵌入上的 Fréchet 距离。 |
| RTFx | 吞吐 | 每墙钟秒处理的音频秒数。 |
延伸阅读
- jiwer —— 带归一化工具的 WER/CER 库。
- UTMOS (Saeki et al. 2022) —— 学习得到的 MOS 预测器。
- Fréchet Audio Distance (Kilgour et al. 2019) —— 音乐生成的标准。
- Open ASR Leaderboard —— 2026 年实时排名。
- TTS Arena —— 人类投票的 TTS 排行榜。
- MMAU-Pro benchmark —— LALM 推理排行榜。
- HEAR benchmark —— 音频 SSL 基准。