ControlNet、LoRA 与条件化
光靠文本是一个笨拙的控制信号。ControlNet 让你克隆一个预训练扩散模型,用深度图、姿态骨架、涂鸦或边缘图去操纵它。LoRA 让你只训练 1000 万个参数就微调一个 2B 参数的模型。两者合在一起,把 Stable Diffusion 从玩具变成了 2026 年每家创意公司都在上线的图像流水线。
类型: Build 语言: Python 前置要求: 阶段 8 · 07(潜空间扩散)、阶段 10(从零写 LLM —— 为 LoRA 打基础) 预计时间: ~75 分钟
问题背景
像「一个穿红裙的女人在繁忙的街上遛狗」这样的 prompt,没给模型任何信息:狗在哪、女人是什么姿态、街道的透视是怎样的。文本只钉住了你要指定一张图所需信息的约 10%。剩下的是视觉的,没法用词高效描述。
为每一个信号(姿态、深度、canny、分割)从零训一个新的条件模型代价高得离谱。你想保持那个 2.6B 参数的 SDXL 骨干冻结,挂一个小的旁路网络去读条件,让它去轻推骨干的中间特征。这就是 ControlNet。
你还想教模型新概念(你的脸、你的产品、你的风格),而不重训整个模型。你想要一个小 100 倍的增量。这就是 LoRA——插进现有注意力权重里的低秩适配器。
ControlNet + LoRA + 文本 = 2026 年从业者的工具箱。大多数生产图像流水线在一个 SDXL / SD3 / Flux 基模型上叠 2-5 个 LoRA、1-3 个 ControlNet 和一个 IP-Adapter。
核心概念
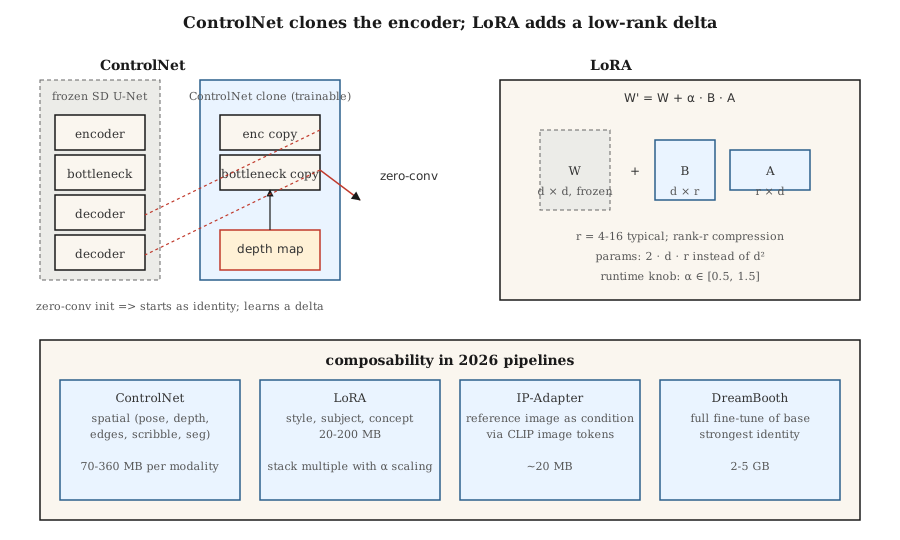
ControlNet(Zhang et al., 2023)
拿一个预训练 SD。克隆 U-Net 的编码器那一半。冻结原始的那个。训练克隆体去接受一个额外的条件输入(边缘、深度、姿态)。用零卷积跳跃连接把克隆体接回原始的解码器那一半(初始化为零的 1×1 卷积——一开始是个空操作,再学一个增量)。
SD U-Net decoder: ... ← orig_enc_features + zero_conv(controlnet_enc(condition))零卷积初始化意味着 ControlNet 一开始就是恒等映射——连训练之前都不会造成伤害。用标准扩散损失在 100 万个(prompt,条件,图像)三元组上训练。
每种模态的 ControlNet 作为小旁路模型发布(SDXL 约 360M,SD 1.5 约 70M)。你可以在推理时把它们组合起来:
features += weight_a * control_a(depth) + weight_b * control_b(pose)LoRA(Hu et al., 2021)
对模型里任意一个线性层 W ∈ R^\{d×d\},冻结 W,加上一个低秩增量:
W' = W + ΔW, ΔW = B @ A, A ∈ R^{r×d}, B ∈ R^{d×r}其中 r << d。注意力用秩 4-16 是标准,重度微调用秩 64-128。新参数量:2 · d · r 而不是 d²。对 SDXL 注意力 d=640、r=16:每个适配器 2 万参数而不是 41 万——少 20 倍。整个模型上看:一个 LoRA 通常是 20-200MB,而基模型是 5GB。
推理时你可以缩放 LoRA:W' = W + α · B @ A。α = 0.5-1.5 是正常的。多个 LoRA 加性叠加(照例提醒一句,它们会以非线性的方式互相作用)。
IP-Adapter(Ye et al., 2023)
一个很小的适配器,接受一张图像作条件(与文本并列)。它用 CLIP 图像编码器产出图像 token,把它们与文本 token 一起注入交叉注意力。每个基模型约 20MB。让你不用 LoRA 就能做「按这张参考图的风格生成一张图」。
可组合性矩阵
| 工具 | 它控制什么 | 大小 | 何时用 |
|---|---|---|---|
| ControlNet | 空间结构(姿态、深度、边缘) | 70-360MB | 精确布局、构图 |
| LoRA | 风格、主体、概念 | 20-200MB | 个性化、风格 |
| IP-Adapter | 从参考图取风格或主体 | 20MB | 没有文本能描述那个样子 |
| Textual Inversion | 把单个概念变成一个新 token | 10KB | 遗产,大多被 LoRA 取代 |
| DreamBooth | 在一个主体上做全量微调 | 2-5GB | 强身份、高算力 |
| T2I-Adapter | 更轻的 ControlNet 替代 | 70MB | 边缘设备、推理预算紧 |
ControlNet ≈ 空间。LoRA ≈ 语义。两个都用。
v4-controlnet-zero动手构建
code/main.py 在一维上模拟这两套机制:
LoRA。 一个预训练线性层
W。冻结它。训一个低秩的B @ A,使W + BA匹配一个目标线性层。证明r = 1就足以完美学出一个秩 1 的修正。ControlNet-lite。 一个「冻结基」预测器和一个读取额外信号的「旁路网络」。旁路网络的输出由一个初始化为零的可学习标量门控(我们这版的零卷积)。训练并看着门慢慢爬升。
第 1 步:LoRA 数学
def lora(W, A, B, x, alpha=1.0):
    # W is frozen; A, B are the trainable low-rank factors.
    return [W[i][j] * x[j] for i, j in ...] + alpha * (B @ (A @ x))
第 2 步:零初始化的旁路网络
side_out = control_net(x, condition)
gated = gate * side_out  # gate initialized to 0
h = base(x) + gated
在第 0 步输出与基模型完全一致。早期训练慢慢更新 gate——没有灾难性漂移。
坑
- 过度缩放 LoRA。
α = 2或α = 3是常见的「让它更强」黑招,会产出过度风格化 / 坏掉的输出。把α保持在≤ 1.5。 - ControlNet 权重冲突。 用一个权重 1.0 的 Pose ControlNet 和一个权重 1.0 的 Depth ControlNet 通常会过冲。权重之和 ≈ 1.0 是个安全默认。
- LoRA 用错了基模型。 SDXL 的 LoRA 在 SD 1.5 上会悄悄变空操作,因为注意力维度对不上。Diffusers 在 0.30+ 会警告。
- Textual Inversion 漂移。 在一个检查点上训的 token 在另一个上会严重漂移。LoRA 更可移植。
- LoRA 权重合并与存储。 你可以把一个 LoRA 烘进基模型权重里以加快推理(运行时不用加),但你就失去了运行时缩放
α的能力。两个版本都留着。
实际使用
| 目标 | 2026 年的流水线 |
|---|---|
| 复现一个品牌的美术风格 | 在约 30 张精选图上训的秩 32 LoRA |
| 把我的脸放进一张生成图里 | DreamBooth 或 LoRA + IP-Adapter-FaceID |
| 特定姿态 + prompt | ControlNet-Openpose + SDXL + 文本 |
| 深度感知的构图 | ControlNet-Depth + SD3 |
| 参考图 + prompt | IP-Adapter + 文本 |
| 精确布局 | ControlNet-Scribble 或 ControlNet-Canny |
| 替换背景 | ControlNet-Seg + Inpainting(第 09 课) |
| 快速一步风格 | 在 SDXL-Turbo 上跑 LCM-LoRA |
拿去用
存为 outputs/skill-sd-toolkit-composer.md。技能接受一个任务(输入素材:prompt、可选参考图、可选姿态、可选深度、可选涂鸦),输出工具栈、权重,以及一套可复现的种子流程。
练习
- 简单。 在
code/main.py里把 LoRA 秩r从 1 变到 4。秩到多少时 LoRA 能精确匹配一个秩 2 的目标增量? - 中等。 在两个目标变换上训两个独立的 LoRA。一起加载它们,展示它们的加性相互作用。这种相互作用什么时候打破线性?
- 困难。 用 diffusers 叠:SDXL-base + Canny-ControlNet(权重 0.8)+ 一个风格 LoRA(α 0.8)+ IP-Adapter(权重 0.6)。随着栈权重变化,测量 FID 与 prompt 遵循之间的权衡。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| ControlNet | 「空间控制」 | 克隆的编码器 + 零卷积跳跃连接;读一张条件图像。 |
| 零卷积 | 「一开始是恒等」 | 初始化为零的 1×1 卷积;ControlNet 一开始是空操作。 |
| LoRA | 「低秩适配器」 | W + B @ A,r << d;参数比全量微调少 100 倍。 |
| 秩 r | 「那个旋钮」 | LoRA 的压缩程度;典型 4-16,重度个性化用 64+。 |
| α | 「LoRA 强度」 | LoRA 增量的运行时缩放。 |
| IP-Adapter | 「参考图像」 | 通过 CLIP 图像 token 实现的小型图像条件适配器。 |
| DreamBooth | 「全量主体微调」 | 在某主体的约 30 张图上训练整个模型。 |
| Textual Inversion | 「新 token」 | 只学一个新词嵌入;遗产,大多被取代。 |
生产笔记:LoRA 热插拔、ControlNet 通道、多租户服务
一个真正的文生图 SaaS 在同一个基检查点上服务数百个 LoRA 和十几个 ControlNet。这个服务问题看起来很像 LLM 多租户(生产文献在连续批处理和 LoRAX / S-LoRA 下讲的是 LLM 那个情形):
- 热插拔 LoRA,别合并。 把
W' = W + α·B·A合进基模型每步推理快约 3-5%,但冻结了α和基模型。把 LoRA 作为秩 r 的增量热驻在显存里;diffusers 暴露了pipe.load_lora_weights()+pipe.set_adapters([...], adapter_weights=[...])来做逐请求激活。切换成本是那2 · d · r · num_layers个权重——MB 量级,亚秒。 - ControlNet 当第二条注意力通道。 克隆的编码器与基模型并行跑。两个权重各 1.0 的 ControlNet = 每步多两次前向,而不是合成一次。批大小余量按平方下降。每个激活的 ControlNet 按约 1.5 倍单步成本预算。
- LoRA 也量化。 如果你量化了基模型(见第 07 课,8GB 上的 Flux),LoRA 增量也能干净地量化到 8-bit 或 4-bit。QLoRA 风格的加载让你能在一个 4-bit Flux 基模型上叠 5-10 个 LoRA 而不爆内存。
Flux 专属:Niels 的 Flux-on-8GB 笔记本把基模型量化到 4-bit;在那个量化基模型上叠一个风格 LoRA(pipe.load_lora_weights("user/style-lora")),用 weight_name="pytorch_lora_weights.safetensors",仍然能工作。这是大多数 SaaS 创意公司 2026 年上线的配方。
延伸阅读
- Zhang, Rao, Agrawala (2023). Adding Conditional Control to Text-to-Image Diffusion Models —— ControlNet。
- Hu et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models —— LoRA(最初为 LLM,可移植到扩散)。
- Ye et al. (2023). IP-Adapter: Text Compatible Image Prompt Adapter —— IP-Adapter。
- Mou et al. (2023). T2I-Adapter: Learning Adapters to Dig Out More Controllable Ability —— 更轻的 ControlNet 替代。
- Ruiz et al. (2023). DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation —— DreamBooth。
- HuggingFace Diffusers — ControlNet / LoRA / IP-Adapter docs —— 参考流水线。