流式语音到语音 —— Moshi、Hibiki,以及全双工对话
2024-2026 重新定义了语音 AI。Moshi 交付了一个单一模型,能以 200 ms 延迟同时听和说。Hibiki 一块一块地做语音到语音翻译。两者都抛弃了 ASR → LLM → TTS 流水线,改用一个在 Mimi 编解码 token 上的统一全双工架构。这是新的参考设计。
类型: Learn 语言: Python 前置要求: 阶段 6 · 13(神经音频编解码)、阶段 6 · 11(实时音频)、阶段 7 · 05(完整 Transformer) 预计时间: ~75 分钟
问题背景
从第 11 + 12 课搭出来的每个语音 agent 都有一个根本的延迟下限,在 300-500 ms 左右:VAD 触发,STT 处理,LLM 推理,TTS 生成。每个阶段都有自己的最小延迟。你可以调优和并行化,但流水线的形状给你封了顶。
Moshi(Kyutai,2024-2026)问了一个不一样的问题:要是没有流水线呢?要是一个模型直接吃音频、吐音频,连续不断地,把文本当成一种中间的「内心独白」而不是必经阶段呢?
答案是全双工语音到语音。理论延迟 160 ms(80 ms Mimi 帧 + 80 ms 声学延迟)。在单张 L4 GPU 上实际延迟 200 ms。这是同级最佳流水线语音 agent 所能达到的一半。
核心概念
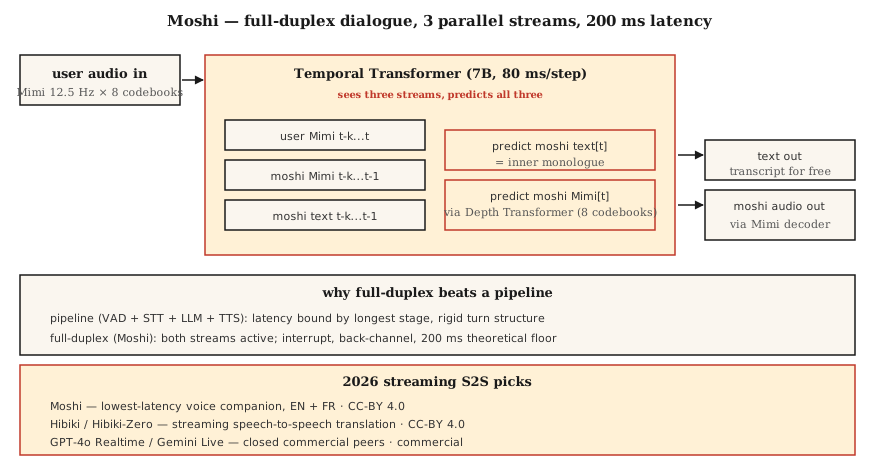
Moshi 架构
输入。 两条 Mimi 编解码流,都是 12.5 Hz × 8 码本:
- 流 1:用户音频(Mimi 编码,持续到来)
- 流 2:Moshi 自己的音频(由 Moshi 生成)
transformer。 一个 7B 参数的时间 Transformer 处理这两条流和一条文本「内心独白」流。在每个 80 ms 步,它:
- 吃进最新的用户 Mimi token(8 码本)。
- 吃进最近的 Moshi Mimi token(8 码本,边产出边吃)。
- 生成下一个 Moshi 文本 token(内心独白)。
- 生成下一批 Moshi Mimi token(通过一个小的深度 Transformer 产出 8 码本)。
三条流——用户音频、Moshi 音频、Moshi 文本——并行运行。Moshi 能在说话的同时听用户;能在用户打断时打断自己;能不打断主话语就插一句应答(「嗯」)。
深度 transformer。 在一帧之内,8 个码本不是并行预测的——它们之间有码本间依赖。一个小的 2 层「深度 transformer」在 80 ms 内顺序预测它们。这是 AR 编解码 LM 的标准因子分解(VALL-E、VibeVoice 也用)。
内心独白文本为什么有帮助
没有显式文本,模型就得在声学流里隐式地建模语言。Moshi 的洞见:强迫它和音频一起吐出文本 token。这条文本流本质上就是 Moshi 正在说的话的转写。它提升语义连贯性,让换语言模型头更容易,还顺手给你白拿转写。
Hibiki:流式语音到语音翻译
同样的架构,在翻译对上训练。源音频进,目标语言音频出,连续不断。Hibiki-Zero(2026 年 2 月)消除了对词级对齐训练数据的需要——用句级数据 + GRPO 强化学习做延迟优化。
最初支持四个语言对;用约 1000 小时就能适配到一种新语言。
更广的 Kyutai 栈(2026)
- Moshi —— 全双工对话(先法语,英语也支持得好)
- Hibiki / Hibiki-Zero —— 同声语音翻译
- Kyutai STT —— 流式 ASR(500 ms 或 2.5 s 前瞻)
- Kyutai Pocket TTS —— 100M 参数 TTS,跑在 CPU 上(2026 年 1 月)
- Unmute —— 在公共服务器上把这些组合起来的完整流水线
L40S GPU 上的吞吐:64 个并发会话,3 倍实时。
Sesame CSM —— 那个表亲
Sesame CSM(2025)用了类似的想法——一个 Llama-3 骨干配 Mimi 编解码头。但 CSM 是单向的(吃上下文 + 文本,产语音),不是全双工。它是市面上「声音临场感」最好的 TTS;和 Moshi 的全双工能力还不太一样。
2026 年性能数字
| 模型 | 延迟 | 用例 | 许可证 |
|---|---|---|---|
| Moshi | 200 ms(L4) | 全双工英 / 法对话 | CC-BY 4.0 |
| Hibiki | 12.5 Hz 帧率 | 法 ↔ 英流式翻译 | CC-BY 4.0 |
| Hibiki-Zero | 同上 | 5 个语言对,无对齐数据 | CC-BY 4.0 |
| Sesame CSM-1B | 200 ms TTFA | 上下文条件 TTS | Apache-2.0 |
| GPT-4o Realtime | ~300 ms | 闭源,OpenAI API | 商用 |
| Gemini 2.5 Live | ~350 ms | 闭源,Google API | 商用 |
sp-fullduplex动手构建
第 1 步:接口
Moshi 暴露一个 WebSocket 服务器,吃 80 ms 块的 Mimi 编码音频,返回 80 ms 块的 Mimi 编码音频。双向。持续不断。
import asyncio
import websockets
from moshi.client_utils import encode_audio_mimi, decode_audio_mimi

async def moshi_chat():
    async with websockets.connect("ws://localhost:8998/api/chat") as ws:
        mic_task = asyncio.create_task(stream_mic_to(ws))
        spk_task = asyncio.create_task(stream_from_to_speaker(ws))
        await asyncio.gather(mic_task, spk_task)
第 2 步:全双工循环
async def stream_mic_to(ws):
    async for chunk_80ms in mic_stream_at_12_5_hz():
        mimi_tokens = encode_audio_mimi(chunk_80ms)
        await ws.send(serialize(mimi_tokens))

async def stream_from_to_speaker(ws):
    async for msg in ws:
        mimi_tokens, text_token = deserialize(msg)
        audio = decode_audio_mimi(mimi_tokens)
        await play(audio)
两个方向同时运行。Python asyncio 或 Rust futures 是标准传输。
第 3 步:训练目标(概念性)
对每个 80 ms 帧 t:
- 输入:
user_mimi[0..t]、moshi_mimi[0..t-1]、moshi_text[0..t-1] - 预测:
moshi_text[t],然后moshi_mimi[t, codebook_0..7]
文本先于音频预测(内心独白);音频在深度 transformer 内按码本顺序预测。
第 4 步:Moshi 哪里赢、哪里不赢
Moshi 赢在:
- 在便宜硬件上端到端亚 250 ms。
- 自然的应答和打断。
- 没有流水线胶水代码。
Moshi 不赢在:
- 工具调用(没为此训练;你需要单独的 LLM 路径)。
- 长推理(Moshi 是个约 8B 的对话模型,不是 Claude/GPT-4)。
- 冷门话题的事实准确性。
- 大多数生产级企业用例(2026 年仍用流水线)。
实际使用
| 情形 | 选 |
|---|---|
| 最低延迟语音伴侣 | Moshi |
| 实时翻译通话 | Hibiki |
| 语音演示 / 研究 | Moshi、CSM |
| 带工具的企业 agent | 流水线(第 12 课),不是 Moshi |
| 上下文中的定制声音 TTS | Sesame CSM |
| 任意语言的语音到语音 | GPT-4o Realtime 或 Gemini 2.5 Live(商用) |
坑
- 工具调用有限。 Moshi 是对话模型,不是 agent 框架。要工具就和流水线结合。
- 特定声音条件化。 Moshi 用单一训练好的人设;克隆是另一次单独训练。
- 语言覆盖。 法语 + 英语极佳;其他有限。Hibiki-Zero 有帮助,但你仍需要训练数据。
- 资源成本。 一个完整的 Moshi 会话占住一个 GPU 槽位;不是廉价的共享多租户部署模式。
拿去用
存为 outputs/skill-duplex-pipeline.md。为一种语音 agent 负载在流水线 vs 全双工架构之间做选择,并给出理由。
练习
- 简单。 跑
code/main.py。它符号化地模拟双流 + 内心独白架构。 - 中等。 从 HuggingFace 拉下 Moshi,跑起服务器,测一段对话。测量从用户说完到 Moshi 开始回应的墙钟延迟。
- 困难。 拿你第 12 课的流水线 agent,在 20 条匹配的测试语音上对比 P50 延迟 vs Moshi。写一段说明:什么情况下流水线在架构上仍然胜出。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 全双工 | 边听边说 | 同一个模型上同时有两条音频流活跃。 |
| 内心独白 | 模型的文本流 | Moshi 和它的音频输出一起吐文本 token。 |
| 深度 transformer | 码本间预测器 | 在一个 80 ms 帧内预测 8 码本的小 transformer。 |
| Mimi | Kyutai 的编解码 | 12.5 Hz × 8 码本;语义+声学;驱动 Moshi。 |
| 流式 S2S | 音频 → 音频实时 | 一块一块的翻译/对话,没有流水线阶段。 |
| 应答(Back-channeling) | 「嗯」式反应 | Moshi 能不打断自己的轮次就发出小的确认。 |
延伸阅读
- Défossez et al. (2024). Moshi — speech-text foundation model —— 那篇论文。
- Kyutai Labs (2026). Hibiki-Zero —— 无对齐数据的流式翻译。
- Sesame (2025). Crossing the uncanny valley of voice —— CSM 规格。
- Kyutai — Moshi repo —— 安装 + 服务器。
- OpenAI — Realtime API —— 闭源商用同行。
- Kyutai — Delayed Streams Modeling —— 底层的 STT/TTS 框架。