长上下文评估 —— NIAH、RULER、LongBench、MRCR
Gemini 3 Pro 宣传 1000 万 token 的上下文。到 100 万 token 时,8 针 MRCR 掉到 26.3%。宣称的 ≠ 可用的。长上下文评估告诉你正在出货的那个模型的真实容量。
类型: Learn 语言: Python 前置要求: Phase 5 · 13(问答)、Phase 5 · 23(分块策略) 预计时间: ~60 分钟
问题背景
你有一份 200 页的合同。模型号称 100 万 token 的上下文。你把合同粘进去,问:"What is the termination clause?"。模型答了——但答的是封面页,因为终止条款埋在 12 万 token 深处,超出了模型实际关注的范围。
这就是 2026 年的上下文容量鸿沟。规格表说 100 万或 1000 万。现实说其中 60-70% 可用,而"可用"取决于任务。
- 检索(haystack 里单针): 在前沿模型上一路到宣称上限都近乎完美。
- 多跳 / 聚合: 在大多数模型上超过约 128k 就急剧退化。
- 在分散事实上推理: 第一个翻车的任务。
长上下文评估测量这些维度。这节课点明各个基准、每个实际测什么,以及如何为你的领域搭一个自定义针测试。
核心概念
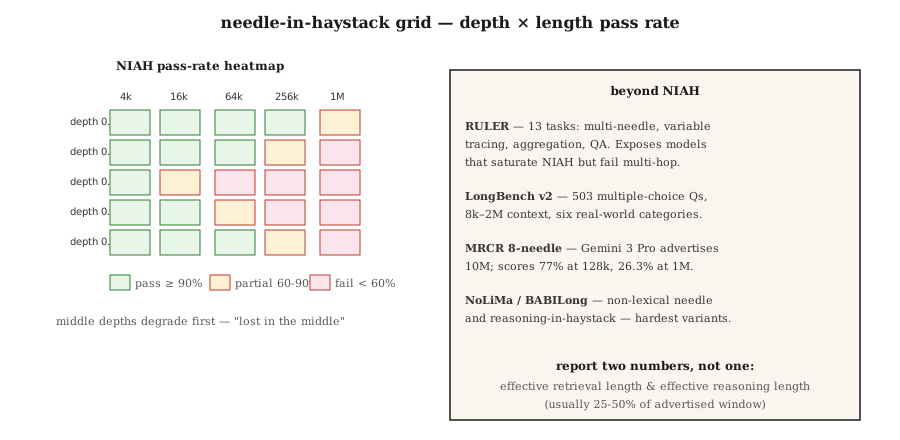
大海捞针(NIAH,2023)。 把一个事实("the magic word is pineapple")放在长上下文里一个受控的深度处。让模型把它检索出来。扫描深度 × 长度。最初的长上下文基准。前沿模型如今已把它刷满;它是必要但不充分的基线。
RULER(Nvidia,2024)。 4 大类下的 13 种任务:检索(单键/多键/多值)、多跳追踪(变量跟踪)、聚合(常见词频)、QA。可配置上下文长度(4k 到 128k+)。揭示那些刷满 NIAH 却在多跳上翻车的模型。在 2024 年的发布里,号称 32k+ 上下文的 17 个模型里,只有一半在 32k 处维持住了质量。
LongBench v2(2024)。 503 道选择题,8k-2M 词的上下文,六个任务类别:单文档 QA、多文档 QA、长上下文学习、长对话、代码仓库、长结构化数据。真实世界长上下文行为的生产基准。
MRCR(多轮共指消解)。 大规模的多轮共指。8 针、24 针、100 针变体。揭示一个模型在注意力退化之前能同时玩转多少个事实。
NoLiMa。 "非词面的针"。针和查询没有字面重叠;检索需要一步语义推理。比 NIAH 更难。
HELMET。 拼接许多文档,从任意一篇里提一个问题。测试选择性注意力。
BABILong。 把 bAbI 推理链嵌进无关的 haystack 里。测试 haystack 里的推理,不只是检索。
真正该报什么
- 宣称的上下文窗口。 规格表上的数字。
- 有效检索长度。 在某个阈值(如 90%)下 NIAH 通过的长度。
- 有效推理长度。 在那个阈值下多跳或聚合通过的长度。
- 退化曲线。 准确率对上下文长度,按任务类型分别画出。
给你规格表的两个数:检索有效和推理有效。通常推理有效是宣称窗口的 25-50%。
gx-niah-decay动手构建
第 1 步:为你的领域做一个自定义 NIAH
见 code/main.py。骨架:
def build_haystack(filler_text, needle, depth_ratio, total_tokens):
    if not (0.0 <= depth_ratio <= 1.0):
        raise ValueError(f"depth_ratio must be in [0, 1], got {depth_ratio}")
    if total_tokens <= 0:
        raise ValueError(f"total_tokens must be positive, got {total_tokens}")

    filler_tokens = tokenize(filler_text)
    needle_tokens = tokenize(needle)
    if not filler_tokens:
        raise ValueError("filler_text produced no tokens")

    # 重复 filler 直到长到能填满 haystack 主体。
    body_len = max(total_tokens - len(needle_tokens), 0)
    while len(filler_tokens) < body_len:
        filler_tokens = filler_tokens + filler_tokens
    filler_tokens = filler_tokens[:body_len]

    insert_at = min(int(body_len * depth_ratio), body_len)
    haystack = filler_tokens[:insert_at] + needle_tokens + filler_tokens[insert_at:]
    return " ".join(haystack)

def score_niah(model, haystack, question, expected):
    answer = model.complete(f"Context: {haystack}\nQ: {question}\nA:", max_tokens=50)
    return 1 if expected.lower() in answer.lower() else 0
扫描 depth_ratio ∈ {0, 0.25, 0.5, 0.75, 1.0} × total_tokens ∈ {1k, 4k, 16k, 64k}。画热力图。那就是你目标模型的 NIAH 卡片。
第 2 步:多针变体
def build_multi_needle(filler, needles, total_tokens):
    depths = [0.1, 0.4, 0.7]
    chunks = [filler[:int(total_tokens * 0.1)]]
    for depth, needle in zip(depths, needles):
        chunks.append(needle)
        next_chunk = filler[int(total_tokens * depth): int(total_tokens * (depth + 0.3))]
        chunks.append(next_chunk)
    return " ".join(chunks)
像 "What are the three magic words?" 这样的问题需要把三个都检索出来。单针成功并不能预测多针成功。
第 3 步:多跳变量追踪(RULER 风格)
haystack = """X1 = 42. ... (filler) ... X2 = X1 + 10. ... (filler) ... X3 = X2 * 2."""
question = "What is X3?"
答案需要把三个赋值串起来。前沿模型在 128k 处这里常掉到 50-70% 准确率。
第 4 步:在你的栈上跑 LongBench v2
from datasets import load_dataset
longbench = load_dataset("THUDM/LongBench-v2")

def eval_model_on_longbench(model, subset="single-doc-qa"):
    tasks = [x for x in longbench["test"] if x["task"] == subset]
    correct = 0
    for x in tasks:
        answer = model.complete(x["context"] + "\n\nQ: " + x["question"], max_tokens=20)
        if normalize(answer) == normalize(x["answer"]):
            correct += 1
    return correct / len(tasks)
报告逐类别准确率。聚合分数藏住了任务级的巨大差异。
坑
- 只做 NIAH 评估。 在 100 万 token 处通过 NIAH,对多跳什么都说明不了。永远跑 RULER 或一个自定义多跳测试。
- 均匀深度采样。 很多实现只测 depth=0.5。测 depth=0, 0.25, 0.5, 0.75, 1.0——"中间迷失"效应是真的。
- 和 filler 的词面重叠。 如果针和 filler 共享关键词,检索就变得平凡。用 NoLiMa 式不重叠的针。
- 忽略延迟。 100 万 token 的 prompt 预填充要 30-120 秒。在准确率之外测量首 token 时间。
- 厂商自报的数字。 OpenAI、Google、Anthropic 都发布自己的分数。永远在你的用例上独立重跑。
实际使用
2026 年的栈:
| 场景 | 基准 |
|---|---|
| 快速合理性检查 | 自定义 NIAH,3 深度 × 3 长度 |
| 生产选型 | 在你目标长度上的 RULER(13 个任务) |
| 真实世界 QA 质量 | LongBench v2 单文档 QA 子集 |
| 多跳推理 | BABILong 或自定义变量追踪 |
| 对话式 | 在你目标长度上的 MRCR 8 针 |
| 模型升级回归 | 固定的内部 NIAH + RULER 测试架,每个新模型都跑 |
生产的经验法则:在你打算用的长度上没跑过 NIAH + 1 个推理任务之前,永远别信一个上下文窗口。
拿去用
存为 outputs/skill-long-context-eval.md:
---
name: long-context-eval
description: Design a long-context evaluation battery for a given model and use case.
version: 1.0.0
phase: 5
lesson: 28
tags: [nlp, long-context, evaluation]
---

Given a target model, target context length, and use case, output:

1. Tests. NIAH depth × length grid; RULER multi-hop; custom domain task.
2. Sampling. Depths 0, 0.25, 0.5, 0.75, 1.0 at each length.
3. Metrics. Retrieval pass rate; reasoning pass rate; time-to-first-token; cost-per-query.
4. Cutoff. Effective retrieval length (90% pass) and effective reasoning length (70% pass). Report both.
5. Regression. Fixed harness, rerun on every model upgrade, surface deltas.

Refuse to trust a context window from the model card alone. Refuse NIAH-only evaluation for any multi-hop workload. Refuse vendor self-reported long-context scores as independent evidence.
练习
- 简单。 搭一个 NIAH,3 深度(0.25, 0.5, 0.75)× 3 长度(1k, 4k, 16k)。在任意模型上跑。把通过率画成 3×3 热力图。
- 中等。 加一个 3 针变体。测量每个长度下三针全检索出来的情况。和同长度的单针通过率对比。
- 困难。 构造一个变量追踪任务(X1 → X2 → X3,3 跳),嵌进 64k 的 filler 里。在 3 个前沿模型上测准确率。报告每个模型的有效推理长度。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| NIAH | 大海捞针 | 在 filler 里埋一个事实,让模型把它检索出来。 |
| RULER | 打了类固醇的 NIAH | 检索 / 多跳 / 聚合 / QA 下的 13 种任务。 |
| 有效上下文 | 真实容量 | 准确率仍维持在阈值以上的长度。 |
| 中间迷失 | 深度偏见 | 模型对长输入中间的内容关注不足。 |
| 多针 | 一次多个事实 | 多处埋点;测注意力玩转能力,不只是检索。 |
| MRCR | 多轮共指 | 8、24 或 100 针共指;揭示注意力饱和。 |
| NoLiMa | 非词面的针 | 针和查询没有字面 token 重叠;需要推理。 |
延伸阅读
- Kamradt (2023). Needle in a Haystack analysis —— 最初的 NIAH 仓库。
- Hsieh et al. (2024). RULER: What's the Real Context Size of Your Long-Context LMs? —— 多任务基准。
- Bai et al. (2024). LongBench v2 —— 真实世界长上下文评估。
- Modarressi et al. (2024). NoLiMa: Non-lexical needles —— 更难的针。
- Kuratov et al. (2024). BABILong —— haystack 里的推理。
- Liu et al. (2024). Lost in the Middle: How Language Models Use Long Contexts —— 深度偏见论文。