注意力机制 —— 那次突破
解码器不再眯着眼盯一个压缩摘要,而是开始看整个源句子。在这之后的一切,都是注意力加工程。
类型: Build 语言: Python 前置要求: Phase 5 · 09(序列到序列模型) 预计时间: ~45 分钟
问题背景
第 09 课收尾在一次量化的失败上。在玩具复制任务上训练的 GRU 编码器-解码器,长度 5 时准确率 89%,到长度 80 时接近随机水平。原因是结构性的,不是训练 bug:编码器搜集到的每一点信息都得塞进一个定长隐藏状态,而解码器再也看不到别的东西。
Bahdanau、Cho 和 Bengio 在 2014 年发表了一个三行修法。别只给解码器最终的编码器状态,把每一个编码器状态都留下来。在每个解码器步骤,计算编码器状态的加权平均,权重说的是"此刻解码器需要看编码器位置 i 多少?"那个加权平均就是上下文,它每个解码器步骤都变。
整个想法就这些。transformer 扩展了它。自注意力把它用在单个序列上。多头注意力并行跑它。但 2014 年那版已经打破了瓶颈,一旦你有了它,转向 transformer 就是工程问题,不是概念问题。
核心概念
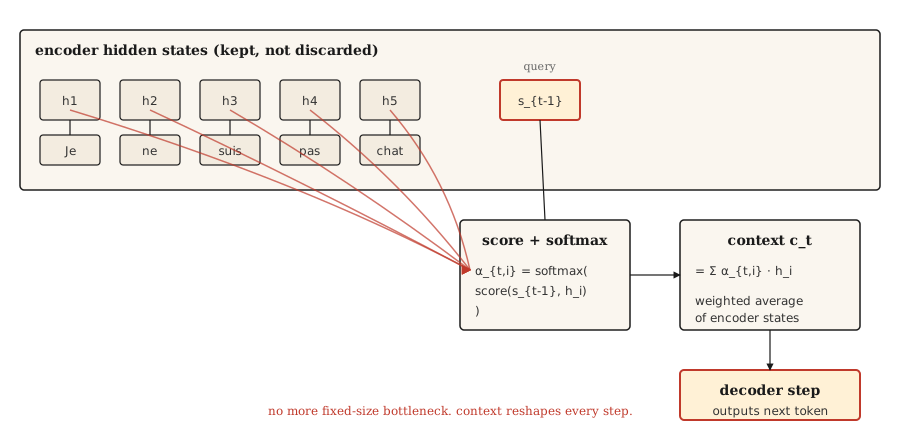
在每个解码器步骤 t:
- 用上一个解码器隐藏状态
s_\{t-1\}作为 query。 - 拿它对每个编码器隐藏状态
h_1, ..., h_T打分。每个编码器位置一个标量。 - 对分数做 softmax,得到求和为 1 的注意力权重
α_\{t,1\}, ..., α_\{t,T\}。 - 上下文向量
c_t = Σ α_\{t,i\} * h_i。编码器状态的加权平均。 - 解码器拿
c_t加上一个输出 token,产出下一个 token。
加权平均是关键。当解码器需要把 "Je" 翻成 "I" 时,它给 "Je" 上的编码器状态高权重、其余低权重。当它需要 "not" 时,给 "pas" 高权重。上下文向量每一步都重新成形。
形状(咬到所有人的那个东西)
这是每个注意力实现第一次都会搞错的地方。慢慢读。
| 东西 | 形状 | 备注 |
|---|---|---|
编码器隐藏状态 H | (T_enc, d_h) | 若是 BiLSTM,d_h = 2 * d_hidden |
解码器隐藏状态 s_\{t-1\} | (d_s,) | 一个向量 |
注意力分数 e_\{t,i\} | 标量 | 每个编码器位置一个 |
注意力权重 α_\{t,i\} | 标量 | 对所有 i 做 softmax 之后 |
上下文向量 c_t | (d_h,) | 和一个编码器状态同形状 |
Bahdanau(加性)打分。 e_\{t,i\} = v_α^T * tanh(W_a * s_\{t-1\} + U_a * h_i)。
s_\{t-1\}形状(d_s,),h_i形状(d_h,)。W_a形状(d_attn, d_s)。U_a形状(d_attn, d_h)。- 它们在 tanh 内的和形状
(d_attn,)。 v_α形状(d_attn,)。与v_α做内积塌缩成一个标量。这就是v_α干的事。 它不是魔法,它是把一个注意力维度向量变成标量分数的那个投影。
Luong(乘性)打分。 三个变体:
dot:e_\{t,i\} = s_t^T * h_i。要求d_s == d_h。硬约束。如果你的编码器是双向的就跳过。general:e_\{t,i\} = s_t^T * W * h_i,W形状(d_s, d_h)。去掉了等维约束。concat:本质上就是 Bahdanau 形式。很少用,因为前两个更便宜。
一个值得点名的 Bahdanau / Luong 坑。 Bahdanau 用 s_\{t-1\}(生成当前词之前的解码器状态)。Luong 用 s_t(之后的状态)。把它们搞混会产出微妙错误的梯度,极难调试。挑一篇论文,守住它的约定。
attention-heatmap动手构建
第 1 步:加性(Bahdanau)注意力
import numpy as np

def additive_attention(decoder_state, encoder_states, W_a, U_a, v_a):
    projected_dec = W_a @ decoder_state
    projected_enc = encoder_states @ U_a.T
    combined = np.tanh(projected_enc + projected_dec)
    scores = combined @ v_a
    weights = softmax(scores)
    context = weights @ encoder_states
    return context, weights

def softmax(x):
    x = x - np.max(x)
    e = np.exp(x)
return e / e.sum()拿上面的表核对你的形状。encoder_states 形状 (T_enc, d_h)。projected_enc 形状 (T_enc, d_attn)。projected_dec 形状 (d_attn,),会广播。combined 形状 (T_enc, d_attn)。scores 形状 (T_enc,)。weights 形状 (T_enc,)。context 形状 (d_h,)。交付。
第 2 步:Luong dot 和 general
def dot_attention(decoder_state, encoder_states):
    scores = encoder_states @ decoder_state
    weights = softmax(scores)
    return weights @ encoder_states, weights

def general_attention(decoder_state, encoder_states, W):
    projected = W.T @ decoder_state
    scores = encoder_states @ projected
    weights = softmax(scores)
    return weights @ encoder_states, weights
各三行。这就是 Luong 那篇论文能站住脚的原因。多数任务上准确率相同,代码少得多。
第 3 步:一个算到底的数值例子
给定三个编码器状态(大致对应 "cat"、"sat"、"mat"),和一个与第一个最对齐的解码器状态,注意力分布集中到位置 0。如果解码器状态转去和最后一个对齐,注意力就移到位置 2。上下文向量随之跟动。
H = np.array([
    [1.0, 0.0, 0.2],
    [0.5, 0.5, 0.1],
    [0.1, 0.9, 0.3],
])

s_close_to_cat = np.array([0.9, 0.1, 0.2])
ctx, w = dot_attention(s_close_to_cat, H)
print("weights:", w.round(3))
weights: [0.464 0.305 0.231]第一行赢。然后把解码器状态挪得更靠近第三个编码器状态,看权重转移。就这么回事。注意力就是显式的对齐。
第 4 步:为什么这是通往 transformer 的桥
把上面的说法翻译成 Q/K/V:
- Query = 解码器状态
s_\{t-1\} - Key = 编码器状态(我们拿来打分的对象)
- Value = 编码器状态(我们加权求和的对象)
在经典注意力里,key 和 value 是同一个东西。自注意力把它们分开:你可以让一个序列查询它自己,K 和 V 用不同的学出来的投影。多头注意力用不同的学出来的投影并行跑它。transformer 把整个阶段堆很多层,并丢掉 RNN。
数学是一样的。形状是一样的。从 Bahdanau 注意力到缩放点积注意力,教学上的跨越主要是记号问题。
实际使用
PyTorch 和 TensorFlow 直接提供注意力。
import torch
import torch.nn as nn

mha = nn.MultiheadAttention(embed_dim=128, num_heads=8, batch_first=True)
query = torch.randn(2, 5, 128)
key = torch.randn(2, 10, 128)
value = torch.randn(2, 10, 128)

output, weights = mha(query, key, value)
print(output.shape, weights.shape)
torch.Size([2, 5, 128]) torch.Size([2, 5, 10])那就是一个 transformer 注意力层。query 批是 5 个位置,key/value 批是 10 个位置,各 128 维,8 个头。output 是新的、被上下文增强过的 query。weights 是你能可视化的那个 5x10 对齐矩阵。
经典注意力仍然要紧的时候
- 教学。单头、单层、基于 RNN 的版本让每个概念都看得见。
- transformer 塞不下的端侧序列任务。
- 任何 2014-2017 年的论文。不懂 Bahdanau 的约定你会读错。
- 机器翻译里的细粒度对齐分析。原始注意力权重即便在 transformer 模型上也是个可解释性工具,而读它需要先懂它是什么。
把注意力权重当解释的陷阱
注意力权重看起来可解释。它们是跨位置求和为一的权重;你能画出来;高就意味着"看了这个"。审稿人很爱它们。
它们没看上去那么可解释。Jain 和 Wallace(2019)证明,对某些任务,注意力分布可以被置换、被任意替代品替换,而不改变模型预测。永远别在没有消融或反事实检查的情况下,把注意力权重当作推理的证据来报。
拿去用
存为 outputs/prompt-attention-shapes.md:
---
name: attention-shapes
description: Debug shape bugs in attention implementations.
phase: 5
lesson: 10
---

Given a broken attention implementation, you identify the shape mismatch. Output:

1. Which matrix has the wrong shape. Name the tensor.
2. What its shape should be, derived from (d_s, d_h, d_attn, T_enc, T_dec, batch_size).
3. One-line fix. Transpose, reshape, or project.
4. A test to catch regressions. Typically: assert `output.shape == (batch, T_dec, d_h)` and `weights.shape == (batch, T_dec, T_enc)` and `weights.sum(dim=-1) close to 1`.

Refuse to recommend fixes that silently broadcast. Broadcast-hiding bugs surface later as silent accuracy degradation, the worst kind of attention bug.

For Bahdanau confusion, insist the decoder input is `s_{t-1}` (pre-step state). For Luong, `s_t` (post-step state). For dot-product, flag dimension mismatch between query and key as the most common first-time error.
练习
- 简单。 实现
softmax掩码,让编码器里的填充 token 注意力权重为零。在一批变长序列上测试。 - 中等。 给 Luong
general形式加上多头注意力。把d_h切成n_heads组,逐头跑注意力,再拼接。验证单头情形和你之前的实现一致。 - 困难。 在第 09 课的玩具复制任务上,训练一个带 Bahdanau 注意力的 GRU 编码器-解码器。画准确率对序列长度的曲线。和无注意力基线对比。你应该看到随长度增长差距拉大,这印证了注意力抬起了那个瓶颈。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| 注意力(Attention) | 看东西 | value 序列的加权平均,权重由 query-key 相似度算出。 |
| Query、Key、Value | QKV | 三个投影:Q 提问,K 是匹配对象,V 是返回内容。 |
| 加性注意力 | Bahdanau | 前馈打分:v^T tanh(W q + U k)。 |
| 乘性注意力 | Luong dot / general | 分数是 q^T k 或 q^T W k。更便宜,多数任务上准确率相同。 |
| 对齐矩阵 | 那张好看的图 | 注意力权重作为一个 (T_dec, T_enc) 网格。读它看模型关注了什么。 |
延伸阅读
- Bahdanau, Cho, Bengio (2014). Neural Machine Translation by Jointly Learning to Align and Translate —— 那篇论文。
- Luong, Pham, Manning (2015). Effective Approaches to Attention-based Neural Machine Translation —— 三种打分变体及其对比。
- Jain and Wallace (2019). Attention is not Explanation —— 可解释性的那个告诫。
- Dive into Deep Learning — Bahdanau Attention —— 配 PyTorch 的可运行讲解。