实时音频处理
批处理流水线处理一个文件。实时流水线要在下一个 20 毫秒到来之前处理完上一个 20 毫秒。每个对话式 AI、广播演播室和电话机器人,成败都系于这个延迟预算。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(频谱图)、阶段 6 · 04(ASR)、阶段 6 · 07(TTS) 预计时间: ~75 分钟
问题背景
你想要一个感觉活着的语音助手。人类对话轮转的延迟约 230 ms(从静音到回应)。超过 500 ms 就显得机械;超过 1500 ms 就像坏了。2026 年一个完整的 听 → 理解 → 回应 → 说 循环的预算是:
| 阶段 | 预算 |
|---|---|
| 麦克风 → 缓冲 | 20 ms |
| VAD | 10 ms |
| ASR(流式) | 150 ms |
| LLM(首 token) | 100 ms |
| TTS(首块) | 100 ms |
| 渲染 → 扬声器 | 20 ms |
| 总计 | ~400 ms |
Moshi(Kyutai,2024)跑出 200 ms 全双工。GPT-4o-realtime(2024)约 320 ms。2022 年的级联流水线上线时是 2500 ms。这 10 倍的提升来自三个技术:(1) 处处流式,(2) 带部分结果的异步流水线,(3) 可打断的生成。
核心概念
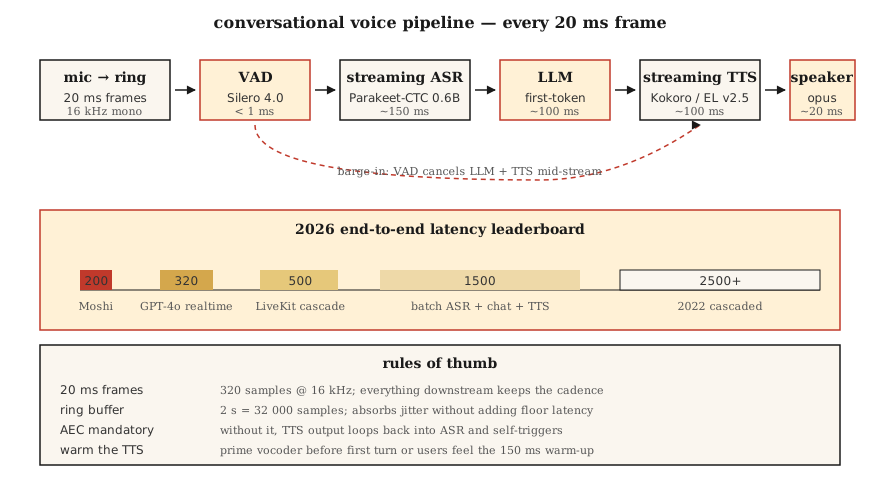
帧 / 块 / 窗。 实时音频以定长块的形式流动。常见选择:20 ms(16 kHz 下 320 个采样点)。下游一切都必须跟上这个节奏。
环形缓冲(Ring buffer)。 定长的循环缓冲。生产者线程写入新帧,消费者线程读取。避免在热路径上分配内存。大小 ≈ 最大延迟 × 采样率;一个 2 秒的 16 kHz 环 = 32,000 个采样点。
VAD(语音活动检测)。 没人说话时给下游工作把门。Silero VAD 4.0(2024)在 CPU 上每 30 ms 帧 <1 ms。webrtcvad 是更老的备选。
流式 ASR。 随音频到达就吐出部分转写的模型。Parakeet-CTC-0.6B 流式模式(NeMo,2024)在 320 ms 延迟下做到 2–5% WER。Whisper-Streaming(Macháček et al., 2023)把 Whisper 分块,在约 2 s 延迟下近似流式。
打断(Interruption)。 用户在助手说话时开口,你必须 (a) 检测到插话,(b) 停掉 TTS,(c) 丢弃剩余的 LLM 输出。全部在 100 ms 内完成,否则用户会觉得助手是个聋子。
WebRTC Opus 传输。 20 ms 帧,48 kHz,自适应码率 8–128 kbps。浏览器和移动端的标准。LiveKit、Daily.co、Pion 是 2026 年构建语音应用的工具栈。
抖动缓冲(Jitter buffer)。 网络包乱序 / 迟到。抖动缓冲重排并平滑;太小 → 可闻断点,太大 → 延迟。典型 60–80 ms。
常见坑
- 线程争用。 Python 的 GIL + 重模型会饿死音频线程。用 C 回调的音频库(sounddevice、PortAudio),让 Python 远离热路径。
- 采样率转换延迟。 流水线内部重采样会加 5–20 ms。要么提前重采样,要么用零延迟重采样器(PolyPhase、
soxr_hq)。 - TTS 预热。 即便是 Kokoro 这样的快 TTS,首次请求也有 100–200 ms 的热身。缓存模型,并在第一个真实轮次前用一次空跑预热它。
- 回声消除。 没有 AEC,TTS 输出会重新进麦克风,触发 ASR 去识别机器人自己的声音。WebRTC AEC3 是开源默认。
nyquist-aliasing动手构建
第 1 步:环形缓冲
import collections

class RingBuffer:
    def __init__(self, capacity):
        self.buf = collections.deque(maxlen=capacity)
    def write(self, frame):
        self.buf.extend(frame)
    def read(self, n):
        return [self.buf.popleft() for _ in range(min(n, len(self.buf)))]
    def level(self):
        return len(self.buf)
容量决定最大缓冲延迟。16 kHz 下 32,000 个采样点 = 2 s。
第 2 步:VAD 闸门
def simple_energy_vad(frame, threshold=0.01):
    return sum(x * x for x in frame) / len(frame) > threshold ** 2
生产环境换成 Silero VAD:
import torch
vad, _ = torch.hub.load("snakers4/silero-vad", "silero_vad")
is_speech = vad(torch.tensor(frame), 16000).item() > 0.5
第 3 步:流式 ASR
# 通过 NeMo 用 Parakeet-CTC-0.6B 流式
from nemo.collections.asr.models import EncDecCTCModelBPE
asr = EncDecCTCModelBPE.from_pretrained("nvidia/parakeet-ctc-0.6b")
# chunk_ms=320 ms, look_ahead_ms=80 ms
for chunk in audio_stream():
    partial_text = asr.transcribe_streaming(chunk)
    print(partial_text, end="\r")
第 4 步:打断处理器
class Dialog:
    def __init__(self):
        self.tts_task = None

    def on_user_speech(self, frame):
        if self.tts_task and not self.tts_task.done():
            self.tts_task.cancel()   # barge-in
        # then feed to streaming ASR

    def on_final_user_utterance(self, text):
        self.tts_task = asyncio.create_task(self.reply(text))

    async def reply(self, text):
        async for tts_chunk in llm_then_tts(text):
            speaker.write(tts_chunk)
关键在异步 I/O 和可取消的 TTS 流。对音频轨调 WebRTC 的 peerconnection.stop() 是经典做法。
实际使用
2026 年的工具栈:
| 层 | 选 |
|---|---|
| 传输 | LiveKit(WebRTC)或 Pion(Go) |
| VAD | Silero VAD 4.0 |
| 流式 ASR | Parakeet-CTC-0.6B 或 Whisper-Streaming |
| LLM 首 token | Groq、Cerebras、vLLM-streaming |
| 流式 TTS | Kokoro 或 ElevenLabs Turbo v2.5 |
| 回声消除 | WebRTC AEC3 |
| 端到端原生 | OpenAI Realtime API 或 Moshi |
坑
- 为保险起见缓冲 500 ms。 缓冲就是你的延迟下限。把它缩小。
- 不固定线程。 音频回调跑在优先级低于 UI 的线程上 = 负载下卡顿。
- TTS 块太小。 小于 200 ms 的块会让声码器瑕疵变得可闻。320 ms 块是甜点。
- 没有抖动缓冲。 真实网络是抖的;不平滑就会有爆音。
- 一次性错误处理。 音频流水线必须抗崩溃。一个异常就杀掉整个会话。
拿去用
存为 outputs/skill-realtime-designer.md。设计一条实时音频流水线,给每个阶段具体的延迟预算。
练习
- 简单。 跑
code/main.py。它模拟一个环形缓冲 + 能量 VAD;为一个假的 10 秒流打印各阶段延迟。 - 中等。 用
sounddevice搭一个直通循环,以 20 ms 帧处理你的麦克风,并在每帧打印 VAD 状态。 - 困难。 用
aiortc搭一个全双工回声测试:浏览器 → WebRTC → Python → WebRTC → 浏览器。用 1 kHz 脉冲测量「玻璃到玻璃」的延迟。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 环形缓冲 | 那个循环队列 | 定长、无锁(或 SPSC 加锁)的音频帧 FIFO。 |
| VAD | 静音闸门 | 标记语音 vs 非语音的模型或启发式。 |
| 流式 ASR | 实时 STT | 随音频到达就吐部分文本;前瞻有界。 |
| 抖动缓冲 | 网络平滑器 | 重排乱序包的队列;典型 60–80 ms。 |
| AEC | 回声消除 | 减掉扬声器到麦克风的反馈路径。 |
| 插话(Barge-in) | 用户打断 | 系统在 TTS 中途检测到用户说话;必须取消播放。 |
| 全双工 | 双向同时 | 用户和机器人能同时说话;Moshi 是全双工。 |
延伸阅读
- Macháček et al. (2023). Whisper-Streaming —— 分块近似流式的 Whisper。
- Kyutai (2024). Moshi —— 全双工 200 ms 延迟。
- LiveKit Agents framework (2024) —— 生产级音频 agent 编排。
- Silero VAD repo —— 亚毫秒 VAD,Apache 2.0。
- WebRTC AEC3 paper —— 开源的回声消除。