语音克隆与语音转换
语音克隆用别人的声音念你的文本。语音转换在保留你说的内容的前提下,把你的声音改写成别人的。两者都挂在同一种分解方式上:把说话人身份和内容分离开。
类型: Build 语言: Python 前置要求: 阶段 6 · 06(说话人识别)、阶段 6 · 07(TTS) 预计时间: ~75 分钟
问题背景
2026 年,用一张消费级 GPU,5 秒音频就足以产出任何人声音的高质量克隆。ElevenLabs、F5-TTS、OpenVoice v2、VoiceBox 全都提供零样本或少样本克隆。这项技术既是福音(无障碍 TTS、配音、辅助发声),也是武器(诈骗电话、政治深伪、知识产权盗窃)。
两个密切相关的任务:
- 语音克隆(TTS 侧): 文本 + 5 秒参考声音 → 用那个声音说出的音频。
- 语音转换(语音侧): 源音频(A 说了 X)+ B 的参考声音 → B 说 X 的音频。
两者都把波形拆解成(内容、说话人、韵律),再把一个来源的内容和另一个来源的说话人重新组合。
2026 年你现在要遵守的关键约束:水印和同意闸门在欧盟(AI 法案,2026 年 8 月起可强制执行)和加州(AB 2905,2025 年生效)是法律要求。你的流水线必须发出一个不可闻的水印,并拒绝未经同意的克隆。
核心概念
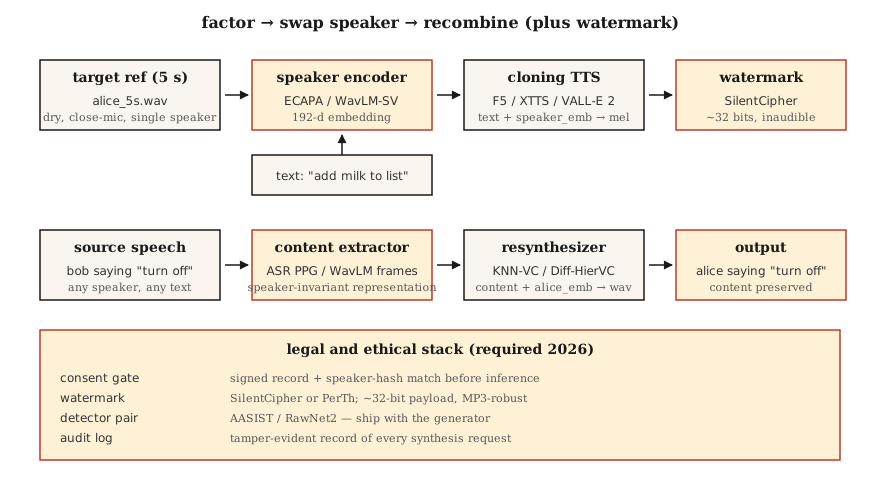
零样本克隆。 把一段 5 秒音频传给一个已在数千说话人上训练过的模型。说话人编码器把这段音频映射成说话人嵌入;TTS 解码器以这个嵌入加文本为条件。
用它的有:F5-TTS(2024)、YourTTS(2022)、XTTS v2(2024)、OpenVoice v2(2024)。
少样本微调。 录目标声音的 5-30 分钟。给基础模型做一小时 LoRA 微调。质量从「还行」跃升到「分不出来」。Coqui 和 ElevenLabs 都支持这种模式;社区拿它配 F5-TTS 用。
语音转换(VC)。 两个流派:
- 识别-合成。 跑一个类 ASR 模型提取内容表示(比如软音素后验、PPG),再用目标说话人嵌入重新合成。对语言和口音鲁棒。KNN-VC(2023)、Diff-HierVC(2023)用的是它。
- 解耦。 训练一个自编码器,在瓶颈处的潜空间里分离内容、说话人和韵律。推理时换掉说话人嵌入。质量更低但更快。AutoVC(2019)、VITS-VC 变体用的是它。
基于神经编解码的克隆(2024 年后)。 VALL-E、VALL-E 2、NaturalSpeech 3、VoiceBox——把音频当成来自 SoundStream / EnCodec 的离散 token,在编解码 token 上训练一个大的自回归或 flow-matching 模型。短 prompt 上质量可与 ElevenLabs 相比。
伦理这块,不是外挂
水印。 PerTh(Perth)和 SilentCipher(2024)在音频里不可感知地嵌入一个约 16-32 比特的 ID。能扛住重新编码、流式传输和常见编辑。生产可用的开源方案。
同意闸门。 必须给每个克隆输出配上一条可验证的同意记录。「我,Rohit,于 2026-04-22,授权此声音用于 X 用途。」存进一个可发现篡改的日志里。
检测。 AASIST、RawNet2 和 Wav2Vec2-AASIST 作为检测器交付。ASVspoof 2025 挑战赛公布的当时最优检测器,对 ElevenLabs、VALL-E 2 和 Bark 输出的 EER 在 0.8–2.3%。
数字(2026)
| 模型 | 零样本? | SECS(与目标相似度) | WER(可懂度) | 参数量 |
|---|---|---|---|---|
| F5-TTS | 是 | 0.72 | 2.1% | 335M |
| XTTS v2 | 是 | 0.65 | 3.5% | 470M |
| OpenVoice v2 | 是 | 0.70 | 2.8% | 220M |
| VALL-E 2 | 是 | 0.77 | 2.4% | 370M |
| VoiceBox | 是 | 0.78 | 2.1% | 330M |
SECS > 0.70 时,对大多数听众来说通常已经和目标分不出来了。
sp-voice-factorize动手构建
第 1 步:用识别-合成做拆解(main.py 里仅代码演示)
def clone_pipeline(ref_audio, text, target_embedder, tts_model):
    speaker_emb = target_embedder.encode(ref_audio)
    mel = tts_model(text, speaker=speaker_emb)
    return vocoder(mel)
概念上简单;实现的分量在 tts_model 和说话人编码器里。
第 2 步:用 F5-TTS 做零样本克隆
from f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
    ref_file="rohit_5s.wav",
    ref_text="The quick brown fox jumps over the lazy dog.",
    gen_text="Please add milk and bread to my list.",
)
参考转写必须和音频完全一致;不匹配会破坏对齐。
第 3 步:用 KNN-VC 做语音转换
import torch
from knnvc import KNNVC  # 2023 model, https://github.com/bshall/knn-vc
vc = KNNVC.load("wavlm-base-plus")
out_wav = vc.convert(source="my_voice.wav", target_pool=["alice_1.wav", "alice_2.wav"])
KNN-VC 跑 WavLM 给源和目标池提取逐帧嵌入,然后把每个源帧替换成它在池里的最近邻。非参数化,用一分钟目标语音就能干。
第 4 步:嵌入水印
from silentcipher import SilentCipher
sc = SilentCipher(model="2024-06-01")
payload = b"consent_id:abc123;ts:1745353200"
watermarked = sc.embed(wav, sr=24000, message=payload)
detected = sc.detect(watermarked, sr=24000)   # returns payload bytes
约 32 比特负载,在 MP3 重新编码和轻度噪声之后仍可检测。
第 5 步:同意闸门
def cloned_inference(text, ref_audio, consent_record):
    assert verify_signature(consent_record), "Signed consent required"
    assert consent_record["speaker_id"] == hash_speaker(ref_audio)
    wav = tts.infer(ref_file=ref_audio, gen_text=text)
    wav = watermark(wav, payload=consent_record["id"])
    return wav
实际使用
2026 年的工具栈:
| 情形 | 选 |
|---|---|
| 5 秒零样本克隆、开源 | F5-TTS 或 OpenVoice v2 |
| 商用生产克隆 | ElevenLabs Instant Voice Clone v2.5 |
| 语音转换(改写) | KNN-VC 或 Diff-HierVC |
| 多说话人微调 | StyleTTS 2 + 说话人适配器 |
| 跨语种克隆 | XTTS v2 或 VALL-E X |
| 深伪检测 | Wav2Vec2-AASIST |
坑
- 参考转写没对齐。 F5-TTS 及同类要求参考文本与参考音频完全一致,标点也算。
- 带混响的参考。 回声会毁掉克隆。干声、近距离收音录制。
- 情绪不匹配。 训练参考是「欢快的」,就会把一切都克隆成欢快的。让参考情绪匹配目标用途。
- 语言泄漏。 克隆一个英语说话人,再让模型说法语,往往还是带着那股口音;用跨语种模型(XTTS、VALL-E X)。
- 没有水印。 从 2026 年 8 月起在欧盟法律上不可交付。
拿去用
存为 outputs/skill-voice-cloner.md。设计一条带同意闸门 + 水印 + 质量目标的克隆或转换流水线。
练习
- 简单。 跑
code/main.py。它通过计算两个「说话人」在交换前后的余弦,演示说话人嵌入交换。 - 中等。 用 OpenVoice v2 克隆你自己的声音。测量参考和克隆之间的 SECS。通过 Whisper 测量 CER。
- 困难。 对 20 个克隆应用 SilentCipher 水印,把它们过一遍 128 kbps 的 MP3 编码+解码,检测负载。报告比特准确率。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 零样本克隆 | 5 秒就够了 | 预训练模型 + 说话人嵌入;不训练。 |
| PPG | 音素后验图 | 逐帧的 ASR 后验,用作与语言无关的内容表示。 |
| KNN-VC | 最近邻转换 | 把每个源帧替换成最近的目标池帧。 |
| 神经编解码 TTS | VALL-E 风格 | 在 EnCodec/SoundStream token 上的 AR 模型。 |
| 水印 | 不可闻的签名 | 嵌入音频里的比特,能扛住重新编码。 |
| SECS | 克隆保真度 | 目标与克隆说话人嵌入之间的余弦。 |
| AASIST | 深伪检测器 | 反欺骗模型;检测合成语音。 |
延伸阅读
- Chen et al. (2024). F5-TTS —— 开源 SOTA 零样本克隆。
- Baevski et al. / Microsoft (2023). VALL-E 和 VALL-E 2 (2024) —— 神经编解码 TTS。
- Qian et al. (2019). AutoVC —— 基于解耦的语音转换。
- Baas, Waubert de Puiseau, Kamper (2023). KNN-VC —— 基于检索的 VC。
- SilentCipher (2024) — Audio Watermarking —— 生产可用的 32 比特音频水印。
- ASVspoof 2025 results —— 检测器与合成器的军备竞赛,2026 年更新。