音频 Transformer —— Whisper 架构
音频是一张频率随时间变化的图像。Whisper 是一个吃 mel 频谱图、再开口说回来的 ViT。
类型: Learn 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 7 · 08(编码器-解码器)、阶段 7 · 09(ViT) 预计时间: ~45 分钟
问题背景
Whisper(OpenAI,Radford et al. 2022)之前,最先进的自动语音识别(ASR)就意味着 wav2vec 2.0 和 HuBERT——自监督特征提取器加一个微调过的头。质量高、数据流水线昂贵、对领域脆弱。多语种语音识别需要每个语系一个单独的模型。
Whisper 下了三个赌注:
- 什么都拿来训。 从互联网上扒来的 68 万小时弱标注音频,横跨 97 种语言。没有干净的学术语料。没有音素标签。
- 多任务单模型。 一个解码器,通过任务 token 联合训练在转录、翻译、语音活动检测、语言识别和时间戳上。
- 标准的编码器-解码器 transformer。 编码器吃 log-mel 频谱图。解码器自回归地产出文本 token。没有声码器,没有 CTC,没有 HMM。
结果是:Whisper large-v3 对口音、噪声以及零干净标注数据的语言都很鲁棒。它是 2026 年每个开源语音助手和大多数商用语音助手的默认语音前端。
核心概念
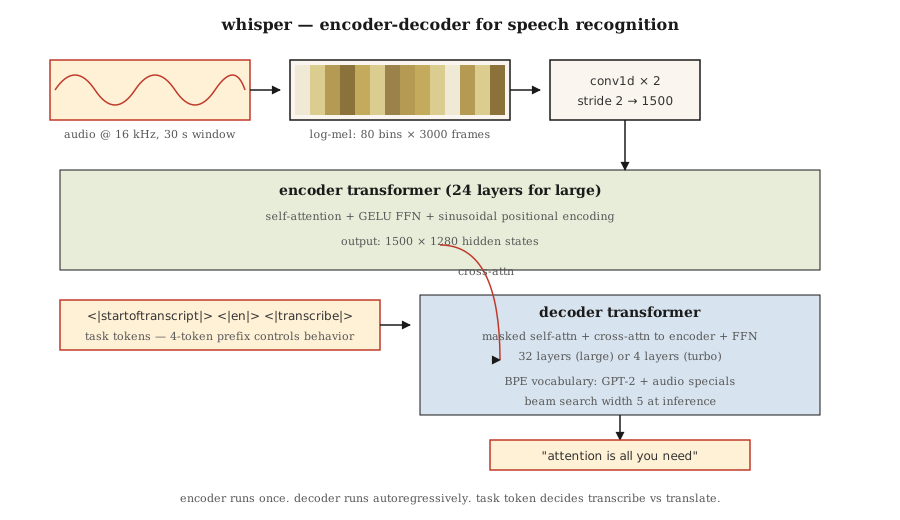
第 1 步 —— 重采样 + 加窗
16 kHz 的音频。裁剪/填充到 30 秒。计算 log-mel 频谱图:80 个 mel bin、10 ms stride → 约 3,000 帧 × 80 个特征。这就是 Whisper 看到的那张"输入图像"。
第 2 步 —— 卷积茎
两个 kernel 为 3、stride 为 2 的 Conv1D 层把 3,000 帧降到 1,500。在不加很多参数的情况下把序列长度减半。
第 3 步 —— 编码器
一个跨 1,500 个时间步的 24 层(large 版)transformer 编码器。正弦位置编码、self-attention、GELU FFN。产出 1,500 × 1,280 的隐藏状态。
第 4 步 —— 解码器
一个 24 层 transformer 解码器。它从一个 BPE 词表自回归地产出 token,这个词表是 GPT-2 词表的超集,外加几个音频专用的特殊 token。
第 5 步 —— 任务 token
解码器 prompt 以控制 token 开头,告诉模型要做什么:
<|startoftranscript|> <|en|> <|transcribe|> <|0.00|>或者
<|startoftranscript|> <|fr|> <|translate|> <|0.00|>模型就是在这个约定上训练的。你用前缀控制任务。相当于 2026 年的指令微调,只是套用到语音上。
第 6 步 —— 输出
带 log-prob 阈值的 beam search(宽度 5)。当 <|notimestamps|> token 不存在时,每 0.02 秒音频预测一个时间戳。
Whisper 各档大小
| 模型 | 参数 | 层数 | d_model | 头数 | 显存(fp16) |
|---|---|---|---|---|---|
| Tiny | 39M | 4 | 384 | 6 | ~1 GB |
| Base | 74M | 6 | 512 | 8 | ~1 GB |
| Small | 244M | 12 | 768 | 12 | ~2 GB |
| Medium | 769M | 24 | 1024 | 16 | ~5 GB |
| Large | 1550M | 32 | 1280 | 20 | ~10 GB |
| Large-v3 | 1550M | 32 | 1280 | 20 | ~10 GB |
| Large-v3-turbo | 809M | 32 | 1280 | 20 | ~6 GB(4 层解码器) |
Large-v3-turbo(2024)把解码器从 32 层砍到 4 层。解码快 8 倍,WER 回退不到 1 个点。正是这个解码速度的解锁,让 Whisper-turbo 成了 2026 年实时语音 agent 的默认。
Whisper 不做什么
- 不做说话人分离(谁在说话)。要这个就配 pyannote。
- 原生不做实时流式——30 秒窗口是固定的。现代封装(
faster-whisper、WhisperX)通过 VAD + 重叠来加上流式。 - 不做超出 30 秒、没有外部分块的长篇上下文。实践中效果很好,因为人类语音转录很少需要长程上下文。
2026 年格局
| 任务 | 模型 | 备注 |
|---|---|---|
| 英语 ASR | Whisper-turbo、Moonshine | Moonshine 在边缘上快 4 倍 |
| 多语种 ASR | Whisper-large-v3 | 97 种语言 |
| 流式 ASR | faster-whisper + VAD | 150 ms 延迟目标可达 |
| TTS | Piper、XTTS-v2、Kokoro | 编码器-解码器模式,但是 Whisper 形状 |
| 音频 + 语言 | AudioLM、SeamlessM4T | 文本 token + 音频 token 在一个 transformer 里 |
n5-mel-decode动手构建
见 code/main.py。我们不训练 Whisper——我们搭 log-mel 频谱图流水线 + 任务 token prompt 格式器。这些才是你在生产里真正会碰的部分。
第 1 步:合成音频
生成一个 1 秒、440 Hz、按 16 kHz 采样的正弦波。16,000 个采样点。
第 2 步:log-mel 频谱图(简化版)
完整的 mel 频谱图需要 FFT。我们做一个简化的分帧 + 每帧能量版本,展示流水线而不需要 librosa:
def frame_signal(x, frame_size=400, hop=160):
    frames = []
    for start in range(0, len(x) - frame_size + 1, hop):
        frames.append(x[start:start + frame_size])
    return frames
帧 = 25 ms,hop = 10 ms。和 Whisper 的加窗一致。教学上用每帧能量替代 mel bin。
第 3 步:填充到 30 秒
Whisper 总是处理 30 秒的块。把频谱图填充(或裁剪)到 3,000 帧。
第 4 步:构建 prompt token
def whisper_prompt(lang="en", task="transcribe", timestamps=True):
    tokens = ["<|startoftranscript|>", f"<|{lang}|>", f"<|{task}|>"]
    if not timestamps:
        tokens.append("<|notimestamps|>")
    return tokens
这就是整个任务控制面。一个 4 token 的前缀。
实际使用
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("meeting.wav", language="en", task="transcribe")
print(result["text"])
print(result["segments"][0]["start"], result["segments"][0]["end"])
更快的、OpenAI 兼容的:
from faster_whisper import WhisperModel
model = WhisperModel("large-v3-turbo", compute_type="int8_float16")
segments, info = model.transcribe("meeting.wav", vad_filter=True)
for s in segments:
    print(f"{s.start:.2f} - {s.end:.2f}: {s.text}")
2026 年什么时候选 Whisper:
- 用一个模型搞定多语种 ASR。
- 对嘈杂、多样的音频做鲁棒转录。
- 研究 / 原型 ASR——最快的起点。
什么时候选别的:
- 边缘上的超低延迟流式——同等质量下 Moonshine 打败 Whisper。
- 需要 <200 ms 的实时对话 AI——专用流式 ASR。
- 说话人分离——Whisper 不做这个;加上 pyannote。
拿去用
见 outputs/skill-asr-configurator.md。这个 skill 为一个新的语音应用挑选 ASR 模型、解码参数和预处理流水线。
练习
- 简单。 跑
code/main.py。确认 16 kHz、10 ms hop 下一个 1 秒信号的帧数约为 100 帧。30 秒:约 3,000 帧。 - 中等。 用
numpy.fft构建完整的 log-mel 频谱图。验证 80 个 mel bin 在数值误差内匹配librosa.feature.melspectrogram(n_mels=80)。 - 困难。 实现流式推理:把音频切成 10 秒窗口、2 秒重叠,对每个块跑 Whisper,合并转录。在一段 5 分钟的播客样本上,测词错误率相比单次通过的差异。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| Mel 频谱图 | "音频图像" | 二维表示:一个轴是频率 bin,另一个是时间帧;每格是 log 缩放的能量。 |
| Log-mel | "Whisper 看到的东西" | 过了 log 的 mel 频谱图;近似人对响度的感知。 |
| 帧 | "一个时间切片" | 一个 25 ms 的采样窗口;以 10 ms stride 重叠。 |
| 任务 token | "语音的 prompt 前缀" | 解码器 prompt 里像 `< |
| 语音活动检测(VAD) | "找出语音" | ASR 前去掉静音的门控;大幅削减成本。 |
| CTC | "Connectionist Temporal Classification" | 经典 ASR 损失,用于无对齐训练;Whisper 不用它。 |
| Whisper-turbo | "小解码器,完整编码器" | large-v3 编码器 + 4 层解码器;解码快 8 倍。 |
| Faster-whisper | "生产封装" | CTranslate2 重实现;int8 量化;比 OpenAI 参考实现快 4 倍。 |
延伸阅读
- Radford et al. (2022). Robust Speech Recognition via Large-Scale Weak Supervision —— Whisper 论文。
- OpenAI Whisper repo —— 参考代码 + 模型权重。读
whisper/model.py,约 400 行里从头到尾看到 Conv1D 茎 + 编码器 + 解码器。 - OpenAI Whisper —
whisper/decoding.py—— 第 5–6 步描述的 beam-search + 任务 token 逻辑在这里;500 行,完全可读。 - Baevski et al. (2020). wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations —— 前身;在某些场景下仍是 SOTA 特征。
- SYSTRAN/faster-whisper —— 生产封装,比参考实现快 4 倍。
- Jia et al. (2024). Moonshine: Speech Recognition for Live Transcription and Voice Commands —— 2024 年对边缘友好的 ASR,Whisper 形状但更小。
- HuggingFace blog —— "Fine-Tune Whisper For Multilingual ASR with 🤗 Transformers" —— 规范的微调配方,含 mel 频谱图预处理器和 token 时间戳处理。
- HuggingFace
modeling_whisper.py—— 完整实现(编码器、解码器、cross-attention、生成),与本课的架构图对应。