Mixture of Experts (MoE)
一个稠密的 70B transformer 对每个 token 都激活全部参数。一个 671B 的 MoE 每个 token 只激活 37B,却在每个基准上打败它。稀疏是这十年最重要的 scaling 想法。
类型: Build 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 7 · 07(GPT) 预计时间: ~45 分钟
问题背景
稠密 transformer 推理时的 FLOPs 等于它的参数量(前向通过乘 2)。把稠密模型放大,每个 token 都付全额账单。到 2024 年,前沿撞上了一堵算力墙:要变得有意义地更聪明,每 token 需要指数级更多的 FLOPs。
Mixture of Experts 打断了这个绑定。把每个 FFN 换成 E 个独立专家 + 一个为每个 token 挑 k 个专家的路由器。总参数 = E × FFN_size。每 token 激活参数 = k × FFN_size。2026 年典型配置:E=256、k=8。存储随 E 增长,算力随 k 增长。
2026 年的前沿几乎全是 MoE:DeepSeek-V3(671B 总 / 37B 激活)、Mixtral 8×22B、Qwen2.5-MoE、Llama 4、Kimi K2、gpt-oss。在 Artificial Analysis 的独立排行榜上,前 10 个开源模型全是 MoE。
核心概念
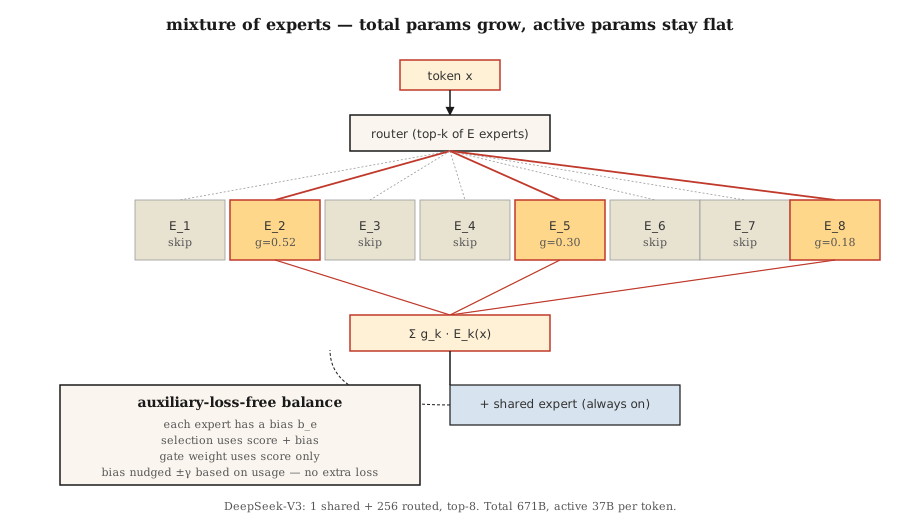
FFN 替换
稠密 transformer block:
h = x + attn(norm(x))
h = h + FFN(norm(h))
MoE block:
h = x + attn(norm(x))
scores = router(norm(h))              # (N_tokens, E)
top_k = argmax_k(scores)              # 为每个 token 从 E 个里选 k 个
h = h + sum_{e in top_k}(
        gate(scores[e]) * Expert_e(norm(h))
    )
每个专家都是一个独立的 FFN(通常是 SwiGLU)。路由器是单个线性层。每个 token 挑自己的 k 个专家,得到它们输出的门控混合。
负载均衡问题
如果路由器把 90% 的 token 都送进专家 3,其他专家就饿死了。试过三种修法:
- 辅助负载均衡损失(Switch Transformer、Mixtral)。加一个与专家使用率方差成比例的惩罚。有效,但多了一个超参和第二个梯度信号。
- 专家容量 + token 丢弃(早期 Switch)。每个专家最多处理
C × N/E个 token;溢出的 token 跳过这一层。伤质量。 - 无辅助损失均衡(DeepSeek-V3)。给每个专家加一个学到的偏置,移动路由器的 top-k 选择。偏置在训练损失之外更新。对主目标无惩罚。2024 年的大解锁。
DeepSeek-V3 的做法:每个训练步之后,对每个专家,检查它的使用率高于还是低于目标。把偏置推 ±γ。选择用 scores + bias。门控用的专家概率是原始 scores,不变。把路由和表达解耦了。
共享专家
DeepSeek-V2/V3 还把专家分成共享和路由两类。每个 token 都过所有共享专家。路由专家通过 top-k 挑选。共享专家捕捉通用知识;路由专家专精。V3 跑 1 个共享专家加上从 256 个路由专家里选 top-8。
细粒度专家
经典 MoE(GShard、Switch):每个专家和一个完整 FFN 一样宽。E 小(8–64),k 小(1–2)。
现代细粒度 MoE(DeepSeek-V3、Qwen-MoE):每个专家更窄(1/8 FFN 大小)。E 大(256+),k 更大(8+)。同样的总参数,但组合数扩展快得多。每个 token 有 C(256, 8) = 400 trillion 种可能的"专家"。质量上去,延迟不动。
成本画像
每 token、每层:
| 配置 | 每 token 激活参数 | 总参数 |
|---|---|---|
| Mixtral 8×22B | ~39B | 141B |
| Llama 3 70B(稠密) | 70B | 70B |
| DeepSeek-V3 | 37B | 671B |
| Kimi K2(MoE) | ~32B | 1T |
DeepSeek-V3 在几乎每个基准上打败 Llama 3 70B(稠密),同时每 token 做更少的激活 FLOPs。参数越多 = 知识越多。激活 FLOPs 越多 = 每 token 算力越多。MoE 把两者解耦了。
代价在哪:显存
不管哪些专家点火,所有专家都活在 GPU 上。一个 671B 模型的 fp16 权重需要约 1.3 TB 显存。前沿 MoE 部署需要专家并行——把专家分片到多个 GPU,让 token 跨网络路由。延迟由全对全通信主导,不是 matmul。
expert-routing动手构建
见 code/main.py。一个紧凑的纯标准库 MoE 层,含:
n_experts=8个类 SwiGLU 专家(每个一个线性层,用于演示)- top-k=2 路由
- softmax 归一化的门控权重
- 通过每专家偏置实现的无辅助损失均衡
第 1 步:路由器
def route(hidden, W_router, top_k, bias):
    scores = [sum(h * w for h, w in zip(hidden, W_router[e])) for e in range(len(W_router))]
    biased = [s + b for s, b in zip(scores, bias)]
    top_idx = sorted(range(len(biased)), key=lambda i: -biased[i])[:top_k]
    # 对所选专家的“原始” scores 做 softmax
    chosen = [scores[i] for i in top_idx]
    m = max(chosen)
    exps = [math.exp(c - m) for c in chosen]
    s = sum(exps)
    gates = [e / s for e in exps]
    return top_idx, gates
偏置影响选择,不影响门控权重。这就是 DeepSeek-V3 的把戏——偏置纠正负载不均,而不引导模型的预测。
第 2 步:把 100 个 token 过一遍路由器
追踪哪些专家点火多频繁。没有偏置时,使用率是偏斜的。加上偏置更新循环(过度使用的专家 -γ、使用不足的 +γ),使用率在几次迭代里收敛到均匀分布。
第 3 步:参数量对比
打印一个 MoE 配置的"稠密等价"。DeepSeek-V3 形状:256 个路由 + 1 个共享,8 个激活,d_model=7168。总参数量令人咋舌。激活量是稠密 Llama 3 70B 的七分之一。
实际使用
HuggingFace 加载:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x22B-v0.1")
2026 年生产推理:vLLM 原生支持 MoE 路由。SGLang 有最快的专家并行路径。两者都自动处理 top-k 选择和专家并行。
什么时候选 MoE:
- 你想要前沿质量、更低的每 token 推理成本。
- 你有显存 / 专家并行基础设施。
- 你的负载是 token 密集(聊天、代码)而非上下文密集(长文档)。
什么时候别选 MoE:
- 边缘部署——任何激活 FLOP 你都要付全额存储。
- 延迟关键的单用户服务——专家路由增加开销。
- 小模型(<7B)——MoE 的质量优势只在某个算力阈值(~6B 激活参数)以上才出现。
拿去用
见 outputs/skill-moe-configurator.md。这个 skill 会根据参数预算、训练 token 数和部署目标,为一个新 MoE 挑选 E、k 和共享专家布局。
练习
- 简单。 跑
code/main.py。观察无辅助损失偏置更新如何在 50 次迭代里抹平专家使用率。 - 中等。 把学习式路由器换成基于哈希的路由器(确定性,无学习)。对比质量和均衡。为什么学习式路由器更好?
- 困难。 实现 GRPO 风格的"rollout 匹配路由"(DeepSeek-V3.2 把戏):记录推理时哪些专家点火,在梯度计算时强制同样的路由。在一个玩具策略梯度设置上测它的效果。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 专家 | "众多 FFN 之一" | 一个独立的前馈网络;专用于 FFN 计算稀疏切片的参数。 |
| 路由器 | "那个门" | 一个微小的线性层,给每个 token 对每个专家打分;top-k 选择。 |
| Top-k 路由 | "每 token k 个激活专家" | 每个 token 的 FFN 计算恰好过 k 个专家,按门控加权。 |
| 辅助损失 | "负载均衡惩罚" | 惩罚偏斜专家使用率的额外损失项。 |
| 无辅助损失 | "DeepSeek-V3 的把戏" | 只通过路由器选择上的每专家偏置来均衡;无额外梯度。 |
| 共享专家 | "总是开着" | 每个 token 都过的额外专家;捕捉通用知识。 |
| 专家并行 | "按专家分片" | 把不同专家分到不同 GPU;让 token 跨网络路由。 |
| 稀疏度 | "激活参数 < 总参数" | 比值 k × expert_size / (E × expert_size);DeepSeek-V3 是 37/671 ≈ 5.5%。 |
延伸阅读
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer —— 这个想法。
- Fedus, Zoph, Shazeer (2022). Switch Transformer: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity —— Switch,经典 MoE。
- Jiang et al. (2024). Mixtral of Experts —— Mixtral 8×7B。
- DeepSeek-AI (2024). DeepSeek-V3 Technical Report —— MLA + 无辅助损失 MoE + MTP。
- Wang et al. (2024). Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts —— 基于偏置的均衡论文。
- Dai et al. (2024). DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models —— 本课路由器用的细粒度 + 共享专家划分。
- Kim et al. (2022). DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training —— 最初的共享专家论文。