生成模型 —— 分类与历史
每一个图像模型、文本模型、视频模型、3D 模型,都能归进五个桶里的某一个。选错桶,你会跟数学搏斗好几周;选对桶,这个领域过去十二年的进展会清清楚楚地在你脑子里摞起来。
类型: Learn 语言: Python 前置要求: 阶段 2(机器学习基础)、阶段 3(深度学习核心)、阶段 7 · 14(Transformers) 预计时间: ~45 分钟
问题背景
一个生成模型只干一件事:给定从某个未知分布 p_data(x) 采样出来的训练样本,输出看起来像是从同一个分布里来的新样本。人脸、句子、MIDI 文件、蛋白质结构——眯起眼看,全是同一个问题。
难就难在 p_data 住在一个有几百万维的空间里(一张 512x512 的 RGB 图就有约 78.6 万维),样本挤在那个空间内部一层薄薄的流形上,而你手里顶多也就 1000 万个样本。硬算这个密度是没指望的。每一个生成模型都是一种妥协,把一个难题换成一个稍微没那么难的题。
过去十二年里活下来的家族有五个。知道每个家族做的是哪种妥协,你就明白它为什么在某些任务上赢、在另一些任务上崩。
核心概念
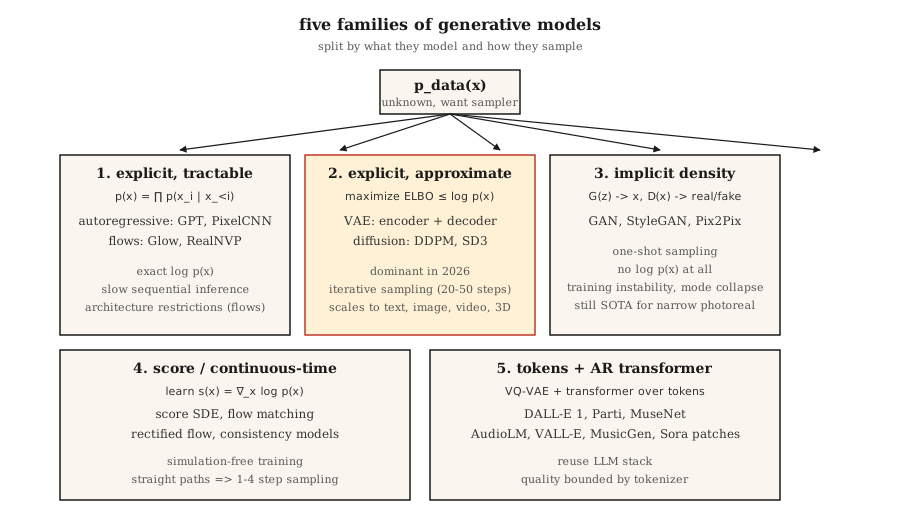
1. 显式密度,可解。 把 log p(x) 写成一个你真能算出来的和式。自回归模型(PixelCNN、WaveNet、GPT)把 p(x) = ∏ p(x_i | x_<i) 拆开。归一化流(RealNVP、Glow)把 p(x) 构造成对一个简单基分布的可逆变换。优点:似然精确,训练损失干净。缺点:自回归推理是顺序的(长序列就慢),流需要可逆架构(架构上受限)。
2. 显式密度,近似。 给 log p(x) 找一个下界(ELBO),然后优化这个界。VAE(Kingma 2013)用一个带变分后验的编码器-解码器。扩散模型(DDPM,Ho 2020)训练一个去噪器,隐式地优化一个加权 ELBO。到 2026 年,扩散是图像、视频、3D 的主流骨干。
3. 隐式密度。 干脆绕开密度;学一个生成器 G(z) 来产样本,再学一个判别器 D(x) 来分辨真假。GAN(Goodfellow 2014)。推理快(一次前向就行),但训练时出了名地不稳定。即便到了 2026 年,StyleGAN 1/2/3 在固定领域的写实度上(人脸、卧室)仍是顶尖水平。
4. 基于分数 / 连续时间。 直接学对数密度的梯度 ∇_x log p(x)(即分数)。Song 与 Ermon(2019)证明分数匹配能把扩散推广成一个 SDE。流匹配(Lipman 2023)是 2024-2026 年的当红选手:免仿真训练、路径更直、采样比 DDPM 快 4-10 倍。Stable Diffusion 3、Flux、AudioCraft 2 全都用流匹配。
5. 在离散码上做基于 token 的自回归。 先用 VQ-VAE 或残差量化器把高维数据压成一小串离散 token,再用一个 Transformer 给这串 token 序列建模。Parti、MuseNet、AudioLM、VALL-E、Sora 的 patch 分词器都是这一路。这就是第 1 桶外加一个学出来的分词器。
一段简史
| 年份 | 模型 | 它为什么重要 |
|---|---|---|
| 2013 | VAE(Kingma) | 第一个带可用训练损失的深度生成模型。 |
| 2014 | GAN(Goodfellow) | 隐式密度,不算似然——样本却锐得吓人。 |
| 2015 | DRAW、PixelCNN | 顺序图像生成。 |
| 2017 | Glow、RealNVP | 可逆流;带深度的精确似然。 |
| 2017 | Progressive GAN | 第一批百万像素人脸。 |
| 2019 | StyleGAN / StyleGAN2 | 写实人脸,单论这个领域至今仍难被超越。 |
| 2020 | DDPM(Ho) | 扩散变得实用。 |
| 2021 | CLIP、DALL-E 1、VQGAN | 文生图走向主流。 |
| 2022 | Imagen、Stable Diffusion 1、DALL-E 2 | 潜空间扩散 + 文本条件 = 大白菜化。 |
| 2022 | ControlNet、LoRA | 对预训练扩散模型的精细控制。 |
| 2023 | SDXL、Midjourney v5、流匹配 | 规模 + 更好的训练动态。 |
| 2024 | Sora、Stable Diffusion 3、Flux.1 | 视频扩散;流匹配胜出。 |
| 2025 | Veo 2、Kling 1.5、Runway Gen-3、Nano Banana | 生产级视频。 |
| 2026 | Consistency + Rectified Flow | 从扩散骨干做一步采样。 |
五问分诊法
每当一篇新的生成模型论文出现,在读方法章节之前先回答这五个问题。
- 建模的是什么? 像素、潜变量、离散 token、3D 高斯、网格、波形?
- 密度是显式还是隐式? 他们有没有把
log p(x)写出来? - 采样:一次到位还是迭代? 迭代意味着推理更慢;一次到位通常意味着对抗式或被蒸馏过。
- 条件:无条件、类别、文本、图像、姿态? 这决定了损失和架构脚手架。
- 评测:FID、CLIP 分数、IS、人类偏好、任务准确率? 每个都有已知的失效模式(见第 14 课)。
本阶段的每一课你都会重新回答这五个问题。到最后,它们会变成条件反射。
autoencoder-bottleneck动手构建
本课的代码是一个轻量可视化:用三种玩具方法(核密度、离散直方图,以及一个取最近样本的「类 GAN」生成器)从样本里拟合一个一维高斯混合,让你在一个能塞进一屏的问题上看清显式密度与隐式密度的区别。
运行 code/main.py。它从一个双峰高斯混合里抽 2000 个样本,然后打印:
explicit density (histogram): p(x in [-0.5, 0.5]) ≈ 0.38
approximate density (KDE):     p(x in [-0.5, 0.5]) ≈ 0.41
implicit (nearest-sample gen): 20 new samples printed, no p(x)注意:前两种让你能问「这个点出现的概率有多大?」第三种不能。这就是显式与隐式的区别,它会在未来每一课里都起作用。
实际使用
2026 年,哪个家族配哪个任务?
| 任务 | 最佳家族 | 原因 |
|---|---|---|
| 写实人脸、窄领域 | StyleGAN 2/3 | 仍然最锐,推理最快。 |
| 通用文生图 | 潜空间扩散 + 流匹配 | SD3、Flux.1、DALL-E 3。 |
| 快速文生图 | Rectified flow + 蒸馏 | SDXL-Turbo、SD3-Turbo、LCM。 |
| 文生视频 | Diffusion Transformer + 流匹配 | Sora、Veo 2、Kling。 |
| 语音 + 音乐 | 基于 token 的自回归(AudioLM、VALL-E、MusicGen)或流匹配(AudioCraft 2) | 离散 token 扩展起来便宜。 |
| 3D 场景 | 高斯泼溅拟合,扩散先验 | 3D-GS 做重建,扩散做新视角。 |
| 密度估计(不采样) | 流 | 唯一能给出精确 log p(x) 的家族。 |
| 仿真 / 物理 | 流匹配、score SDE | 直线路径,平滑向量场。 |
拿去用
存为 outputs/skill-model-chooser.md。
这个技能接受一段任务描述,输出:(1) 该用哪个家族,(2) 一份排好序的清单,三个开源、三个托管的选项,(3) 你该提防的可能失效模式,(4) 一份算力/时间预算。
练习
- 简单。 对这五个产品,分别指出它的家族和骨干:ChatGPT 图像、Midjourney v7、Sora、Runway Gen-3、ElevenLabs。证据应来自公开的技术报告。
- 中等。 你明天要读的那篇论文宣称采样比扩散快 100 倍。写下三个问题,用来核查这个加速在加上条件和高分辨率之后还撑不撑得住。
- 困难。 挑一个你在意的领域(比如蛋白质结构、CAD、分子、轨迹)。为这个领域当前的 SOTA 模型回答五问分诊,并勾勒出一个更好的模型会改变什么。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 生成模型 | 「它能造新东西」 | 为 p_data(x) 学一个采样器,可选地暴露出 log p(x)。 |
| 显式密度 | 「你能把它算出来」 | 模型提供一个闭式或可解的 log p(x)。 |
| 隐式密度 | 「GAN 那套」 | 只有一个采样器——没法算某个给定点的 p(x)。 |
| ELBO | 「证据下界」 | log p(x) 的一个可解下界;VAE 和扩散都在优化它。 |
| 分数(Score) | 「对数密度的梯度」 | ∇_x log p(x);扩散和 SDE 模型学的就是这个场。 |
| 流形假设 | 「数据住在一个曲面上」 | 高维数据集中在一个低维流形上;这也是为什么降维有效。 |
| 自回归 | 「预测下一块」 | 把联合分布拆成条件分布的乘积。 |
| 潜变量(Latent) | 「压缩后的码」 | 一种低维表示,解码器能从中重建出输入。 |
生产笔记:五个家族,五种推理形态
每个家族对应一条不同的推理服务器成本曲线。生产推理的文献把 LLM 推理拆成 prefill + decode;同样的分解在这里也适用:
- 自回归(第 1 桶和第 5 桶)。 顺序 decode 主导延迟;KV-cache、连续批处理、推测解码全都能直接套用。
- VAE / 扩散 / 流匹配(第 2 桶和第 4 桶)。 没有 LLM 意义上的 decode。成本 =
num_steps × step_cost,而step_cost是在完整潜空间分辨率上跑一次 transformer 或 U-Net 前向。生产上的旋钮是步数(DDIM / DPM-Solver / 蒸馏)、批大小和精度(bf16 / fp8 / int4)。 - GAN(第 3 桶)。 一次前向。没有调度,没有 KV-cache。TTFT ≈ 总延迟。这就是为什么 StyleGAN 在窄领域的交互体验上仍然占优。
当你在论文摘要里看到「比扩散快」时,把它翻译成「步数更少 × 单步成本相同」或者「步数相同 × 单步成本更便宜」。剩下的全是营销话术。
延伸阅读
- Goodfellow et al. (2014). Generative Adversarial Nets —— GAN 那篇论文。
- Kingma & Welling (2013). Auto-Encoding Variational Bayes —— VAE 那篇论文。
- Ho, Jain, Abbeel (2020). Denoising Diffusion Probabilistic Models —— DDPM 那篇论文。
- Song et al. (2021). Score-Based Generative Modeling through SDEs —— 把扩散看作一个 SDE。
- Lipman et al. (2023). Flow Matching for Generative Modeling —— 流匹配那篇论文。
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis —— Stable Diffusion 3。