扩散模型 —— 从零写 DDPM
Ho、Jain、Abbeel(2020)给了这个领域一个戒不掉的配方。用上千个小步骤把数据用噪声毁掉。训一个神经网络预测那个噪声。推理时把这个过程反过来。今天每一个主流的图像、视频、3D、音乐模型都跑在这个循环上,可能还在上面叠了流匹配或一致性技巧。
类型: Build 语言: Python 前置要求: 阶段 3 · 02(反向传播)、阶段 8 · 02(VAE) 预计时间: ~75 分钟
问题背景
你想要一个 p_data(x) 的采样器。GAN 玩的是一个常常发散的极小极大博弈。VAE 从高斯解码器里产出模糊样本。你真正想要的是一个训练目标,它 (a) 是单个稳定的损失(没有鞍点,没有极小极大),(b) 是 log p(x) 的一个下界(这样你就有了似然),(c) 样本能匹配 SOTA 质量。
Sohl-Dickstein 等人(2015)有一个理论答案:定义一条马尔可夫链 q(x_t | x_\{t-1\}),它逐步加高斯噪声,再训一条反向链 p_θ(x_\{t-1\} | x_t) 来去噪。Ho、Jain、Abbeel(2020)证明这个损失能简化成一行——预测噪声——并把数学收拾干净了。2020 年这还是个奇珍。2021 年它产出了顶尖样本。2022 年它变成了 Stable Diffusion。2026 年它是底座。
核心概念
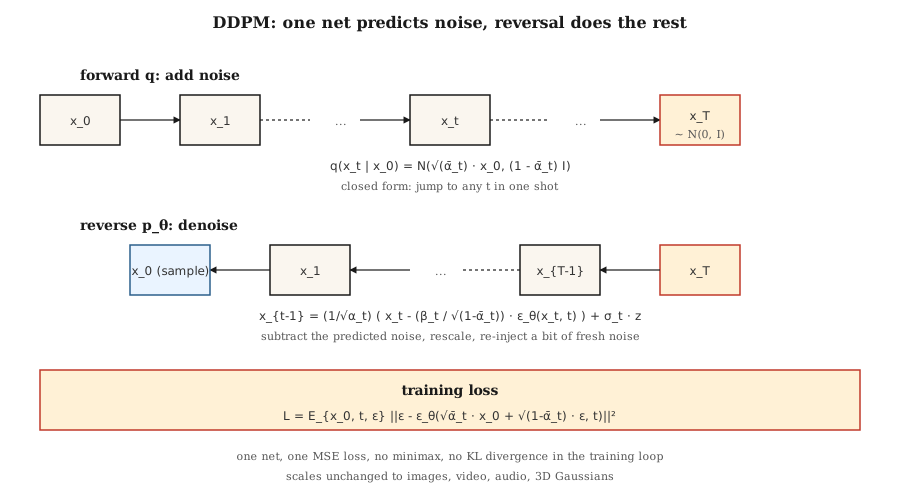
前向过程 q。 用 T 个小步骤加高斯噪声。闭式解——也就是数学可解的原因——在于累积后的那一步也是高斯:
q(x_t | x_0) = N( sqrt(α̅_t) · x_0, (1 - α̅_t) · I )其中对于一个 β_t 的调度,α̅_t = ∏_\{s=1..t\} (1 - β_s)。在 T=1000 步上把 β_t 从 1e-4 线性取到 0.02,x_T 就近似是 N(0, I)。
反向过程 p_θ。 学一个神经网络 ε_θ(x_t, t) 来预测当初加进去的噪声。给定 x_t,这样去噪:
x_{t-1} = (1 / sqrt(α_t)) · ( x_t - (β_t / sqrt(1 - α̅_t)) · ε_θ(x_t, t) ) + σ_t · z其中 σ_t 要么是 sqrt(β_t),要么是一个学出来的方差。这个式子很丑,但它只是代数——在给定后验 q(x_\{t-1\} | x_t, x_0) 的情况下解出 x_\{t-1\},再把 x_0 换成它的噪声预测估计。
训练损失。
L_simple = E_{x_0, t, ε} [ || ε - ε_θ( sqrt(α̅_t) · x_0 + sqrt(1 - α̅_t) · ε, t ) ||² ]从数据里采 x_0,挑一个随机的 t,采 ε ~ N(0, I),用闭式解一次算出带噪的 x_t,然后对噪声做回归。一个损失,没有极小极大,没有 KL,没有重参数化技巧。
采样。 从 x_T ~ N(0, I) 起步。从 t = T 到 1 迭代反向步。完事。
为什么有用
三个直觉:
去噪容易;生成难。 在
t=T时数据是纯噪声——网络要解的是个无聊的问题。在t=0时网络只需收拾几个像素。在中间的t,问题难,但每个噪声级别都有许多梯度流过同一套权重。乔装的分数匹配。 Vincent(2011)证明预测噪声等价于估计
∇_x log q(x_t | x_0),即分数。反向 SDE 用这个分数沿密度梯度往上走——一次朝高概率区域引导的随机游走。ELBO 退化成简单 MSE。 完整的变分下界每个时间步有一个 KL 项。在 DDPM 的参数化下,这些 KL 项简化成带特定系数的噪声预测 MSE;Ho 把系数丢了(叫它「simple」损失),质量反而提升了。
diffusion-denoise动手构建
code/main.py 实现一个一维 DDPM。数据是一个双峰混合。「网络」是一个迷你 MLP,接受 (x_t, t) 输出预测噪声。训练就是那一行损失。采样迭代反向链。
第 1 步:前向调度(闭式)
betas = [1e-4 + (0.02 - 1e-4) * t / (T - 1) for t in range(T)]
alphas = [1 - b for b in betas]
alpha_bars = []
cum = 1.0
for a in alphas:
    cum *= a
    alpha_bars.append(cum)
第 2 步:一次性采样 x_t
def forward_sample(x0, t, alpha_bars, rng):
    a_bar = alpha_bars[t]
    eps = rng.gauss(0, 1)
    x_t = math.sqrt(a_bar) * x0 + math.sqrt(1 - a_bar) * eps
    return x_t, eps
第 3 步:一个训练步
def train_step(x0, model, alpha_bars, rng):
    t = rng.randrange(T)
    x_t, eps = forward_sample(x0, t, alpha_bars, rng)
    eps_hat = model_forward(model, x_t, t)
    loss = (eps - eps_hat) ** 2
    return loss, gradient_step(model, ...)
第 4 步:反向采样
def sample(model, alpha_bars, T, rng):
    x = rng.gauss(0, 1)
    for t in range(T - 1, -1, -1):
        eps_hat = model_forward(model, x, t)
        beta_t = 1 - alphas[t]
        x = (x - beta_t / math.sqrt(1 - alpha_bars[t]) * eps_hat) / math.sqrt(alphas[t])
        if t > 0:
            x += math.sqrt(beta_t) * rng.gauss(0, 1)
    return x
对于一个 40 个时间步、24 单元 MLP 的一维问题,这能在约 200 个 epoch 里学会那个双峰混合。
时间条件化
网络需要知道它在给哪个时间步去噪。两个标准选项:
- 正弦嵌入。 像 Transformer 的位置编码。
embed(t) = [sin(t/ω_0), cos(t/ω_0), sin(t/ω_1), ...]。过一个 MLP,广播进网络。 - FiLM / group-norm 条件化。 把嵌入投影成每个块上的逐通道 scale/bias(FiLM)。
我们的玩具代码用正弦 → 拼接。生产 U-Net 用 FiLM。
坑
- 调度非常关键。 线性
β是 DDPM 的默认,但余弦调度(Nichol & Dhariwal, 2021)在相同算力下给出更好的 FID。质量到平台期就换调度。 - 时间步嵌入很脆。 把原始
t当浮点传进去对玩具一维有用,但对图像就失败;永远用一个像样的嵌入。 - V-prediction vs ε-prediction。 对于极端区间(t 很小或很大),
ε的信噪比很差。V-prediction(v = α·ε - σ·x)更稳定;SDXL、SD3、Flux 都用它。 - 无分类器引导。 推理时算出条件和无条件两个
ε,再ε_cfg = (1 + w) · ε_cond - w · ε_uncond,w ≈ 3-7。在第 08 课讲。 - 1000 步很多。 生产用 DDIM(20-50 步)、DPM-Solver(10-20 步),或蒸馏(1-4 步)。见第 12 课。
实际使用
| 角色 | 2026 年的典型栈 |
|---|---|
| 像素空间图像扩散(小、玩具) | DDPM + U-Net |
| 图像潜空间扩散 | VAE 编码器 + U-Net 或 DiT(第 07 课) |
| 视频潜空间扩散 | 时空 DiT(Sora、Veo、WAN) |
| 音频潜空间扩散 | Encodec + 扩散 transformer |
| 科学(分子、蛋白质、物理) | 等变扩散(EDM、RFdiffusion、AlphaFold3) |
扩散是通用的生成骨干。流匹配(第 13 课)是 2024-2026 年的竞争者,在相同质量下通常在推理速度上胜出。
拿去用
存为 outputs/skill-diffusion-trainer.md。技能接受一个数据集 + 算力预算,输出:调度(线性/余弦/sigmoid)、预测目标(ε/v/x)、步数、引导强度、采样器家族,以及一套评测流程。
练习
- 简单。 把
code/main.py里的 T 从 40 改成 10。样本质量(输出的可视化直方图)怎么退化?T 到多少时双峰结构会坍掉? - 中等。 从 ε-prediction 切到 v-prediction。重新推导反向步。比较最终样本质量。
- 困难。 加上无分类器引导。以类别标签
c ∈ \{0, 1\}为条件,训练时 10% 概率丢掉它,采样时用ε = (1+w)·ε_cond - w·ε_uncond。测量w = 0, 1, 3, 7时的条件命中模式的命中率。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 前向过程 | 「加噪声」 | 毁掉数据的固定马尔可夫链 `q(x_t |
| 反向过程 | 「去噪」 | 重建数据的学出来的链 `p_θ(x_{t-1} |
| β 调度 | 「噪声梯子」 | 逐步的方差;线性、余弦或 sigmoid。 |
| α̅ | 「Alpha bar」 | 累积乘积 ∏(1 - β);从 x_0 给出闭式的 x_t。 |
| simple 损失 | 「噪声上的 MSE」 | ` |
| ε-prediction | 「预测噪声」 | 输出是加进去的噪声;标准 DDPM。 |
| V-prediction | 「预测速度」 | 输出是 α·ε - σ·x;跨 t 的条件化更好。 |
| DDPM | 「那篇论文」 | Ho 等人 2020;线性 β、1000 步、U-Net。 |
| DDIM | 「确定性采样器」 | 非马尔可夫采样器,20-50 步,相同训练目标。 |
| 无分类器引导 | 「CFG」 | 混合条件和无条件的噪声预测来放大条件作用。 |
生产笔记:扩散推理是一个步数问题
DDPM 论文跑 T=1000 个反向步。没人在生产里这么上线。每个真实推理栈都从三种策略里挑一种——而每一种都干净地对应到生产上「延迟从哪来」的框架:
- 更快的采样器,同一个模型。 DDIM(20-50 步)、DPM-Solver++(10-20)、UniPC(8-16)。直接替换反向循环;训好的
ε_θ权重原封不动。延迟砍 20-50 倍。 - 蒸馏。 训一个学生用更少的步数匹配老师:渐进式蒸馏(2 → 1)、一致性模型(任意 → 1-4)、LCM、SDXL-Turbo、SD3-Turbo。延迟再砍 5-10 倍,需要重训。
- 缓存与编译。
torch.compile(unet, mode="reduce-overhead")、TensorRT-LLM 的扩散后端、xformers/SDPA 注意力、bf16 权重。每步延迟砍约 2 倍。可叠加在 (1) 和 (2) 之上。
对一个生产扩散服务器,预算这件事的对话跟生产文献为 LLM 描述的一样:延迟是 num_steps × step_cost + VAE_decode,吞吐是 batch_size × (num_steps × step_cost)^-1。TTFT 很小(一步);等价于 TPOT 的是整个响应时间,因为从用户视角看图像生成是「一次性出全」的。
延伸阅读
- Sohl-Dickstein et al. (2015). Deep Unsupervised Learning using Nonequilibrium Thermodynamics —— 扩散那篇论文,超前于它的时代。
- Ho, Jain, Abbeel (2020). Denoising Diffusion Probabilistic Models —— DDPM。
- Song, Meng, Ermon (2021). Denoising Diffusion Implicit Models —— DDIM,更少步数。
- Nichol & Dhariwal (2021). Improved DDPM —— 余弦调度、学出来的方差。
- Dhariwal & Nichol (2021). Diffusion Models Beat GANs on Image Synthesis —— 分类器引导。
- Ho & Salimans (2022). Classifier-Free Diffusion Guidance —— CFG。
- Karras et al. (2022). Elucidating the Design Space of Diffusion-Based Generative Models (EDM) —— 统一记号,最干净的配方。