嵌入模型 —— 2026 年深入剖析
Word2Vec 给你每个词一个向量。现代嵌入模型给你每段文字一个向量,跨语言,带稀疏、稠密、多向量三种视图,尺寸量身适配你的索引。挑错了,你的 RAG 就检索错东西。
类型: Learn 语言: Python 前置要求: Phase 5 · 03(Word2Vec)、Phase 5 · 14(信息检索) 预计时间: ~60 分钟
问题背景
你的 RAG 系统有 40% 的时候检索错段落。罪魁祸首很少是向量数据库或 prompt,而是嵌入模型。
2026 年挑一个嵌入,意味着要在五个维度上权衡:
- 稠密 vs 稀疏 vs 多向量。 每段一个向量、每 token 一个向量,还是一个稀疏加权词袋。
- 语言覆盖。 在纯英语任务上,单语言英语模型仍然胜出。语料混合时,多语言模型胜出。
- 上下文长度。 512 token vs 8192 vs 32768——而真实有效容量往往只有标称上限的 60-70%。
- 维度预算。 3072 个 float 全精度 = 每向量 12 KB。1 亿向量时,存储是每月 1300 美元。Matryoshka 截断把它砍掉 4 倍。
- 开源 vs 托管。 开源权重意味着你掌控整套栈和数据。托管意味着你用掌控换永远最新。
这节课点明各种取舍,让你按证据来挑,而不是按上个季度流行什么。
核心概念
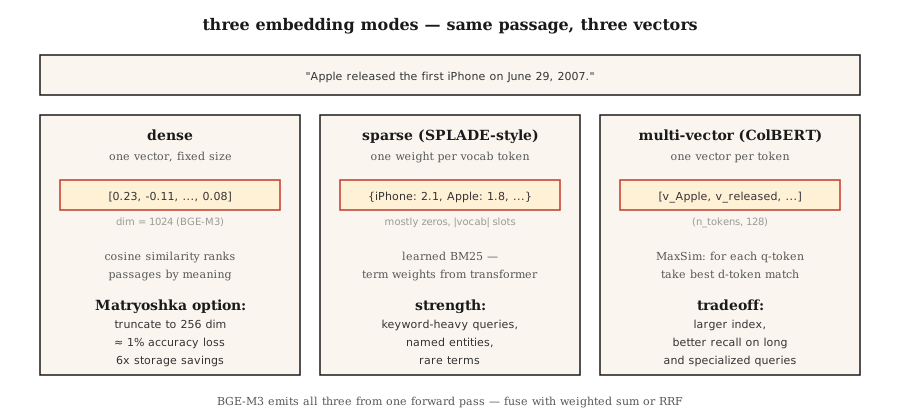
稠密嵌入。 每段一个向量(通常 384-3072 维)。余弦相似度按语义邻近度给段落排序。OpenAI text-embedding-3-large、BGE-M3 稠密模式、Voyage-3。默认选择。
稀疏嵌入。 SPLADE 风格。一个 transformer 给每个词表 token 预测一个权重,然后把大部分清零。结果是一个大小为 |vocab| 的稀疏向量。捕捉词面匹配(像 BM25)但用的是学出来的词权重。在关键词密集的查询上强。
多向量(后期交互)。 ColBERTv2、Jina-ColBERT。每 token 一个向量。用 MaxSim 打分:对每个查询 token,找最相似的文档 token,把分数加起来。存储和打分更贵,但在长查询和领域专用语料上胜出。
BGE-M3:三种一次给齐。 单个模型同时输出稠密、稀疏、多向量表示。每种都能独立查询;分数通过加权和融合。当你想从一个 checkpoint 拿到灵活性时,这是 2026 年的默认。
Matryoshka 表示学习。 训练得让向量的前 N 维自己就构成一个有用的独立嵌入。把一个 1536 维向量截成 256 维,用约 1% 的准确率换 6 倍的存储节省。OpenAI text-3、Cohere v4、Voyage-4、Jina v5、Gemini Embedding 2、Nomic v1.5+ 都支持。
MTEB 排行榜只讲了一半的故事
Massive Text Embedding Benchmark——发布时(2022)8 种任务类型下的 56 个任务,到 MTEB v2 扩到 100+ 个任务。2026 年初,Gemini Embedding 2 居检索榜首(67.71 MTEB-R)。Cohere embed-v4 领跑通用(65.2 MTEB)。BGE-M3 领跑开源权重多语言(63.0)。排行榜是必要的但不充分——永远在你的领域上做基准测试。
三层模式
| 用例 | 模式 |
|---|---|
| 快速首遍 | 稠密 bi-encoder(BGE-M3、text-3-small) |
| 召回增强 | 稀疏(SPLADE、BGE-M3 稀疏)+ RRF 融合 |
| top-50 上的精度 | 多向量(ColBERTv2)或 cross-encoder 重排器 |
大多数生产栈三种都用。
gx-matryoshka动手构建
第 1 步:基线——用 Sentence-BERT 做稠密嵌入
from sentence_transformers import SentenceTransformer
import numpy as np

encoder = SentenceTransformer("BAAI/bge-small-en-v1.5")
corpus = [
    "The first iPhone launched in 2007.",
    "Apple released the iPod in 2001.",
    "Android is an operating system from Google.",
]
emb = encoder.encode(corpus, normalize_embeddings=True)

query = "When was the iPhone released?"
q_emb = encoder.encode([query], normalize_embeddings=True)[0]
scores = emb @ q_emb
print(sorted(enumerate(scores), key=lambda x: -x[1]))
normalize_embeddings=True 让点积等于余弦相似度。永远设它。
第 2 步:Matryoshka 截断
def truncate(vectors, dim):
    out = vectors[:, :dim]
    return out / np.linalg.norm(out, axis=1, keepdims=True)

emb_256 = truncate(emb, 256)
emb_128 = truncate(emb, 128)
截断后重新归一化。Nomic v1.5、OpenAI text-3、Voyage-4 都训练得让头几级这样做是无损的。非 Matryoshka 模型(原始 Sentence-BERT)被截断时会急剧退化。
第 3 步:BGE-M3 的多功能性
from FlagEmbedding import BGEM3FlagModel

model = BGEM3FlagModel("BAAI/bge-m3", use_fp16=True)

output = model.encode(
    corpus,
    return_dense=True,
    return_sparse=True,
    return_colbert_vecs=True,
)
# output["dense_vecs"]:    (n_docs, 1024)
# output["lexical_weights"]: list of dict {token_id: weight}
# output["colbert_vecs"]:  list of (n_tokens, 1024) arrays
三个索引,一次推理调用。分数融合:
dense_score = ... # 稠密向量上的余弦
sparse_score = model.compute_lexical_matching_score(q_lex, d_lex)
colbert_score = model.colbert_score(q_col, d_col)
final = 0.4 * dense_score + 0.2 * sparse_score + 0.4 * colbert_score
在你的领域上调权重。
第 4 步:在自定义任务上做 MTEB 评估
from mteb import MTEB

tasks = ["ArguAna", "SciFact", "NFCorpus"]
evaluation = MTEB(tasks=tasks)
results = evaluation.run(encoder, output_folder="./mteb-results")在一个有代表性的子集上跑你的候选模型。别只信排行榜排名——你的领域才算数。
第 5 步:从零手搓余弦
见 code/main.py。平均哈希技巧嵌入(仅标准库)。比不过 transformer 嵌入,但展示了形状:分词 → 向量 → 归一化 → 点积。
坑
- 查询和文档用同一个模型。 有些模型(Voyage、Jina-ColBERT)用非对称编码——查询和文档走不同路径。永远查模型卡。
- 缺前缀。
bge-*模型需要在查询前加"Represent this sentence for searching relevant passages: "。忘了的话有 3-5 个点的召回差距。 - Matryoshka 截过头。 1536 → 256 通常安全。1536 → 64 不安全。在你的评估集上验证。
- 上下文截断。 大多数模型对超过最大长度的输入默默截断。长文档需要分块(见第 23 课)。
- 忽略延迟尾部。 MTEB 分数藏住了 p99 延迟。一个 600M 模型可能比 335M 模型高 2 个点,但每查询贵 3 倍。
实际使用
2026 年的栈:
| 场景 | 选择 |
|---|---|
| 纯英语、快、API | text-embedding-3-large 或 voyage-3-large |
| 开源权重、英语 | BAAI/bge-large-en-v1.5 |
| 开源权重、多语言 | BAAI/bge-m3 或 Qwen3-Embedding-8B |
| 长上下文(32k+) | Voyage-3-large、Cohere embed-v4、Qwen3-Embedding-8B |
| 纯 CPU 部署 | Nomic Embed v2(137M 参数,MoE) |
| 存储受限 | Matryoshka 截断 + int8 量化 |
| 关键词密集查询 | 加 SPLADE 稀疏,与稠密做 RRF 融合 |
2026 年的模式:从 BGE-M3 或 text-3-large 起步,用 MTEB 在你的领域上评估,如果某个领域专用模型胜出超过 3 个点就换。
拿去用
存为 outputs/skill-embedding-picker.md:
---
name: embedding-picker
description: Pick embedding model, dimension, and retrieval mode for a given corpus and deployment.
version: 1.0.0
phase: 5
lesson: 22
tags: [nlp, embeddings, retrieval]
---

Given a corpus (size, languages, domain, avg length), deployment target (cloud / edge / on-prem), latency budget, and storage budget, output:

1. Model. Named checkpoint or API. One-sentence reason.
2. Dimension. Full / Matryoshka-truncated / int8-quantized. Reason tied to storage budget.
3. Mode. Dense / sparse / multi-vector / hybrid. Reason.
4. Query prefix / template if required by the model card.
5. Evaluation plan. MTEB tasks relevant to domain + held-out domain eval with nDCG@10.

Refuse recommendations that truncate Matryoshka to <64 dims without domain validation. Refuse ColBERTv2 for corpora under 10k passages (overhead not justified). Flag long-document corpora (>8k tokens) routed to models with 512-token windows.
练习
- 简单。 用
bge-small-en-v1.5在全维(384)、再在 Matryoshka 128 下编码 100 个句子。在 10 个查询上测 MRR 的下降。 - 中等。 在你领域的 500 个段落上对比 BGE-M3 的稠密、稀疏、colbert。哪个在 recall@10 上胜出?RRF 融合打得过最好的单一模式吗?
- 困难。 在你最关注的 2 个领域任务上,对三个候选模型跑 MTEB。报告 MTEB 分数、100 查询批次上的 p99 延迟、以及每百万查询的成本。挑帕累托最优的那个。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| 稠密嵌入 | 那个向量 | 每段文本一个定长向量。用余弦相似度排序。 |
| 稀疏嵌入 | 学出来的 BM25 | 每个词表 token 一个权重;大部分为零;端到端训练。 |
| 多向量 | ColBERT 式 | 每 token 一个向量;MaxSim 打分;索引更大,召回更好。 |
| Matryoshka | 俄罗斯套娃戏法 | 前 N 维自身就是一个有效的更小嵌入。 |
| MTEB | 那个基准 | Massive Text Embedding Benchmark——发布时 56 个任务,v2 里 100+。 |
| BEIR | 那个检索基准 | 18 个 zero-shot 检索任务;常用于衡量跨领域稳健性。 |
| 非对称编码 | 查询 ≠ 文档路径 | 模型对查询和文档用不同的投影。 |
延伸阅读
- Reimers, Gurevych (2019). Sentence-BERT —— bi-encoder 论文。
- Muennighoff et al. (2022). MTEB: Massive Text Embedding Benchmark —— 排行榜论文。
- Chen et al. (2024). BGE-M3: Multi-lingual, Multi-functionality, Multi-granularity —— 统一三模式模型。
- Kusupati et al. (2022). Matryoshka Representation Learning —— 维度阶梯训练目标。
- Santhanam et al. (2022). ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction —— 生产中的后期交互。
- MTEB leaderboard on Hugging Face —— 实时排名。