语音识别(ASR)—— CTC、RNN-T、注意力
语音识别就是在每个时间步做音频分类,再用一个懂英语、懂静音的序列模型把它们粘到一起。CTC、RNN-T 和注意力是三种做法。挑一个,搞懂它为什么这么做。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(频谱图与梅尔)、阶段 5 · 08(用于文本的 CNN 与 RNN)、阶段 5 · 10(注意力) 预计时间: ~45 分钟
问题背景
你有一段 10 秒、16 kHz 的音频。你想要一个字符串:"turn on the kitchen lights"。难点在结构上:音频帧和字符并不是一一对齐的。"okay" 这个词可能耗时 200 ms,也可能 1200 ms。静音穿插在话语之间。有些音素比别的长。输出 token 的数量事先并不知道。
三种建模方式解决了这个问题:
- CTC(连接时序分类,Connectionist Temporal Classification)。 逐帧输出 token 概率,其中包含一个特殊的空白(blank)。解码时把重复和空白折叠掉。非自回归,快。wav2vec 2.0、MMS 用的就是它。
- RNN-T(循环神经网络转换器,Recurrent Neural Network Transducer)。 联合网络根据编码器帧和之前的 token 预测下一个 token。可流式。Google 的端侧 ASR、NVIDIA Parakeet 用的是它。
- 注意力编码器-解码器。 编码器把音频压成隐状态,解码器交叉注意力地自回归生成 token。Whisper、SeamlessM4T 用的是它。
2026 年,LibriSpeech test-clean 上的 SOTA WER 是 1.4%(Parakeet-TDT-1.1B,NVIDIA)和 1.58%(Whisper-Large-v3-turbo)。差距极小;部署上的差异却很大。
核心概念
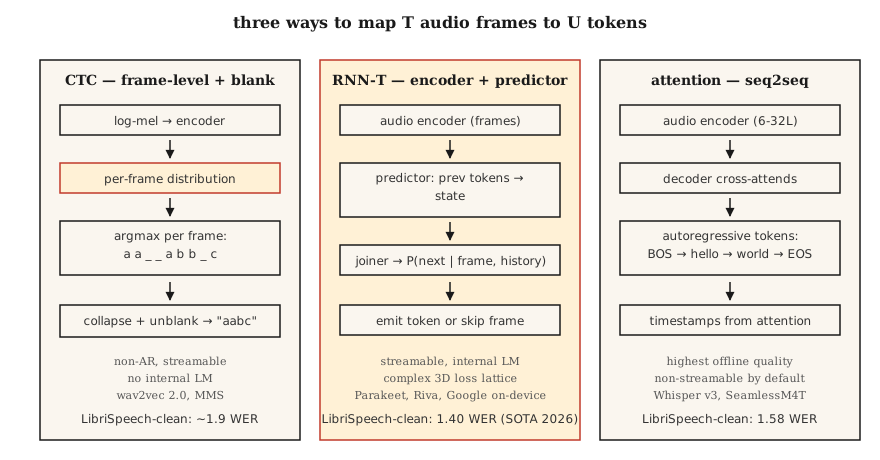
CTC 直觉。 让编码器输出 T 个帧级分布,每个是 V+1 个 token(V 个字符 + 空白)上的分布。对长度 U < T 的目标字符串 y,任何能折叠成 y 的帧对齐都算数。CTC 损失对所有这类对齐求和。推理时:逐帧 argmax,折叠重复,去掉空白。
优点:非自回归、可流式、零前瞻。缺点:条件独立假设——每帧预测彼此独立,所以没有内部语言模型。通过束搜索或浅层融合外接一个 LM 来补救。
RNN-T 直觉。 加了一个*预测器(predictor)网络嵌入 token 历史,再加一个合并器(joiner)*把预测器状态和编码器帧合并成 V+1(这个 +1 是空 / 不输出)上的联合分布。显式建模了 CTC 忽略的条件依赖。可流式,因为每一步只依赖过去的帧和过去的 token。
优点:可流式 + 内部 LM。缺点:训练更复杂、更吃内存(三维损失格点);RNN-T 损失核函数本身就是一整类库。
注意力编码器-解码器。 编码器(6-32 层 transformer)作用在对数梅尔帧上。解码器(6-32 层 transformer)交叉注意力地关注编码器输出,自回归生成 token。没有对齐约束——注意力可以看音频里的任何地方。除非你限制注意力(分块的 Whisper-Streaming,2024),否则不可流式。
优点:离线 ASR 上质量最高,用标准 seq2seq 工具就好训。缺点:自回归延迟与输出长度成正比;不做工程就没法流式。
WER:那个唯一的数字
词错误率(Word Error Rate) = (S + D + I) / N,其中 S=替换,D=删除,I=插入,N=参考文本词数。等于词级别的莱文斯坦编辑距离。越低越好。WER 高于 20% 通常没法用;低于 5% 在朗读语音上达到人类水平。标准基准上的 2026 年数字:
| 模型 | LibriSpeech test-clean | LibriSpeech test-other | 规模 |
|---|---|---|---|
| Parakeet-TDT-1.1B | 1.40% | 2.78% | 11 亿参数 |
| Whisper-Large-v3-turbo | 1.58% | 3.03% | 8.09 亿 |
| Canary-1B Flash | 1.48% | 2.87% | 10 亿 |
| Seamless M4T v2 | 1.7% | 3.5% | 23 亿 |
这些全是基于编码器-解码器或 RNN-T 的。纯 CTC 系统(wav2vec 2.0)在 test-clean 上大约在 1.8–2.1%。
ctc-collapse动手构建
第 1 步:贪心 CTC 解码
def ctc_greedy(frame_logits, blank=0, vocab=None):
    # frame_logits: list of per-frame probability vectors
    preds = [max(range(len(p)), key=lambda i: p[i]) for p in frame_logits]
    out = []
    prev = -1
    for p in preds:
        if p != prev and p != blank:
            out.append(p)
        prev = p
return "".join(vocab[i] for i in out) if vocab else out两条规则:折叠连续重复,丢掉空白。例子:a a _ _ a b b _ c → a a b c。
第 2 步:束搜索 CTC
def ctc_beam(frame_logits, beam=8, blank=0):
    import math
    beams = [([], 0.0)]  # (tokens, log_prob)
    for p in frame_logits:
        log_p = [math.log(max(pi, 1e-10)) for pi in p]
        candidates = []
        for seq, lp in beams:
            for t, lpt in enumerate(log_p):
                new = seq[:] if t == blank else (seq + [t] if not seq or seq[-1] != t else seq)
                candidates.append((new, lp + lpt))
        candidates.sort(key=lambda x: -x[1])
        beams = candidates[:beam]
    return beams[0][0]
生产环境用带 LM 融合的前缀树束搜索;这里是概念骨架。
第 3 步:WER
def wer(ref, hyp):
    r, h = ref.split(), hyp.split()
    dp = [[0] * (len(h) + 1) for _ in range(len(r) + 1)]
    for i in range(len(r) + 1):
        dp[i][0] = i
    for j in range(len(h) + 1):
        dp[0][j] = j
    for i in range(1, len(r) + 1):
        for j in range(1, len(h) + 1):
            cost = 0 if r[i - 1] == h[j - 1] else 1
            dp[i][j] = min(
                dp[i - 1][j] + 1,
                dp[i][j - 1] + 1,
                dp[i - 1][j - 1] + cost,
            )
    return dp[len(r)][len(h)] / max(1, len(r))
第 4 步:拿 Whisper 做推理
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("clip.wav")
print(result["text"])
一行调用 2026 年最强的通用 ASR。在一张 24 GB GPU 上以约 20 倍实时速度运行。
第 5 步:用 Parakeet 或 wav2vec 2.0 做流式
from transformers import pipeline
asr = pipeline("automatic-speech-recognition", model="nvidia/parakeet-tdt-1.1b")
for chunk in streaming_audio():
    print(asr(chunk, return_timestamps=True))
流式 ASR 需要分块的编码器注意力和状态延续;用一个支持它的库(Parakeet 用 NeMo,或带 chunk_length_s 的 transformers pipeline)。
实际使用
2026 年的工具栈:
| 情形 | 选 |
|---|---|
| 英语、离线、追求最高质量 | Whisper-large-v3-turbo |
| 多语种、鲁棒 | SeamlessM4T v2 |
| 流式、低延迟 | Parakeet-TDT-1.1B 或 Riva |
| 边缘端、移动端、延迟 <500 ms | 量化的 Whisper-Tiny 或 Moonshine(2024) |
| 长音频 | 带 VAD 分块的 Whisper(WhisperX) |
| 领域专用(医疗、法律) | 微调 wav2vec 2.0 + 领域 LM 融合 |
2026 年仍在上线的坑
- 没有 VAD。 在静音上跑 Whisper 会产生幻觉("Thanks for watching!")。永远用 VAD 把门。
- 字符级 vs 词级 vs 子词级 WER。 报告 WER 要在归一化之后按词级来算(小写化、去标点)。
- 语种识别漂移。 Whisper 的自动 LID 会把嘈杂音频误路由到日语或威尔士语;你知道语种时就强制
language="en"。 - 长音频不分块。 Whisper 有一个 30 秒的窗口。超过这个长度就用
chunk_length_s=30, stride=5。
拿去用
存为 outputs/skill-asr-picker.md。针对给定的部署目标,挑选模型、解码策略、分块方式和 LM 融合。
练习
- 简单。 跑
code/main.py。它贪心解码一段手工构造的 CTC 输出,并对参考文本算 WER。 - 中等。 把第 2 步的前缀树束搜索正确实现出来(处理好空白合并规则)。在一个 10 例的合成数据集上和贪心做对比。
- 困难。 在 LibriSpeech test-clean 上用
whisper-large-v3-turbo。算出前 100 条语音的 WER。和公布的数字对比。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| CTC | 那个带空白 token 的损失 | 对所有帧到 token 的对齐做边缘化;非自回归。 |
| RNN-T | 那个流式损失 | CTC + 下一 token 预测器;能处理词序。 |
| 注意力编-解 | Whisper 风格 | 编码器 + 交叉注意力解码器;离线质量最佳。 |
| WER | 你要报告的那个数 | 词级别的 (S+D+I)/N。 |
| 空白(Blank) | 那个「空」 | CTC 里表示「这一帧不输出」的特殊 token。 |
| LM 融合 | 外部语言模型 | 束搜索时加上加权的 LM 对数概率。 |
| VAD | 那道静音门 | 语音活动检测器;裁掉非语音段。 |
延伸阅读
- Graves et al. (2006). Connectionist Temporal Classification —— CTC 那篇论文。
- Graves (2012). Sequence Transduction with RNNs —— RNN-T 那篇论文。
- Radford et al. / OpenAI (2022). Whisper: Robust Speech Recognition via Large-Scale Weak Supervision —— 2022 年的经典论文;v3-turbo 是 2024 年的扩展。
- NVIDIA NeMo — Parakeet-TDT card —— 2026 年 Open ASR 排行榜的领跑者。
- Hugging Face — Open ASR Leaderboard —— 横跨 25+ 模型的实时基准。