说话人识别与验证
ASR 问的是「他们说了什么」,说话人识别问的是「是谁说的」。数学看着一样——嵌入加余弦——但每个生产决策都系于一个 EER 数字。
类型: Build 语言: Python 前置要求: 阶段 6 · 02(频谱图与梅尔)、阶段 5 · 22(嵌入模型) 预计时间: ~45 分钟
问题背景
一个用户念了一句口令。你想知道:这是不是他声称的那个人(验证,1:1),还是你登记库里的第一个人(辨认,1:N)?或者两者都不是——这是不是一个未知的说话人(开集)?
2018 年前:GMM-UBM + i-vectors。EER 还行,但对信道偏移(电话 vs 笔记本)和情绪很脆。2018–2022:x-vectors(用角度间隔训练的 TDNN 骨干)。2022 年后:ECAPA-TDNN 和 WavLM-large 嵌入。到 2026 年,这个领域被三个模型和一个指标主宰。
那个指标是 EER——等错误率(Equal Error Rate)。把你的决策阈值设到误接受率 = 误拒绝率的位置,交叉点就是 EER。每篇论文、每张排行榜、每次采购评审都在用它。
核心概念
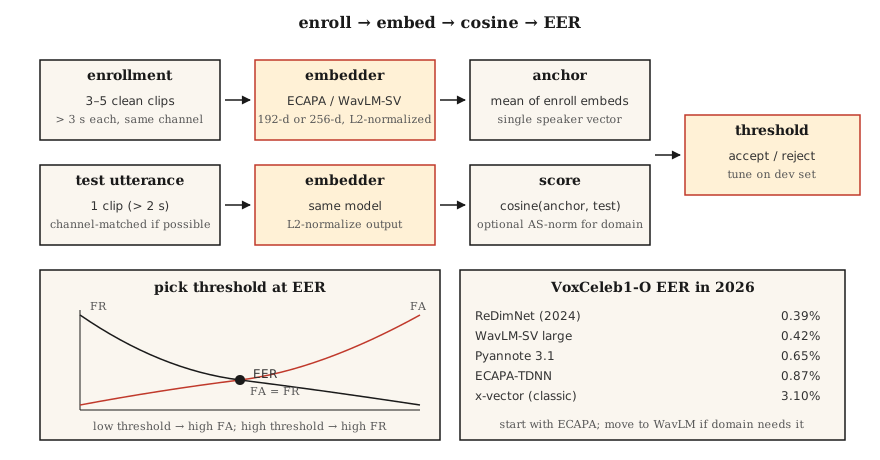
流水线。 登记:录下目标说话人的 5–30 秒语音;算出一个定维嵌入(ECAPA-TDNN 是 192 维,WavLM-large 是 256 维)。验证:取测试语音的嵌入;算余弦相似度;和一个阈值比较。
ECAPA-TDNN(2020,到 2026 仍占主导)。 Emphasized Channel Attention, Propagation and Aggregation - Time-Delay Neural Network。带 squeeze-excitation 的一维卷积块、多头注意力池化,后接一个线性层到 192 维。在 VoxCeleb 1+2(2,700 个说话人,110 万条语音)上用加性角度间隔损失(AAM-softmax)训练。
WavLM-SV(2022 年后)。 用 AAM 损失微调一个预训练的 WavLM-large SSL 骨干。质量更高但更慢——300+ MB 对 15 MB。
x-vector(基线)。 TDNN + 统计量池化。经典;在 CPU / 边缘端仍好用。
AAM-softmax。 在角度空间里加了间隔 m 的标准 softmax:正确类别用 cos(θ + m)。强制类间的角度分离。典型 m=0.2,缩放 s=30。
打分
- 登记嵌入和测试嵌入之间的余弦。基于阈值决策。
- PLDA(概率 LDA)。 把嵌入投影到一个潜空间,在那里「同说话人 vs 不同说话人」有闭式的似然比。叠在余弦之上能再降 10–20% 的 EER。2020 年前是标配;现在只用于闭集场景。
- 分数归一化。
S-norm或AS-norm:把每个分数对一组冒充者的均值和标准差做归一化。跨域评估必备。
你该知道的数字(2026)
| 模型 | VoxCeleb1-O EER | 参数量 | 吞吐(A100) |
|---|---|---|---|
| x-vector(经典) | 3.10% | 5 M | 400× 实时 |
| ECAPA-TDNN | 0.87% | 15 M | 200× 实时 |
| WavLM-SV large | 0.42% | 316 M | 20× 实时 |
| Pyannote 3.1 分段 + 嵌入 | 0.65% | 6 M | 100× 实时 |
| ReDimNet(2024) | 0.39% | 24 M | 100× 实时 |
说话人分离(Diarization)
多说话人音频里的「谁在什么时候说话」。流水线:VAD → 分段 → 给每段嵌入 → 聚类(层次或谱聚类)→ 平滑边界。现代工具栈:pyannote.audio 3.1,把说话人分段 + 嵌入 + 聚类打包在一次调用后面。2026 年 AMI 上的 SOTA DER 约 15%(从 2022 年的 23% 降下来)。
sp-eer-crossover动手构建
第 1 步:从 MFCC 统计量得到的玩具嵌入
def embed_mfcc_stats(signal, sr):
    frames = featurize_mfcc(signal, sr, n_mfcc=13)
    mean = [sum(f[i] for f in frames) / len(frames) for i in range(13)]
    std = [
        math.sqrt(sum((f[i] - mean[i]) ** 2 for f in frames) / len(frames))
        for i in range(13)
    ]
    return mean + std  # 26-d
离 SOTA 差着十万八千里——只用于教学。code/main.py 拿它在合成的说话人数据上做概念验证。
第 2 步:余弦相似度 + 阈值
def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(x * x for x in b))
    return dot / (na * nb) if na and nb else 0.0

def verify(enroll, test, threshold=0.75):
    return cosine(enroll, test) >= threshold
第 3 步:从相似度对算 EER
def eer(same_scores, diff_scores):
    thresholds = sorted(set(same_scores + diff_scores))
    best = (1.0, 1.0, 0.0)  # (fa, fr, threshold)
    for t in thresholds:
        fr = sum(1 for s in same_scores if s < t) / len(same_scores)
        fa = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
        if abs(fa - fr) < abs(best[0] - best[1]):
            best = (fa, fr, t)
    return (best[0] + best[1]) / 2, best[2]
返回 (eer, threshold_at_eer)。两个都要报。
第 4 步:用 SpeechBrain 做生产
from speechbrain.pretrained import EncoderClassifier

clf = EncoderClassifier.from_hparams(source="speechbrain/spkrec-ecapa-voxceleb")

# 登记:对 3-5 段干净样本的嵌入取平均
enroll = torch.stack([clf.encode_batch(load(x)) for x in enrollment_clips]).mean(0)
# 验证
score = clf.similarity(enroll, clf.encode_batch(load("test.wav"))).item()
verdict = score > 0.25   # ECAPA 的典型阈值;在你自己的数据上调
第 5 步:用 pyannote 做说话人分离
from pyannote.audio import Pipeline

pipe = Pipeline.from_pretrained("pyannote/speaker-diarization-3.1")
diarization = pipe("meeting.wav", num_speakers=None)
for turn, _, speaker in diarization.itertracks(yield_label=True):
    print(f"{turn.start:.1f}–{turn.end:.1f}  {speaker}")
实际使用
2026 年的工具栈:
| 情形 | 选 |
|---|---|
| 闭集 1:1 验证、边缘端 | ECAPA-TDNN + 余弦阈值 |
| 开集验证、云端 | WavLM-SV + AS-norm |
| 说话人分离(会议、播客) | pyannote/speaker-diarization-3.1 |
| 反欺骗(回放 / 深伪检测) | AASIST 或 RawNet2 |
| 微型嵌入式(KWS + 登记) | Titanet-Small(NeMo) |
坑
- 信道不匹配。 在 VoxCeleb(网络视频)上训的模型 ≠ 电话通话音频。永远在目标信道上评估。
- 短语音。 测试音频短于 3 秒时 EER 会急剧恶化。
- 带噪声登记。 一段带噪登记就会毒化锚点。用 ≥3 段干净样本取平均。
- 跨条件用固定阈值。 永远在目标领域的留出开发集上调阈值。
- 在未归一化的嵌入上做余弦。 先做 L2 归一化;否则幅值会主导。
拿去用
存为 outputs/skill-speaker-verifier.md。挑选模型、登记协议、阈值调优方案和防欺诈保护。
练习
- 简单。 跑
code/main.py。它构造合成的「说话人」(不同音色画像),登记,在一个 100 对的试验列表上算 EER。 - 中等。 在 30 条 VoxCeleb1 语音(5 个说话人 × 各 6 条)上用 SpeechBrain ECAPA。用余弦 vs PLDA 各算一次 EER。
- 困难。 用
pyannote.audio搭出完整的 登记 → 分离 → 验证 流水线。在 AMI 开发集上评估 DER。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| EER | 头条指标 | 误接受 = 误拒绝 的那个阈值。 |
| 验证 | 1:1 | 「这是 Alice 吗?」 |
| 辨认 | 1:N | 「是谁在说话?」 |
| 开集 | 可能存在未知 | 测试集可能含未登记的说话人。 |
| 登记 | 注册 | 计算一个说话人的参考嵌入。 |
| AAM-softmax | 那个损失 | 带加性角度间隔的 softmax;强制簇分离。 |
| PLDA | 经典打分 | 概率 LDA;在嵌入之上做似然比打分。 |
| DER | 说话人分离指标 | 分离错误率(Diarization Error Rate)—— 漏检 + 误报 + 混淆。 |
延伸阅读
- Snyder et al. (2018). X-Vectors: Robust DNN Embeddings for Speaker Recognition —— 经典的深度嵌入论文。
- Desplanques et al. (2020). ECAPA-TDNN —— 2020–2026 年主导的架构。
- Chen et al. (2022). WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing —— 用于 SV 和说话人分离的 SSL 骨干。
- Bredin et al. (2023). pyannote.audio 3.1 —— 生产级的说话人分离 + 嵌入工具栈。
- VoxCeleb leaderboard (updated 2026) —— 各模型当前的 EER 排名。