KV Cache、Flash Attention 与推理优化
训练是并行的、受 FLOP 约束。推理是串行的、受显存约束。瓶颈不同,招数不同。
类型: Build 语言: Python 前置要求: 阶段 7 · 02(Self-Attention)、阶段 7 · 05(完整的 Transformer)、阶段 7 · 07(GPT) 预计时间: ~75 分钟
问题背景
一个朴素的自回归解码器生成 N 个 token 要做 O(N²) 的功:每一步都对整个前缀重算注意力。一个 4K token 的回复就是 1600 万次注意力运算,大部分是冗余的。一个前缀 token 的隐藏状态一旦算出就是确定的——你只需要拿新 token 的 query 去和之前所有东西的缓存 key、value 算一遍。
更糟的是,注意力本身搬运大量数据。标准注意力要物化一个 N×N 的分数矩阵、N×d 的 softmax 输出、N×d 的最终输出——对 HBM 的读写太多。N≥2K 时,注意力在变成 FLOP 约束之前就先变成显存约束了。经典注意力 kernel 把现代 GPU 用得只剩 1/4 到 1/10 的效率。
两个优化,都出自 Dao et al.,把前沿推理从"慢"推到了"快":
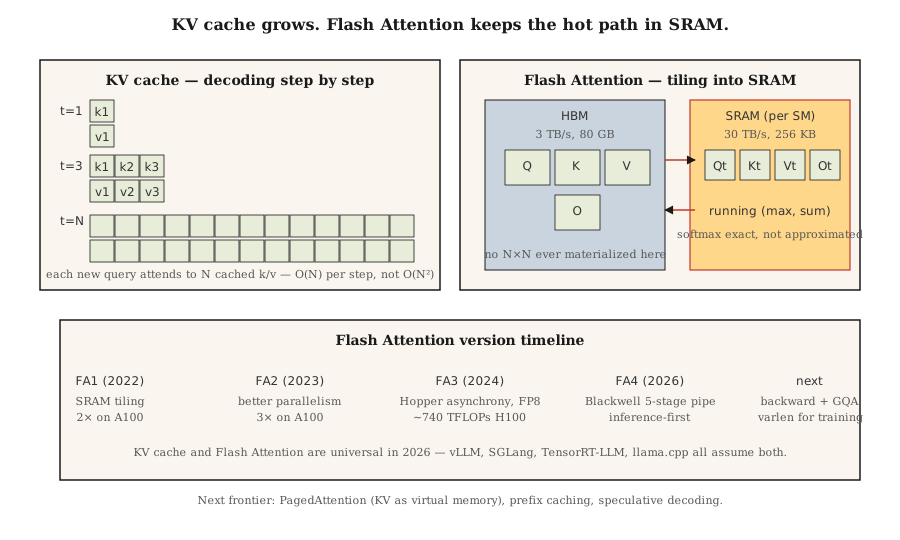
- KV 缓存。 存下每个前缀 token 的 K 和 V 向量。每个新 token 的注意力就是一次对缓存 key 的 query。推理从每个生成步
O(N²)降到O(N)。 - Flash Attention。 把注意力计算分块,让完整的 N×N 矩阵永远不落 HBM。softmax + matmul 全在 SRAM 里发生。A100 上墙钟加速 2–4 倍;H100 配 FP8 加速 5–10 倍。
到 2026 年两者都普及了。每个生产推理栈(vLLM、TensorRT-LLM、SGLang、llama.cpp)都假设有它们。每个前沿模型出厂都开着 Flash Attention。
核心概念
KV 缓存的算术
每个解码器层、每 token、每头:
bytes_per_token_per_layer = 2 * d_head * dtype_size
                          ^
                          K 和 V
对一个 7B 模型,32 层、32 头、d_head=128、fp16:
per token per layer = 2 * 128 * 2 = 512 bytes
per token (32 layers) = 16 KB
per 32K context = 512 MB
对 Llama 3 70B(80 层、d_head=128、GQA 配 8 个 KV 头):
per token per layer = 2 * 8 * 128 * 2 = 4096 bytes (4 KB)
per 32K context = 10.4 GB
这 10 GB 就是为什么 Llama 3 70B 在 128K 上下文、批大小 1 下,光 KV 缓存就要吃掉一块 40 GB A100 的大部分。
GQA 是 KV 缓存的胜利。 64 头的 MHA 会是 32 GB。MLA 压得更狠。
拖动各个维度,看缓存大小怎么变。把序列长度或批大小往上拉,看它多快就冲破一块 GPU 的容量:
kv-cache-sizerFlash Attention —— 分块把戏
标准注意力:
S = Q @ K^T          (HBM 读,N×N,HBM 写)
P = softmax(S)       (HBM 读,HBM 写)
O = P @ V            (HBM 读,HBM 写)
三次 HBM 往返。在 H100 上,HBM 带宽是 3 TB/s;SRAM 是 30 TB/s。相比把一切留在片上,每次 HBM 往返都是 10 倍的减速。
Flash Attention:
for each block of Q (tile size ~128 × 128):
    load Q_tile into SRAM
    for each block of K, V:
        load K_tile, V_tile into SRAM
        compute S_tile = Q_tile @ K_tile^T     (SRAM)
        running softmax aggregation             (SRAM)
        accumulate into O_tile                  (SRAM)
    write O_tile to HBM
每个 tile 一次 HBM 往返。总显存占用从 O(N²) 降到 O(N)。反向通过从前向通过重算一些值而不是存下来——又一个显存上的胜利。
数值把戏。 滚动 softmax 跨 tile 维护 (max, sum),让最终归一化是精确的。不是近似——Flash Attention 算出和标准注意力逐 bit 相同的输出(忽略 fp16 的非结合性)。
版本演进:
| 版本 | 年份 | 关键改动 | 参考硬件上的加速 |
|---|---|---|---|
| Flash 1 | 2022 | 分块 SRAM kernel | A100 上 2× |
| Flash 2 | 2023 | 更好的并行、因果优先排序 | A100 上 3× |
| Flash 3 | 2024 | Hopper 异步、FP8 | H100 上 1.5–2×(~740 TFLOPs FP16) |
| Flash 4 | 2026 | Blackwell 5 级流水线、软件 exp2 | 推理优先(初期仅前向) |
Flash 4 发布时只有前向通过。训练仍用 Flash 3。Flash 4 的 GQA 和 varlen 支持待定(2026 年中)。
投机解码 —— 另一个延迟胜利
廉价模型提议 N 个 token。大模型并行验证全部 N 个。如果验证接受了 k 个 token,你就用 1 次大模型前向通过换来了 k 次生成。代码和散文上典型 k=3–5。
2026 年默认:
- EAGLE 2 / Medusa。 集成的草稿头,共享验证器的隐藏状态。2–3× 加速,无质量损失。
- 带草稿模型的投机解码。 消费级硬件上 2–4× 加速。
- 前瞻解码(Lookahead decoding)。 Jacobi 迭代;不需要草稿模型。小众但免费。
连续批处理
经典批量推理:等最慢的序列跑完,再开新批次。短回复早早结束时浪费 GPU。
连续批处理(最早在 Orca 里出现,现在 vLLM、TensorRT-LLM、SGLang 都有):旧请求一完成就把新请求换进批次。典型聊天负载吞吐提升 5–10 倍。
PagedAttention —— 把 KV 缓存当虚拟内存
vLLM 的招牌功能。KV 缓存按 16 token 的块分配;一张页表把逻辑位置映射到物理块。让你能跨并行样本共享 KV(beam search、并行采样)、为 prompt 缓存热插拔前缀、整理内存碎片。相比朴素连续分配,吞吐提升 4 倍。
flash-attention-memory动手构建
见 code/main.py。我们实现:
- 一个朴素的
O(N²)增量解码器。 - 一个
O(N)的 KV 缓存解码器。 - 一个模拟 Flash Attention 滚动最大值算法的分块 softmax。
第 1 步:KV 缓存
class KVCache:
    def __init__(self, n_layers, n_heads, d_head):
        self.K = [[[] for _ in range(n_heads)] for _ in range(n_layers)]
        self.V = [[[] for _ in range(n_heads)] for _ in range(n_layers)]

    def append(self, layer, head, k, v):
        self.K[layer][head].append(k)
        self.V[layer][head].append(v)

    def read(self, layer, head):
        return self.K[layer][head], self.V[layer][head]
很简单:在每层、每头的列表里不断追加每 token 的 K、V 向量。
第 2 步:分块 softmax
def tiled_softmax_dot(q, K, V, tile=4):
    """带滚动 max/sum 的 Flash-attention 风格 softmax(qK^T)V。"""
    m = float("-inf")
    s = 0.0
    out = [0.0] * len(V[0])
    for start in range(0, len(K), tile):
        k_block = K[start:start + tile]
        v_block = V[start:start + tile]
        scores = [sum(qi * ki for qi, ki in zip(q, k)) for k in k_block]
        new_m = max(m, *scores)
        exp_old = math.exp(m - new_m) if m != float("-inf") else 0.0
        exp_new = [math.exp(sc - new_m) for sc in scores]
        s = s * exp_old + sum(exp_new)
        for j in range(len(out)):
            out[j] = out[j] * exp_old + sum(e * v[j] for e, v in zip(exp_new, v_block))
        m = new_m
    return [o / s for o in out]
和一次性算的 softmax(qK) V 逐 bit 相同的输出,但任意时刻工作集都是一个 tile × d_head 的块,不是完整的 N × d_head。
第 3 步:在 100 token 生成上对比朴素和缓存解码
数注意力运算数。朴素:O(N²) = 5050。缓存:O(N) = 100。代码两个都打印。
实际使用
# HuggingFace transformers 在纯解码器 generate() 上自动开启 KV 缓存。
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3.2-3B",
    attn_implementation="flash_attention_2",  # Hopper 上用 FA3
    torch_dtype="bfloat16",
)
# generate() 自动使用 KV 缓存
vLLM 生产:
pip install vllm
vllm serve meta-llama/Llama-3.1-70B-Instruct \
    --tensor-parallel-size 4 \
    --max-model-len 32768 \
    --enable-prefix-caching \
    --kv-cache-dtype fp8
跨请求的前缀缓存是 2026 年的一大胜利——相同的系统 prompt、少样本示例或长上下文文档,跨调用复用 KV。对于有重复工具 prompt 的 agent 负载,前缀缓存常常带来 5 倍吞吐提升。
拿去用
见 outputs/skill-inference-optimizer.md。这个 skill 为一个新的推理部署挑选注意力实现、KV 缓存策略、量化和投机解码。
练习
- 简单。 跑
code/main.py。确认朴素和缓存解码器产生相同输出;注意运算数的差别。 - 中等。 实现前缀缓存:给一个 prompt P 和几个补全,对 P 跑一次前向填满 KV 缓存,再按补全分支。测相比每个补全都重新编码 P 的加速。
- 困难。 实现一个玩具 PagedAttention:KV 缓存按固定 16 token 块加上一个空闲列表。一个序列完成时,把它的块还回池子。模拟 1,000 个不同长度的聊天补全。对比内存碎片相比连续分配的情况。
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| KV 缓存 | "让解码变快的把戏" | 存下来自每个前缀 token 的 K 和 V;新 query 关注它们而不重算。 |
| HBM | "GPU 主存" | 高带宽内存;H100 上 80 GB,B200 上 192 GB。约 3 TB/s 带宽。 |
| SRAM | "片上内存" | 每个 SM 的快内存,H100 上每 SM 约 256 KB。约 30 TB/s 带宽。 |
| Flash Attention | "分块注意力 kernel" | 不在 HBM 物化 N×N 就算出注意力。 |
| 连续批处理 | "免等待批处理" | 把完成的序列换出、新的换入,不必排空批次。 |
| PagedAttention | "vLLM 招牌" | KV 缓存按固定块加页表分配;消除碎片。 |
| 前缀缓存 | "复用长 prompt" | 跨请求缓存共享前缀的 KV;为 agent 大幅削减成本。 |
| 投机解码 | "草稿 + 验证" | 廉价草稿模型提议 token;大模型一次通过验证 k 个。 |
延伸阅读
- Dao et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness —— Flash 1。
- Dao (2023). FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning —— Flash 2。
- Shah et al. (2024). FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision —— Flash 3。
- FlashAttention-4 release notes (Dao-AILab, 2026) —— Blackwell 5 级流水线和软件 exp2 把戏;读 repo README 看本课提到的仅前向发布的注意事项。
- Kwon et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention —— vLLM 论文。
- Leviathan et al. (2023). Fast Inference from Transformers via Speculative Decoding —— 投机解码。
- Li et al. (2024). EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty —— 本课引用的集成草稿方法的 EAGLE-1/2 论文。
- Cai et al. (2024). Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads —— 和 EAGLE 一起提到的 Medusa 方法。
- vLLM docs — PagedAttention —— 关于 16 token 块和页表设计的规范深入解析。