条件 GAN 与 Pix2Pix
2014-2017 年的第一个大突破,是控制 GAN 造出来的东西。贴一个标签,或一张图像,或一句话。Pix2Pix 做了图像版本,在窄领域的图到图任务上,它至今仍打得过每一个通用文生图模型。
类型: Build 语言: Python 前置要求: 阶段 8 · 03(GAN)、阶段 4 · 06(U-Net)、阶段 3 · 07(CNN) 预计时间: ~75 分钟
问题背景
无条件 GAN 采样的是任意人脸。演示时有用,生产里没用。你想要的是:把一张草图映成照片、把一张地图映成航拍照、把白天的场景映成夜晚、给灰度图上色。在所有这些里,你拿到一张输入图像 x,必须输出一个与之有某种语义对应的 y。每个 x 对应许多个像样的 y。均方误差把它们摊平成一坨糊。对抗损失不会,因为「看起来像真的」是锐利的。
条件 GAN(Mirza & Osindero, 2014)把一个条件 c 同时作为输入喂给 G 和 D。Pix2Pix(Isola et al., 2017)把这个专门化了:条件是一整张输入图像,生成器是一个 U-Net,判别器是一个基于 patch 的分类器(PatchGAN),损失是对抗 + L1。这套配方在窄领域图到图上,即便到 2026 年仍胜过从零训练的文生图模型,因为它训练在成对数据上——你手里有的正是你需要的那个信号。
核心概念
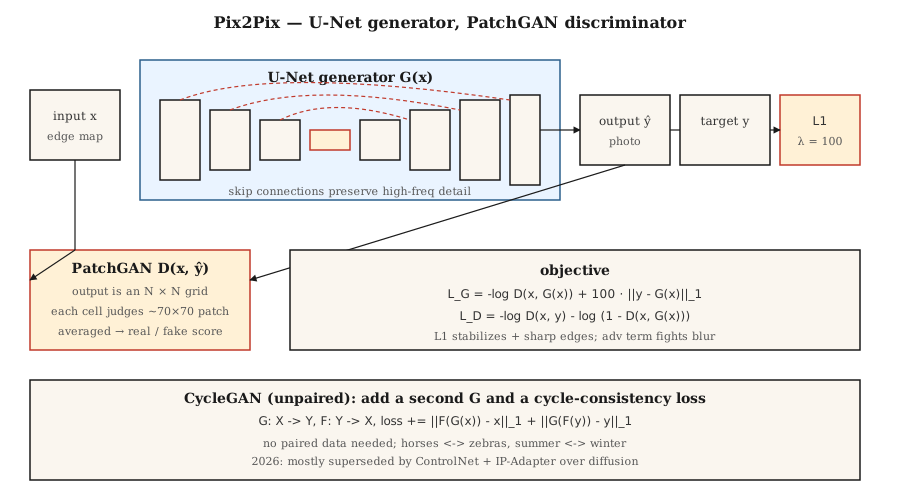
条件 G。 G(x, z) → y。在 Pix2Pix 里,z 是 G 内部的 dropout(没有输入噪声——Isola 发现显式噪声会被无视)。
条件 D。 D(x, y) → [0, 1]。输入是那一对(条件,输出)。这是关键区别:D 必须判断 y 是否与 x 相一致,而不只是 y 看起来像不像真的。
U-Net 生成器。 编码器-解码器,跨瓶颈带跳跃连接。对于输入输出共享底层结构(边缘、轮廓)的任务至关重要。没有跳跃连接,高频细节就消失了。
PatchGAN 判别器。 D 不输出单个真/假分数,而是输出一个 N×N 网格,每个格子判断一块约 70×70 像素的感受野。再取平均。这是一个马尔可夫随机场假设:真实性是局部的。训练快得多、参数更少、输出更锐。
损失。
loss_G = -log D(x, G(x)) + λ · ||y - G(x)||_1
loss_D = -log D(x, y) - log (1 - D(x, G(x)))
L1 项稳定训练,并把 G 往已知目标上推。L1 给出的边缘比 L2 更锐(取中位数,而不是均值)。λ = 100 是 Pix2Pix 的默认值。
CycleGAN —— 没有成对数据时
Pix2Pix 需要成对的 (x, y) 数据。CycleGAN(Zhu et al., 2017)以多一个损失为代价丢掉了这个要求:循环一致性损失。两个生成器 G: X → Y 和 F: Y → X。训练它们使 F(G(x)) ≈ x 且 G(F(y)) ≈ y。这让你能在没有成对样本的情况下把马变成斑马、把夏天变成冬天。
到 2026 年,无配对图到图大多用扩散(ControlNet、IP-Adapter)来做,而不是 CycleGAN,但循环一致性这个想法在几乎每篇无配对域适应论文里都活着。
gx-patchgan动手构建
code/main.py 在一维数据上实现一个迷你条件 GAN。条件 c 是一个类别标签(0 或 1)。任务:为给定类别从其条件分布里产出一个样本。
第 1 步:把条件拼接到 G 和 D 的输入上
def G(z, c, params):
    return mlp(concat([z, one_hot(c)]), params)

def D(x, c, params):
    return mlp(concat([x, one_hot(c)]), params)
one-hot 编码是最简单的办法。更大的模型用学出来的嵌入、FiLM 调制,或交叉注意力。
第 2 步:条件式训练
for step in range(steps):
    x, c = sample_real_conditional()
    noise = sample_noise()
    update_D(x_real=x, x_fake=G(noise, c), c=c)
update_G(noise, c)生成器必须匹配给定条件下的真实分布,而不是边缘分布。
第 3 步:逐类别验证输出
for c in [0, 1]:
    samples = [G(noise, c) for noise in batch]
    mean_c = mean(samples)
    assert_near(mean_c, real_mean_for_class_c)
坑
- 条件被无视。 G 学会去边缘化,D 从不惩罚是因为条件信号太弱。解法:更激进地条件化 D(早层,不只是晚层)、用投影判别器(Miyato & Koyama 2018)。
- L1 权重太低。 G 漂向任意看起来像真的输出,而不是忠实的输出。Pix2Pix 风格的任务从 λ≈100 起步。
- L1 权重太高。 G 产出模糊输出,因为 L1 终究还是一个 L_p 范数。训练稳定后把它退火调低。
- D 里的真值泄露。 把
(x, y)拼接起来作 D 的输入,而不只是y。没有这个,D 没法核查一致性。 - 逐类别的模式坍缩。 每个类别可以各自独立地坍缩。跑类别条件的多样性检查。
实际使用
2026 年图到图任务的现状:
| 任务 | 最佳做法 |
|---|---|
| 草图 → 照片,同领域,成对数据 | Pix2Pix / Pix2PixHD(仍然快,仍然锐) |
| 草图 → 照片,无配对 | 带 Scribble 条件模型的 ControlNet |
| 语义分割 → 照片 | SPADE / GauGAN2,或 SD + ControlNet-Seg |
| 风格迁移 | 带 IP-Adapter 或 LoRA 的扩散;GAN 方法是遗产了 |
| 深度 → 照片 | 在 Stable Diffusion 上跑 ControlNet-Depth |
| 超分辨率 | Real-ESRGAN(GAN)、ESRGAN-Plus,或 SD-Upscale(扩散) |
| 上色 | ColTran、基于扩散的上色器,或 Pix2Pix-color |
| 白天 → 夜晚、四季、天气 | CycleGAN 或基于 ControlNet 的方法 |
当 (a) 你有成千上万个成对样本,(b) 任务窄且可重复,(c) 你需要快速推理时,Pix2Pix 仍是正确的工具。在通用开放领域任务上,扩散胜出。
拿去用
存为 outputs/skill-img2img-chooser.md。技能接受一段任务描述、数据可得性(成对 vs 无配对、N 个样本)和延迟/质量预算,然后输出:做法(Pix2Pix、CycleGAN、某个 ControlNet 变体、SDXL + IP-Adapter)、训练数据需求、推理成本,以及评测流程(LPIPS、FID、任务专属指标)。
练习
- 简单。 改
code/main.py,加上第三个类别。确认 G 仍能把每个类别的噪声映到正确的模式。 - 中等。 在这个一维场景里把 L1 换成一个感知风格的损失(比如用一个小的冻结 D 当特征提取器)。它会改变条件分布的锐度吗?
- 困难。 在一维场景里勾勒一个 CycleGAN:两个分布、两个生成器、循环损失。证明它能在没有成对数据的情况下学会在它们之间映射。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 条件 GAN | 「带标签的 GAN」 | G(z, c),D(x, c)。两个网络都看到条件。 |
| Pix2Pix | 「图到图 GAN」 | 带 U-Net G 和 PatchGAN D + L1 损失的成对 cGAN。 |
| U-Net | 「带跳跃连接的编码器-解码器」 | 对称卷积网络;跳跃连接保住高频。 |
| PatchGAN | 「局部真实性分类器」 | D 输出逐 patch 的分数而不是全局分数。 |
| CycleGAN | 「无配对图像翻译」 | 两个 G + 循环一致性损失;不需要成对数据。 |
| SPADE | 「GauGAN」 | 用语义图归一化中间激活;分割图到图像。 |
| FiLM | 「逐特征线性调制」 | 由条件给出的逐特征仿射变换;廉价的条件化。 |
生产笔记:把 Pix2Pix 当延迟受限的基线
当你有成对数据和一个窄任务(草图 → 渲染、语义图 → 照片、白天 → 夜晚)时,Pix2Pix 的一次到位推理在延迟上比扩散快一个数量级。生产上的对比通常是:
| 路径 | 步数 | 单张 L4 上 512² 的典型延迟 |
|---|---|---|
| Pix2Pix(U-Net 前向) | 1 | ~30 ms |
| SD-Inpaint 或 SD-Img2Img | 20 | ~1.2 s |
| SDXL-Turbo Img2Img | 1-4 | ~0.15-0.35 s |
| ControlNet + SDXL base | 20-30 | ~3-5 s |
在静态批里 Pix2Pix 在吞吐上胜出(每个请求 FLOPs 相同)。扩散在质量和泛化上胜出。现代的打法常常是:为窄任务上线一个 Pix2Pix 风格的蒸馏模型,再用一个扩散兜底来处理长尾输入。
延伸阅读
- Mirza & Osindero (2014). Conditional Generative Adversarial Nets —— cGAN 那篇论文。
- Isola et al. (2017). Image-to-Image Translation with Conditional Adversarial Networks —— Pix2Pix。
- Zhu et al. (2017). Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks —— CycleGAN。
- Wang et al. (2018). High-Resolution Image Synthesis with Conditional GANs —— Pix2PixHD。
- Park et al. (2019). Semantic Image Synthesis with Spatially-Adaptive Normalization —— SPADE / GauGAN。
- Miyato & Koyama (2018). cGANs with Projection Discriminator —— 投影 D。