Multi-Head Attention
一个注意力头一次学一种关系。八个头学八种。头是免费的,多搞几个。
类型: Build 语言: Python 前置要求: 阶段 7 · 02(从零实现 Self-Attention) 预计时间: ~75 分钟
问题背景
单个 self-attention 头计算一个注意力矩阵。这个矩阵捕捉一种关系——通常是那个最能压低训练损失的关系。如果你的数据里主谓一致、共指、长程语篇、句法分块全缠在一起,单个头会把它们抹进一个 softmax 分布里,丢掉一半信号。
2017 年 Vaswani 论文给出的修法:并行跑几个注意力函数,每个有自己的 Q、K、V 投影,再把输出拼起来。每个头在一个维度为 d_model / n_heads 的更小子空间里工作。总参数量不变,表达力上去了。
multi-head attention 是 2026 年每个 transformer 出厂自带的默认配置。唯一还有争论的是头要多少个,以及 key 和 value 是否共享投影(Grouped-Query Attention、Multi-Query Attention、Multi-head Latent Attention)。
核心概念
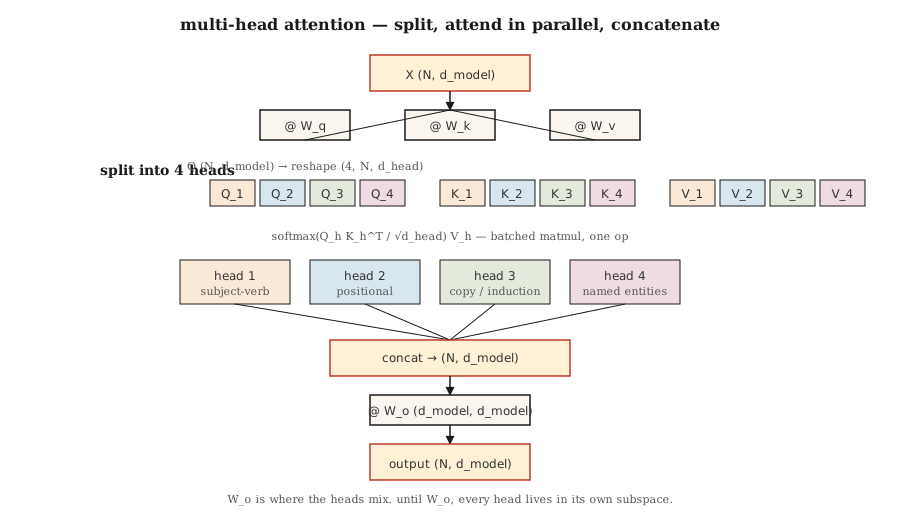
拆分。 取形状 (N, d_model) 的 X。投影到各自形状 (N, d_model) 的 Q、K、V。reshape 成 (N, n_heads, d_head),其中 d_head = d_model / n_heads。transpose 成 (n_heads, N, d_head)。
并行注意。 在每个头内部跑缩放点积注意力。每个头产出 (N, d_head)。这些头在嵌入的不同子空间上工作,注意力计算本身期间互不通信。
拼接并投影。 把头堆回 (N, d_model),再乘一个形状 (d_model, d_model) 的可学习输出矩阵 W_o。W_o 才是头之间混合的地方。
为什么有效。 每个头都能专精,不必和其他头抢表示预算。2019–2024 的探针研究显示出鲜明的头分工:位置头、关注前一个 token 的头、复制头、命名实体头、归纳头(in-context learning 的底层机制)。
2026 年的变体谱系:
| 变体 | Q 头数 | K/V 头数 | 谁在用 |
|---|---|---|---|
| Multi-head (MHA) | N | N | GPT-2、BERT、T5 |
| Multi-query (MQA) | N | 1 | PaLM、Falcon |
| Grouped-query (GQA) | N | G(如 N/8) | Llama 2 70B、Llama 3+、Qwen 2+、Mistral |
| Multi-head latent (MLA) | N | 压成低秩 | DeepSeek-V2、V3 |
GQA 是现代默认选择,因为它把 KV-cache 显存砍掉 N/G 倍,同时几乎保住全部质量。MLA 走得更远,把 K/V 压进一个潜空间,再在计算时投影回来——花 FLOPs,省更多显存。
multihead-split动手构建
第 1 步:在已有的单头注意力上拆分多头
拿第 02 课的 SelfAttention,用一对拆分/拼接把它包起来。numpy 实现见 code/main.py;逻辑是:
def split_heads(X, n_heads):
    n, d = X.shape
    d_head = d // n_heads
    return X.reshape(n, n_heads, d_head).transpose(1, 0, 2)  # (heads, n, d_head)

def combine_heads(H):
    h, n, d_head = H.shape
    return H.transpose(1, 0, 2).reshape(n, h * d_head)
一次 reshape 加一次 transpose,没有循环。这正是 PyTorch 在 nn.MultiheadAttention 底下做的事。
第 2 步:每个头跑缩放点积注意力
每个头拿到自己的那一片 Q、K、V。注意力变成一次批量 matmul:
def mha_forward(X, W_q, W_k, W_v, W_o, n_heads):
    Q = X @ W_q
    K = X @ W_k
    V = X @ W_v
    Qh = split_heads(Q, n_heads)         # (heads, n, d_head)
    Kh = split_heads(K, n_heads)
    Vh = split_heads(V, n_heads)
    scores = Qh @ Kh.transpose(0, 2, 1) / np.sqrt(Qh.shape[-1])
    weights = softmax(scores, axis=-1)
    out = weights @ Vh                    # (heads, n, d_head)
    concat = combine_heads(out)
    return concat @ W_o, weights
在真实硬件上 Qh @ Kh.transpose(...) 是一次 bmm。GPU 看到的是单次形状为 (heads, N, d_head) × (heads, d_head, N) -> (heads, N, N) 的批量 matmul。加头是免费的。
第 3 步:Grouped-Query Attention 变体
只有 key 和 value 投影变了。Q 拿 n_heads 组;K 和 V 拿 n_kv_heads < n_heads 组,再重复以对齐:
def gqa_project(X, W, n_kv_heads, n_heads):
    kv = split_heads(X @ W, n_kv_heads)       # (kv_heads, n, d_head)
    repeat = n_heads // n_kv_heads
    return np.repeat(kv, repeat, axis=0)      # (n_heads, n, d_head)
推理时这能省显存,因为 KV 缓存里只活着 n_kv_heads 份副本,不是 n_heads 份。Llama 3 70B 用 64 个 query 头配 8 个 KV 头——缓存缩小 8 倍。
第 4 步:探一探每个头学到了什么
在一个短句上用 4 个头跑 MHA。对每个头,打印 (N, N) 注意力矩阵。你会看到即便随机初始化,不同的头也会挑出不同的结构——这一部分是信号,一部分是子空间里的旋转对称性。
实际使用
在 PyTorch 里,一行版本:
import torch.nn as nn

mha = nn.MultiheadAttention(embed_dim=512, num_heads=8, batch_first=True)
PyTorch 2.5+ 里的 GQA:
from torch.nn.functional import scaled_dot_product_attention

# scaled_dot_product_attention 在 CUDA 上自动派发 Flash Attention。
# 对于 GQA,传入形状为 (B, n_heads, N, d_head) 的 Q,以及形状为
# (B, n_kv_heads, N, d_head) 的 K、V。PyTorch 负责重复。
out = scaled_dot_product_attention(q, k, v, is_causal=True, enable_gqa=True)
多少个头? 2026 年生产模型的经验法则:
| 模型规模 | d_model | n_heads | d_head |
|---|---|---|---|
| 小(~125M) | 768 | 12 | 64 |
| 基础(~350M) | 1024 | 16 | 64 |
| 大(~1B) | 2048 | 16 | 128 |
| 前沿(~70B) | 8192 | 64 | 128 |
d_head 几乎总是落在 64 或 128。它是衡量一个头能"看见"多少的单位。低于 32,头就开始和缩放因子 sqrt(d_head) 较劲;高于 256,你就失去了"许多小专家"的好处。
拿去用
见 outputs/skill-mha-configurator.md。这个 skill 会根据参数预算、序列长度和部署目标,为一个新 transformer 推荐头数、kv 头数和投影策略。
练习
- 简单。 拿
code/main.py里的 MHA,固定d_model=64,把n_heads从 1 改到 16。在一个合成复制任务上画出一个极小的单层模型的损失。更多的头是帮忙、持平还是帮倒忙? - 中等。 实现 MQA(一个 KV 头被所有 query 头共享)。测一测参数量相比完整 MHA 降了多少。计算在 N=2048 时推理的 KV 缓存大小缩小了多少。
- 困难。 实现一个迷你版 Multi-head Latent Attention:把 K、V 压成秩为
r的潜表示,把潜表示存进 KV 缓存,注意力时再解压。r取多少时,缓存显存能跌到完整 MHA 的 1/8 以下,同时质量还保持在验证 ppl 的 1 bit 之内?
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 头(Head) | "一个独立的注意力电路" | 一个维度为 d_head = d_model / n_heads 的 Q/K/V 投影,带自己的注意力矩阵。 |
| d_head | "头维度" | 每个头的隐藏宽度;生产中几乎总是 64 或 128。 |
| 拆分 / 合并 | "reshape 小把戏" | 在注意力前后做 (N, d_model) ↔ (n_heads, N, d_head) 的 reshape+transpose。 |
| W_o | "输出投影" | 拼接头之后作用的 (d_model, d_model) 矩阵;头在这里混合。 |
| MQA | "一个 KV 头" | Multi-Query Attention:单个共享的 K/V 投影。KV 缓存最小,有一些质量损失。 |
| GQA | "Llama 2 以来的默认" | Grouped-Query Attention,n_kv_heads < n_heads;重复以对齐 Q。 |
| MLA | "DeepSeek 的招" | Multi-head Latent Attention:K、V 压成低秩潜表示,注意力时解压。 |
| 归纳头(Induction head) | "in-context learning 背后的电路" | 一对头,检测之前出现过的内容并复制其后跟随的东西。 |
延伸阅读
- Vaswani et al. (2017). Attention Is All You Need §3.2.2 —— 最初的多头规格。
- Shazeer (2019). Fast Transformer Decoding: One Write-Head is All You Need —— MQA 论文。
- Ainslie et al. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints —— 如何在训练后把 MHA 转成 GQA。
- DeepSeek-AI (2024). DeepSeek-V2 Technical Report —— MLA 以及它为什么在缓存显存上打败 MHA/GQA。
- Olsson et al. (2022). In-context Learning and Induction Heads —— 机制性地看头到底在干什么。