对话状态跟踪
"I want a cheap restaurant in the north... actually make it moderate... and add Italian." 三轮,三次状态更新。DST 让槽位-值字典保持同步,预订才不出错。
类型: Build 语言: Python 前置要求: Phase 5 · 17(聊天机器人)、Phase 5 · 20(结构化输出) 预计时间: ~75 分钟
问题背景
在面向任务的对话系统里,用户的目标被编码成一组槽位-值对:\{cuisine: italian, area: north, price: moderate\}。用户的每一轮都可能新增、改变或移除一个槽位。系统必须读完整段对话,正确输出当前状态。
错一个槽位,系统就订错餐厅、订错航班、刷错卡。DST 是用户所说和后端所执行之间的那个铰链。
尽管有了 LLM,它在 2026 年为什么仍然要紧:
- 合规敏感领域(银行、医疗、机票预订)要求确定性的槽位值,而非自由生成。
- 工具使用 agent 在调 API 前仍需要槽位消解。
- 多轮纠正比看上去难:"actually no, make it Thursday."
现代流水线:经典 DST 概念 + LLM 抽取器 + 结构化输出护栏。
核心概念
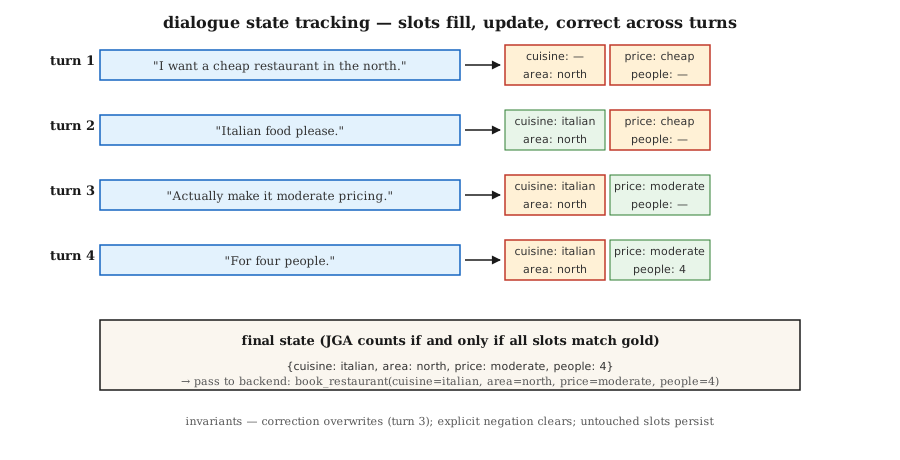
任务结构。 一个 schema 定义领域(restaurant、hotel、taxi)及其槽位(cuisine、area、price、people)。每个槽位可以为空、被一个闭集里的值填充(price: {cheap, moderate, expensive}),或填一个自由值(name: "The Copper Kettle")。
两种 DST 表述。
- 分类。 对每个 (slot, candidate_value) 对,预测是/否。对闭词表槽位管用。2020 年前的标准。
- 生成。 给定对话,把槽位值作为自由文本生成。对开词表槽位管用。现代默认。
指标。 联合目标准确率(JGA)——每个槽位都正确的轮次所占比例。全对或全错。MultiWOZ 2.4 排行榜在 2026 年顶部约 83%。
架构。
- 基于规则(槽位正则 + 关键词)。 窄领域的强基线。可调试。
- TripPy / BERT-DST。 带 BERT 编码的基于复制的生成。LLM 之前的标准。
- LDST(LLaMA + LoRA)。 用领域-槽位提示的指令微调 LLM。在 MultiWOZ 2.4 上达到 ChatGPT 级质量。
- 无本体(2024–26)。 跳过 schema;直接生成槽位名和值。处理开放领域。
- 提示 + 结构化输出(2024–26)。 配 Pydantic schema + 约束解码的 LLM。5 行代码,生产可用。
经典翻车方式
- 跨轮共指。 "Let's stay with the first option." 需要消解是哪个选项。
- 覆盖 vs 追加。 用户说 "add Italian."。你是替换 cuisine 还是追加?
- 隐式确认。 "OK cool"——这接受了提供的预订吗?
- 纠正。 "Actually make it 7 pm." 必须更新时间而不清掉其他槽位。
- 对前一句系统话语的共指。 "Yes, that one." 哪个 "that"?
n5-slot-tracker动手构建
第 1 步:基于规则的槽位抽取器
见 code/main.py。正则 + 同义词词典在窄领域里覆盖 70% 的规范话语:
CUISINE_SYNONYMS = {
    "italian": ["italian", "pasta", "pizza", "italy"],
    "chinese": ["chinese", "chow mein", "noodles"],
}

def extract_cuisine(utterance):
    for canonical, synonyms in CUISINE_SYNONYMS.items():
        if any(syn in utterance.lower() for syn in synonyms):
            return canonical
    return None
出了规范词表就脆。对确定性的槽位确认管用。
第 2 步:状态更新循环
def update_state(state, utterance):
    new_state = dict(state)
    for slot, extractor in SLOT_EXTRACTORS.items():
        value = extractor(utterance)
        if value is not None:
            new_state[slot] = value
    for slot in NEGATION_CLEARS:
        if is_negated(utterance, slot):
            new_state[slot] = None
    return new_state
三条不变量:
- 永远别重置用户没碰的槽位。
- 显式否定("never mind the cuisine")必须清掉。
- 用户纠正("actually...")必须覆盖,而非追加。
第 3 步:LLM 驱动的 DST 配结构化输出
from pydantic import BaseModel
from typing import Literal, Optional
import instructor

class RestaurantState(BaseModel):
    cuisine: Optional[Literal["italian", "chinese", "indian", "thai", "any"]] = None
    area: Optional[Literal["north", "south", "east", "west", "center"]] = None
    price: Optional[Literal["cheap", "moderate", "expensive"]] = None
    people: Optional[int] = None
    day: Optional[str] = None

def llm_dst(history, llm):
    prompt = f"""You track the slot values of a restaurant booking across turns.
Dialogue so far:
{render(history)}

Update the state based on the latest user turn. Output only the JSON state."""
    return llm(prompt, response_model=RestaurantState)
Instructor + Pydantic 保证一个有效的状态对象。没有正则,没有 schema 不匹配,没有幻觉出的槽位。
第 4 步:JGA 评估
def joint_goal_accuracy(predicted_states, gold_states):
    correct = sum(1 for p, g in zip(predicted_states, gold_states) if p == g)
    return correct / len(predicted_states)
校准:系统把所有槽位全答对的轮次占多少?对 MultiWOZ 2.4,2026 年顶尖系统:80-83%。你的领域内系统在你的窄词表上应当超过它,否则 LLM 基线就赢你了。
第 5 步:处理纠正
CORRECTION_CUES = {"actually", "no wait", "on second thought", "change that to"}

def is_correction(utterance):
    return any(cue in utterance.lower() for cue in CORRECTION_CUES)
检测到纠正时,覆盖最后更新的那个槽位,而非追加。没有 LLM 帮忙很难做对。现代模式:始终让 LLM 从历史里重新生成整个状态,而非增量更新——这天然地处理了纠正。
坑
- 全历史重生成成本。 让 LLM 每轮重新生成状态,总 token 成本是 O(n²)。给历史设上限或摘要旧轮次。
- schema 漂移。 事后新增槽位会破坏旧训练数据。给你的 schema 打版本。
- 大小写敏感。 "Italian" vs "italian" vs "ITALIAN"——到处归一化。
- 隐式继承。 如果用户之前指定了 "for 4 people",一个改时间的新请求不该清掉 people。永远传完整历史。
- 自由值 vs 闭集。 名字、时间、地址需要自由值槽位;cuisine 和 area 是闭集。在 schema 里两者混用。
实际使用
2026 年的栈:
| 场景 | 方法 |
|---|---|
| 窄领域(一两个意图) | 基于规则 + 正则 |
| 宽领域,有标注数据 | LDST(在 MultiWOZ 式数据上 LLaMA + LoRA) |
| 宽领域,无标注,生产可用 | LLM + Instructor + Pydantic schema |
| 语音 | ASR + 归一化器 + LLM-DST |
| 多领域预订流程 | 配每领域 Pydantic 模型的 schema 引导 LLM |
| 合规敏感 | 基于规则为主,LLM 兜底配确认流程 |
拿去用
存为 outputs/skill-dst-designer.md:
---
name: dst-designer
description: Design a dialogue state tracker — schema, extractor, update policy, evaluation.
version: 1.0.0
phase: 5
lesson: 29
tags: [nlp, dialogue, task-oriented]
---

Given a use case (domain, languages, vocab openness, compliance needs), output:

1. Schema. Domain list, slots per domain, open vs closed vocabulary per slot.
2. Extractor. Rule-based / seq2seq / LLM-with-Pydantic. Reason.
3. Update policy. Regenerate-whole-state / incremental; correction handling; negation handling.
4. Evaluation. Joint Goal Accuracy on a held-out dialogue set, slot-level precision/recall, confusion on the hardest slot.
5. Confirmation flow. When to explicitly ask the user to confirm (destructive actions, low-confidence extractions).

Refuse LLM-only DST for compliance-sensitive slots without a rule-based secondary check. Refuse any DST that cannot roll back a slot on user correction. Flag schemas without version tags.
练习
- 简单。 为 3 个槽位(cuisine、area、price)搭起
code/main.py里的基于规则状态跟踪器。在 10 段手工编写的对话上测试。测 JGA。 - 中等。 同一数据集用 Instructor + Pydantic + 一个小 LLM。对比 JGA。检查最难的那些轮次。
- 困难。 两者都实现并路由:基于规则为主,当基于规则带置信地吐出 <2 个槽位时用 LLM 兜底。测量组合 JGA 和每轮推理成本。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| DST | 对话状态跟踪 | 跨对话轮次维护槽位-值字典。 |
| 槽位(Slot) | 用户意图的单元 | 后端需要的具名参数(cuisine、date)。 |
| 领域(Domain) | 任务领域 | restaurant、hotel、taxi——成组的槽位。 |
| JGA | 联合目标准确率 | 每个槽位都正确的轮次所占比例。全对或全错。 |
| MultiWOZ | 那个基准 | 多领域 WOZ 数据集;标准 DST 评估。 |
| 无本体 DST | 没有 schema | 直接生成槽位名和值,不用固定列表。 |
| 纠正(Correction) | "Actually..." | 覆盖一个已填槽位的那一轮。 |
延伸阅读
- Budzianowski et al. (2018). MultiWOZ — A Large-Scale Multi-Domain Wizard-of-Oz —— 经典基准。
- Feng et al. (2023). Towards LLM-driven Dialogue State Tracking (LDST) —— 用于 DST 的 LLaMA + LoRA 指令微调。
- Heck et al. (2020). TripPy — A Triple Copy Strategy for Value Independent Neural Dialog State Tracking —— 基于复制的 DST 主力。
- King, Flanigan (2024). Unsupervised End-to-End Task-Oriented Dialogue with LLMs —— 基于 EM 的无监督 TOD。
- MultiWOZ leaderboard —— 经典 DST 结果。