3D 生成
3D 是 2D 到 3D 杠杆最强的那个模态。2023 年的突破是 3D 高斯泼溅。2024-2026 年的生成推进在它之上叠了多视角扩散 + 3D 重建,从单个 prompt 或一张照片产出物体和场景。
类型: Learn 语言: Python 前置要求: 阶段 4(视觉)、阶段 8 · 07(潜空间扩散) 预计时间: ~45 分钟
问题背景
3D 内容很折磨:
- 表示。 网格、点云、体素网格、有符号距离场(SDF)、神经辐射场(NeRF)、3D 高斯。每个都有取舍。
- 数据稀缺。 ImageNet 有 1400 万张图。最大的干净 3D 数据集(Objaverse-XL, 2023)约 1000 万个物体,大多质量低。
- 内存。 一个 512³ 体素网格是 1.28 亿个体素;一个有用的场景 NeRF 每条光线要 100 万个采样。生成比重建更难。
- 监督。 对一张 2D 图你有像素。对 3D 你通常只有寥寥几个 2D 视角,得提升到 3D。
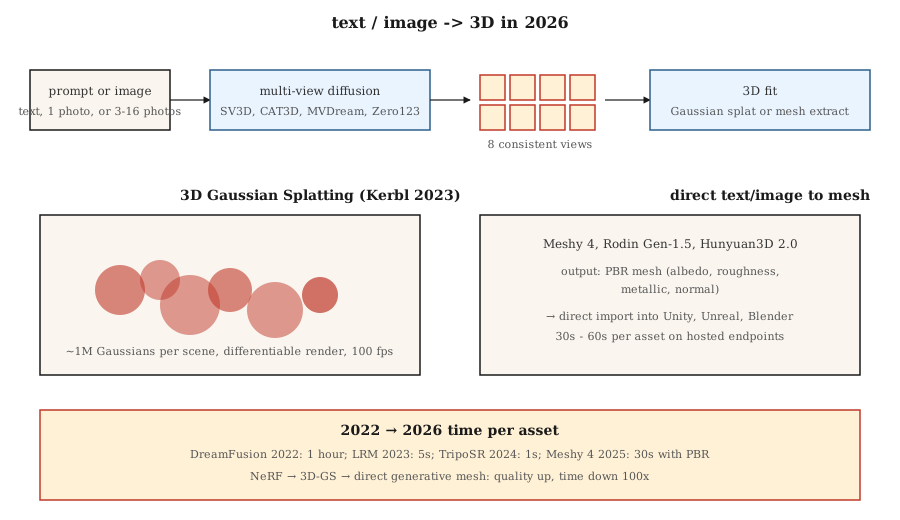
2026 年的栈把这两个问题分开。先用扩散模型生成 2D 多视角图像。再给那些图像拟合一个 3D 表示(通常是高斯泼溅)。
核心概念
表示:3D 高斯泼溅(Kerbl et al., 2023)
把场景表示成一团约 100 万个 3D 高斯的云。每个有 59 个参数:位置(3)、协方差(6,或四元数 4 + 缩放 3)、不透明度(1)、球谐颜色(3 阶时 48 个,0 阶时 3 个)。
渲染 = 投影 + alpha 合成。快(4090 上 1080p 约 100 fps)。可微。通过对真值照片做梯度下降来拟合。一个场景在消费级 GPU 上 5-30 分钟拟合完。
在它之上的两个 2023-2024 创新:
- 生成式高斯泼溅。 像 LGM、LRM、InstantMesh 这样的模型直接从一张或几张图预测一团高斯云。
- 4D 高斯泼溅。 带逐帧偏移的高斯,用于动态场景。
多视角扩散
微调一个预训练图像扩散模型,从一段文本 prompt 或单张图像生成同一物体的多个一致视角。Zero123(Liu et al., 2023)、MVDream(Shi et al., 2023)、SV3D(Stability, 2024)、CAT3D(Google, 2024)。通常输出绕物体一圈的 4-16 个视角,再通过高斯泼溅或 NeRF 提升到 3D。
文本到 3D 流水线
| 模型 | 输入 | 输出 | 时间 |
|---|---|---|---|
| DreamFusion (2022) | 文本 | 通过 SDS 得到 NeRF | 每个资产约 1 小时 |
| Magic3D | 文本 | 网格 + 纹理 | ~40 分钟 |
| Shap-E(OpenAI, 2023) | 文本 | 隐式 3D | ~1 分钟 |
| SJC / ProlificDreamer | 文本 | NeRF / 网格 | ~30 分钟 |
| LRM(Meta, 2023) | 图像 | triplane | ~5 秒 |
| InstantMesh (2024) | 图像 | 网格 | ~10 秒 |
| SV3D(Stability, 2024) | 图像 | 新视角 | ~2 分钟 |
| CAT3D(Google, 2024) | 1-64 张图像 | 3D NeRF | ~1 分钟 |
| TripoSR (2024) | 图像 | 网格 | ~1 秒 |
| Meshy 4 (2025) | 文本 + 图像 | PBR 网格 | ~30 秒 |
| Rodin Gen-1.5 (2025) | 文本 + 图像 | PBR 网格 | ~60 秒 |
| 腾讯 Hunyuan3D 2.0 (2025) | 图像 | 网格 | ~30 秒 |
2025-2026 年方向:直接的文本到网格模型,带适合游戏引擎的 PBR 材质。对通用物体,多视角扩散这一中间步骤仍是性能最好的配方。
NeRF(作为背景)
神经辐射场(Mildenhall et al., 2020)。一个迷你 MLP 接受 (x, y, z, 视角方向),输出 (颜色, 密度)。沿光线积分来渲染。在质量上胜过基于网格的新视角合成,但渲染慢 100-1000 倍。在大多数实时用途上被高斯泼溅取代,但在研究里仍占主导。
v4-3d-multiview动手构建
code/main.py 实现一个玩具 2D「高斯泼溅」拟合:把一张合成目标图像(一个平滑渐变)表示成一组 2D 高斯泼溅之和。通过梯度下降优化位置、颜色和协方差来匹配目标。你看到两个核心操作:前向渲染(泼溅 + alpha 合成)和梯度下降拟合。
第 1 步:2D 高斯泼溅
def gaussian_at(x, y, gaussian):
    px, py = gaussian["pos"]
    sigma = gaussian["sigma"]
    d2 = (x - px) ** 2 + (y - py) ** 2
    return math.exp(-d2 / (2 * sigma * sigma))
第 2 步:通过累加泼溅来渲染
def render(image_size, gaussians):
    img = [[0.0] * image_size for _ in range(image_size)]
    for g in gaussians:
        for y in range(image_size):
            for x in range(image_size):
                img[y][x] += g["color"] * gaussian_at(x, y, g)
    return img
真正的 3D 高斯泼溅按深度对高斯排序,再按序做 alpha 合成。我们的 2D 玩具只是累加。
第 3 步:梯度下降拟合
for step in range(steps):
    pred = render(size, gaussians)
    loss = mse(pred, target)
    gradients = compute_grads(pred, target, gaussians)
    update(gaussians, gradients, lr)
坑
- 视角不一致。 如果你独立生成 4 个视角,而它们在物体结构上各执一词,3D 拟合就会模糊。解法:带共享注意力的多视角扩散。
- 背面幻觉。 单图 → 3D 必须凭空编出看不见的那一面。质量参差不齐。
- 高斯泼溅爆炸。 无约束的训练会长到 1000 万个泼溅并过拟合。致密化 + 剪枝启发式(来自 3D-GS 原论文)是必需的。
- 拓扑问题。 来自隐式场(SDF)的网格常常有洞或自交。上线前跑一个重网格器(比如 blender 的体素重网格)。
- 训练数据的许可。 Objaverse 许可混杂;商用因模型而异。
实际使用
| 任务 | 2026 年的选择 |
|---|---|
| 从照片重建场景 | 高斯泼溅(3DGS、Gsplat、Scaniverse) |
| 给游戏用的文本到 3D 物体 | Meshy 4 或 Rodin Gen-1.5(PBR 输出) |
| 图像到 3D | Hunyuan3D 2.0、TripoSR、InstantMesh |
| 从少量图像做新视角合成 | CAT3D、SV3D |
| 动态场景重建 | 4D 高斯泼溅 |
| 头像 / 着衣人体 | Gaussian Avatar、HUGS |
| 研究 / SOTA | 上周刚出的那个 |
要在游戏或电商流水线里上线生产 3D:Meshy 4 或 Rodin Gen-1.5 输出的 PBR 网格能直接进 Unity / Unreal。
拿去用
存为 outputs/skill-3d-pipeline.md。技能接受一份 3D 需求(输入:文本 / 一张图像 / 少量图像;输出:网格 / 泼溅 / NeRF;用途:渲染 / 游戏 / VR),输出:流水线(多视角扩散 + 拟合,或直接网格模型)、基模型、迭代预算、拓扑后处理、需要的材质通道。
练习
- 简单。 用 4、16、64 个高斯跑
code/main.py。报告相对目标的最终 MSE。 - 中等。 扩展到彩色高斯(RGB)。确认重建匹配目标的颜色模式。
- 困难。 用 gsplat 或 Nerfstudio,从一次 50 张照片的采集重建一个真实物体。报告拟合时间和在留出视角上的最终 SSIM。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 3D 高斯泼溅 | 「3DGS」 | 把场景当一团 3D 高斯的云;可微的 alpha 合成渲染。 |
| NeRF | 「神经辐射场」 | 在一个 3D 点上输出颜色 + 密度的 MLP;通过光线积分渲染。 |
| Triplane | 「三个 2D 平面」 | 把 3D 因式分解成三个轴对齐的 2D 特征网格;比体素便宜。 |
| SDS | 「分数蒸馏采样」 | 用 2D 扩散的分数当伪梯度来训练 3D 模型。 |
| 多视角扩散 | 「一次出多个视角」 | 输出一批一致相机视角的扩散模型。 |
| PBR | 「基于物理的渲染」 | 带反照率、粗糙度、金属度、法线通道的材质。 |
| 致密化 | 「长泼溅」 | 3DGS 训练启发式:在高梯度区域分裂 / 克隆泼溅。 |
生产笔记:3D 还没有共享底座
不像图像(潜空间扩散 + DiT)和视频(时空 DiT),3D 在 2026 年没有单一主导的运行时。生产决策树在表示上分叉:
- NeRF / triplane。 推理是光线步进 + 每个采样一次 MLP 前向。一张 512² 的渲染需要数百万次 MLP 前向。激进地批处理光线采样;SDPA/xformers 适用。
- 多视角扩散 + LRM 重建。 两阶段流水线。第一阶段(多视角 DiT)就是个像第 07 课那样的扩散服务器。第二阶段(LRM transformer)是对这些视角的一次到位前向。整体延迟画像是「扩散 + 一次到位」——据此分别为每个阶段挑服务原语。
- SDS / DreamFusion。 逐资产优化,不是推理。建的是批处理作业,不是请求处理器。
对大多数 2026 年的产品,正确答案是「按请求跑一个多视角扩散模型,异步重建成 3DGS,提供 3DGS 用于实时查看」。这把工作负载干净地分到一个 GPU 推理服务器(快)和一个离线优化器(慢)之间。
延伸阅读
- Mildenhall et al. (2020). NeRF: Representing Scenes as Neural Radiance Fields —— NeRF。
- Kerbl et al. (2023). 3D Gaussian Splatting for Real-Time Radiance Field Rendering —— 3DGS。
- Poole et al. (2022). DreamFusion: Text-to-3D using 2D Diffusion —— SDS。
- Liu et al. (2023). Zero-1-to-3: Zero-shot One Image to 3D Object —— Zero123。
- Shi et al. (2023). MVDream —— 多视角扩散。
- Hong et al. (2023). LRM: Large Reconstruction Model for Single Image to 3D —— LRM。
- Gao et al. (2024). CAT3D: Create Anything in 3D with Multi-View Diffusion Models —— CAT3D。
- Stability AI (2024). Stable Video 3D (SV3D) —— SV3D。