搭一条语音助手流水线 —— 第 6 阶段顶点项目
把第 01-11 课的一切缝到一起。搭一个会听、会推理、会说话的语音助手。2026 年这是一个已经解决的工程问题,不是研究问题——但集成细节决定它能不能上线。
类型: Build 语言: Python 前置要求: 阶段 6 · 04、05、06、07、11;阶段 11 · 09(函数调用);阶段 14 · 01(Agent 循环) 预计时间: ~120 分钟
问题背景
搭一个端到端助手:
- 捕获麦克风输入(16 kHz 单声道)。
- 检测用户说话的开始/结束。
- 流式转写。
- 把转写文本交给一个能调工具(计时器、天气、日历)的 LLM。
- 把 LLM 文本流给一个 TTS。
- 把音频放回给用户。
- 用户在回应中途打断时停下来。
延迟目标:在笔记本 CPU 上,用户说完后 800 ms 内出第一个 TTS 音频字节。质量目标:不漏词、静音上不产生幻觉字幕、不泄漏语音克隆、prompt 注入不得逞。
核心概念
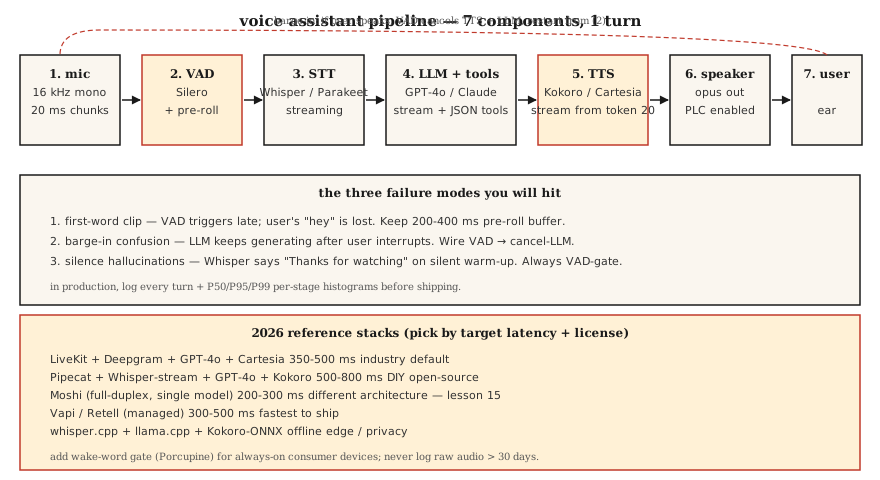
七个组件
- 音频捕获。 麦克风 → 16 kHz 单声道 → 20 ms 块。Python 里通常用
sounddevice,生产里用原生 AudioUnit/ALSA/WASAPI。 - VAD(第 11 课)。 Silero VAD @ 阈值 0.5,最短语音 250 ms,静音挂起 500 ms。给出「开始」和「结束」信号。
- 流式 STT(第 4-5 课)。 Whisper-streaming、Parakeet-TDT,或 Deepgram Nova-3(API)。部分 + 最终转写。
- 带工具调用的 LLM。 GPT-4o / Claude 3.5 / Gemini 2.5 Flash。工具用 JSON schema。流式吐 token。
- 流式 TTS(第 7 课)。 Kokoro-82M(最快的开源)或 Cartesia Sonic(商用)。LLM 吐出 20 个 token 后就启动 TTS。
- 播放。 扬声器输出;低带宽网络下做 opus 编码。
- 打断处理器。 如果 TTS 播放时 VAD 触发,就停播放、取消 LLM、重启 STT。
你会撞上的三种失败模式
- 首词被切。 VAD 起步晚了一拍。用户的「hey」没了。起始阈值设 0.3,不是 0.5。
- 回应中途打断的混乱。 用户打断后 LLM 还在生成;助手压着用户说。把 VAD → 取消 LLM 接好。
- 静音幻觉。 Whisper 在静音的热身帧上输出「Thanks for watching」。永远 VAD 把门。
2026 年生产参考栈
| 栈 | 延迟 | 许可证 | 备注 |
|---|---|---|---|
| LiveKit + Deepgram + GPT-4o + Cartesia | 350-500 ms | 商用 API | 2026 年行业默认 |
| Pipecat + Whisper-streaming + GPT-4o + Kokoro | 500-800 ms | 大体开源 | DIY 友好 |
| Moshi(全双工) | 200-300 ms | CC-BY 4.0 | 单模型;不同架构,第 15 课 |
| Vapi / Retell(托管) | 300-500 ms | 商用 | 上线最快;定制有限 |
| Whisper.cpp + llama.cpp + Kokoro-ONNX | 离线 | 开源 | 隐私 / 边缘端 |
figure
v4-voice-latency动手构建
第 1 步:带分块的麦克风捕获(伪代码)
python
import sounddevice as sd

def mic_stream(chunk_ms=20, sr=16000):
    q = queue.Queue()
    def cb(indata, frames, time, status):
        q.put(indata.copy().flatten())
    with sd.InputStream(channels=1, samplerate=sr, blocksize=int(sr * chunk_ms/1000), callback=cb):
        while True:
            yield q.get()
第 2 步:VAD 把门的轮次捕获
python
def capture_turn(stream, vad, pre_roll_ms=300, silence_ms=500):
    buf, pre, triggered = [], collections.deque(maxlen=pre_roll_ms // 20), False
    silent = 0
    for chunk in stream:
        pre.append(chunk)
        if vad(chunk):
            if not triggered:
                buf = list(pre)
                triggered = True
            buf.append(chunk)
            silent = 0
        elif triggered:
            silent += 20
            buf.append(chunk)
            if silent >= silence_ms:
                return b"".join(buf)
第 3 步:流式 STT → LLM → TTS
python
async def turn(audio_bytes):
    transcript = await stt.transcribe(audio_bytes)
    async for token in llm.stream(transcript):
        async for audio in tts.stream(token):
            await speaker.play(audio)
第 4 步:LLM 循环里的工具调用
python
tools = [
    {"name": "get_weather", "parameters": {"location": "string"}},
    {"name": "set_timer", "parameters": {"seconds": "int"}},
]

async for chunk in llm.stream(user_text, tools=tools):
    if chunk.type == "tool_call":
        result = dispatch(chunk.name, chunk.args)
        continue_streaming(result)
    if chunk.type == "text":
        await tts.stream(chunk.text)
第 5 步:打断处理
python
tts_task = asyncio.create_task(tts_loop())
while True:
    chunk = await mic.get()
    if vad(chunk):
        tts_task.cancel()
        await speaker.stop()
        await new_turn()
        break
实际使用
看 code/main.py,里面是一个可运行的模拟,用桩模型把七个组件全接起来,这样你不用硬件也能看到流水线的形状。要做真实实现,把桩换成:
silero-vad(pip install silero-vad)deepgram-sdk或openai-whisperopenai(gpt-4o)或anthropickokoro或cartesiasounddevice做 I/O
坑
- 永久记录 PII。 整轮音频在大多数司法辖区算 PII。保留 30 天,静态加密。
- 没有插话处理。 用户一定会打断。你的助手必须停下来。
- 会阻塞的 TTS。 同步 TTS 会阻塞事件循环。用异步或单独线程。
- 没有工具调用错误处理。 工具会失败。LLM 必须拿回错误 + 重试一次,然后优雅降级。
- 过激的幻觉过滤器。 过滤太狠,助手反复说「这个我帮不了」。过滤太松,它什么都敢说。在留出集上校准。
- 没有唤醒词选项。 一直在听是隐私负债。加一个唤醒词闸门(Porcupine 或 openWakeWord)。
拿去用
存为 outputs/skill-voice-assistant-architect.md。给定预算 + 规模 + 语种 + 合规约束,产出一份完整的栈规格。
练习
- 简单。 跑
code/main.py。它用桩模块端到端模拟一个完整轮次,并打印各阶段延迟。 - 中等。 把 STT 桩换成一个真实的 Whisper 模型,作用在一段预录的
.wav上。测量 WER 和端到端延迟。 - 困难。 加上工具调用:实现
get_weather(任意 API)和set_timer。把 LLM 接到工具上,验证当用户说「set a 5 minute timer」时正确的函数触发,且口语回应确认了它。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 轮次(Turn) | 一次用户 + 助手往返 | 一段 VAD 界定的用户语音 + 一次 LLM-TTS 回应。 |
| 插话(Barge-in) | 打断 | 用户在助手说话时开口;助手停下。 |
| 唤醒词 | 「Hey assistant」 | 短关键词检测器;Porcupine、Snowboy、openWakeWord。 |
| 端点判定(End-pointing) | 轮次结束 | VAD + 最短静音判定用户已说完。 |
| 预滚(Pre-roll) | 说话前缓冲 | 在 VAD 触发前留 200-400 ms 音频,避免首词被切。 |
| 工具调用 | 函数调用 | LLM 吐出 JSON;运行时分发;结果在循环内回喂。 |
延伸阅读
- LiveKit — voice agent quickstart —— 生产级参考。
- Pipecat — voice agent examples —— DIY 友好的框架。
- OpenAI Realtime API —— 托管的语音原生路线。
- Kyutai Moshi —— 全双工参考(第 15 课)。
- Porcupine wake-word —— 唤醒词把门。
- Anthropic — tool use guide —— LLM 函数调用。