Scaling Laws
2020 年的 Kaplan 论文说:模型越大,损失越低。2022 年的 Hoffmann 论文说:你训练不足了。算力分进两个桶——参数和 token——而怎么分并不显而易见。
类型: Learn 语言: Python 前置要求: 阶段 7 · 05(完整的 Transformer)、阶段 7 · 07(GPT) 预计时间: ~45 分钟
问题背景
当你有 C 个 FLOPs 的训练算力、想要最好的模型时,你面对两个旋钮:
- 多少参数(N)? 模型越大,容量越高。
- 多少训练 token(D)? 数据越多,越能用好容量。
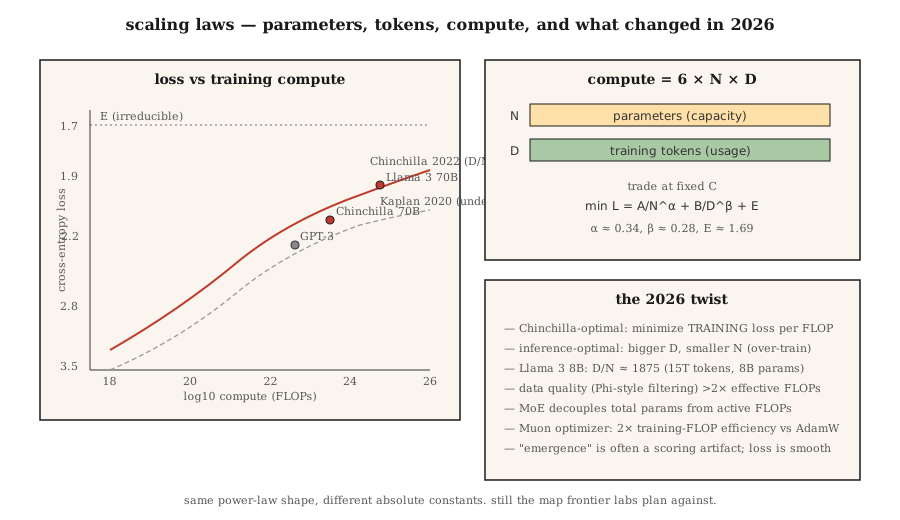
FLOPs 大约按 6 × N × D 增长。你可以把 N 推高、D 压低,或者 D 推高、N 压低。哪个更好?
2022 年之前,答案是"使劲推 N"。GPT-3(2020)是 1750 亿参数,在约 3000 亿 token 上训练。每参数约 1.7 个 token 的比例。Kaplan scaling laws 支持这个做法。
Hoffmann et al.(2022)训练了一小族叫 Chinchilla 的模型,发现了不一样的东西:最优比例更接近每参数 20 个 token。GPT-3 训练不足了 10 倍。Chinchilla(70B 参数、1.4T token)在每个基准上打败 GPT-3(175B、300B token),推理成本还低 2.5 倍。
2026 年是 Chinchilla 的天下——但有一个重要的转折。Llama 3 8B 在 15 万亿 token 上训练,每参数 1,875 个 token 的比例。超出 Chinchilla 最优 94 倍。对于将被大规模使用的模型,推理成本比训练成本更重要,所以为了更小的可部署体积而过度训练(超过 Chinchilla)是 2026 年的默认。
核心概念
Hoffmann 定律
来自 Chinchilla 论文,损失遵循:
L(N, D) = A / N^α + B / D^β + EN= 参数(非嵌入)。D= 训练 token。α ≈ 0.34、β ≈ 0.28(大致对称)。E ≈ 1.69,不可约的损失上限。A ≈ 406、B ≈ 411。
随着你扩展,两项相互权衡。在固定算力(C = 6ND)下对 N 求导并解:
N_opt ≈ 0.6 × (C/6)^0.5
D_opt ≈ 0.6 × (C/6)^0.5
D_opt / N_opt ≈ 20
算力最优:每参数 20 个 token。
为什么还是要过度训练
Chinchilla 最优让每个训练 FLOP 的训练损失最小。但训练成本只付一次;推理成本付一辈子。
对于一个每月服务一万亿 token 的聊天机器人,推理主导总成本。Llama 的做法:训得更小、更久。8B 配 15T token 是深度推理优化的:
- 能塞进消费级 GPU。
- 延迟是 70B Chinchilla 最优的零头。
- 质量对大多数任务足够接近。
DeepMind 2024 年的论文("过度训练才是新的最优")把这个形式化了。对推理主导的负载,正确比例更接近每参数 100–500 个 token,取决于服务量。
涌现 vs 平滑
有种说法:某些能力(算术、多步推理、跟随思维链)在某个规模"涌现"出来,突如其来。
Schaeffer et al.(2023)认为这是个测量假象:涌现指标用不连续的打分(精确匹配、阈值准确率),这掩盖了底层 logits 里平滑的改善。连续指标(交叉熵)显示的是平滑曲线。
2026 年的共识是:通过连续损失做的预测是可靠的。基准上的跳跃往往是打分器假象。按连续指标规划预算。
2026 年的图景
scaling laws 仍然有效,但是:
| 因素 | 改变了什么 |
|---|---|
| 数据质量 | 精选"好" token(Phi 风格)让曲线移动 >2× 的有效算力 |
| MoE | 总参数和激活 FLOPs 解耦;scaling laws 按每激活 FLOP 算 |
| 后训练 | 某些能力(指令跟随、代码)随 SFT+RLHF 的移动比预训练更大 |
| 多模态 | 图像 + 文本 token 一起扩展;每种模态单独的曲线 |
| 合成数据 | 模型生成训练数据;有效算力可以复利 |
Muon 优化器(Kimi Moonlight,2024)在同等数据下展示出相比 AdamW 约 2× 的有效算力增益。2026 年一些训练任务默认用 Muon。它改变 scaling law 里的绝对常数,不改它的形状。
scaling-laws动手构建
见 code/main.py。我们实现 Chinchilla 损失方程,并在几个算力预算下分别解出算力最优的 (N, D)。
第 1 步:Chinchilla 损失
def chinchilla_loss(N, D, A=406.4, B=410.7, alpha=0.34, beta=0.28, E=1.69):
    return A / N ** alpha + B / D ** beta + E
在固定 C = 6ND 下把 L 画成 (N, D) 上的等高线。找最小值。
第 2 步:算力最优前沿
对从 1e17 到 1e25 FLOPs 的算力预算,找出在 6ND = C 约束下最小化损失的 (N, D)。验证比例 D/N ≈ 20。
第 3 步:过度训练的代价
算一算训练一个小 10 倍的模型(最优 N 的 1/10、最优 D 的 10 倍)要多付的损失。报告作为交换得到的推理 FLOP 节省(与 N 成比例)。
第 4 步:和真实模型对比
代入 GPT-3、Chinchilla、Llama 3 8B、DeepSeek-V3(激活参数)的已知 (N, D) 对,对比预测损失和报告损失。
实际使用
你不太可能自己训练一个前沿模型。但 scaling laws 告诉你:
- 你的微调数据够不够。 如果你的任务专属数据低于基础模型每参数 20 个 token,预期会在某个损失下限饱和。
- 要不要选更大的基础模型。 如果你把全部预算花在推理上,偏向更小、训得更久的模型。
- 收益在哪里递减。 超过 Chinchilla 最优 1000 倍后,log-loss 的变化就成了噪声。
2026 年的研究轨迹:
- 数据受限区间。 网络上高质量 token 的数量是有限的(过滤后约 5–10 万亿英语 token)。前沿预训练正逼近这个上限。合成数据、多语种、多模态和 RLHF 扩展的微调是下一批杠杆。
- 算力倍增器把戏。 Muon 优化器、MoE、更好的数据精选——每个都移动绝对常数,不移动渐近线。
- RL 的 scaling laws。 开放问题。早期证据暗示 RL 样本上是幂律,但指数和预训练非常不同。
拿去用
见 outputs/skill-training-budget-estimator.md。这个 skill 会根据算力预算、部署约束和目标损失,为一次新训练任务挑选 (N, D, hours, GPU)。
练习
- 简单。 跑
code/main.py。打印算力预算1e20、1e22、1e24下的 Chinchilla 最优(N, D)。和真实模型表对比。 - 中等。 实现 Hoffmann 损失作为算力函数的曲线。对算力最优前沿画损失 vs
log10(C)。找出定律预测我们需要>10^28FLOPs 才能让交叉熵再降 0.1 的那个点。 - 困难。 在同一数据集上训练的 5 个极小模型(10 万到 1000 万参数)上拟合你自己的 scaling law。估计
α和E。你的指数和已发表的匹配得怎么样?
关键术语
| 术语 | 大家嘴上怎么说 | 实际是什么意思 |
|---|---|---|
| 参数(N) | "模型大小" | 非嵌入权重数;决定容量。 |
| Token(D) | "训练数据" | 见过的训练 token 数;决定参数被用得多好。 |
| 算力(C) | "花掉的 FLOPs" | 标准 transformer 约为 6 × N × D。 |
| Chinchilla 最优 | "D/N ≈ 20" | 让每个预训练 FLOP 损失最小的比例。 |
| 过度训练 | "超过 Chinchilla" | 多花训练 FLOPs 省推理 FLOPs;D/N >> 20。 |
| 不可约损失 | "下限" | scaling law 里的 E 项;数据本身的熵。 |
| 涌现能力 | "规模上的突然跳跃" | 常是打分器假象;连续损失是平滑的。 |
| 有效算力 | "训练效率倍增器" | 更好的数据 / 优化器 / 架构让一个 FLOP 走得更远。 |
延伸阅读
- Kaplan et al. (2020). Scaling Laws for Neural Language Models —— 第一篇 scaling law 论文;训练不足。
- Hoffmann et al. (2022). Training Compute-Optimal Large Language Models —— Chinchilla。
- Schaeffer et al. (2023). Are Emergent Abilities of Large Language Models a Mirage? —— 涌现作为测量假象。
- Sardana, Frankle (2024). Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws —— 为什么 Llama 的过度训练对它的负载是对的。
- Jordan et al. (2024). Muon: An optimizer for hidden layers in neural networks —— 2× 算力倍增器。