结构化输出与约束解码
让 LLM 给你 JSON。大多数时候它给 JSON。在生产里,"大多数"就是问题所在。约束解码在采样前编辑 logits,把"大多数"变成"永远"。
类型: Build 语言: Python 前置要求: Phase 5 · 17(聊天机器人)、Phase 5 · 19(子词分词) 预计时间: ~60 分钟
问题背景
一个分类器给 LLM 下 prompt:"Return one of {positive, negative, neutral}."。模型返回 "The sentiment is positive — this review is overwhelmingly favorable because the customer explicitly states that they ..."。你的解析器崩了。你分类器的 F1 是 0.0。
自由格式生成不是契约,是建议。生产系统需要的是契约。
2026 年存在三层。
- Prompting。 好言相求。"Return only the JSON object."。在前沿模型上约 80% 管用,小模型上更低。
- 原生结构化输出 API。 OpenAI
response_format、Anthropic 工具使用、Gemini JSON 模式。在支持的 schema 上可靠。锁定厂商。 - 约束解码。 在每个生成步骤修改 logits,让模型不可能吐出非法 token。构造上 100% 有效。在任何本地模型上都管用。
这节课为三者建立直觉,并点明何时该抓哪个。
核心概念
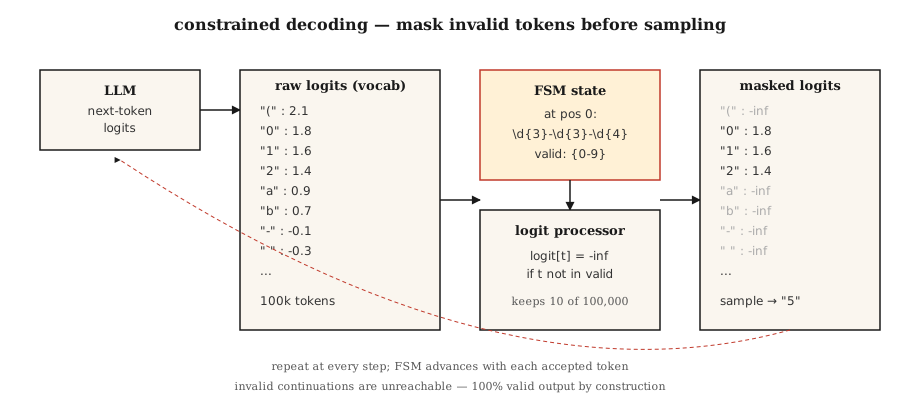
约束解码如何工作。 在每个生成步骤,LLM 在整个词表上(~10 万 token)产出一个 logit 向量。一个 logit 处理器坐在模型和采样器之间。它根据当前在目标文法(JSON Schema、正则、上下文无关文法)里的位置算出哪些 token 有效,并把所有非法 token 的 logits 设成负无穷。对剩余 logits 做 softmax,只把概率质量放在有效的延续上。
2026 年的实现:
- Outlines。 把 JSON Schema 或正则编译成有限状态机。每个 token 都有 O(1) 的有效下一 token 查找。基于 FSM,所以递归 schema 需要拍平。
- XGrammar / llguidance。 上下文无关文法引擎。处理递归 JSON Schema。近乎零解码开销。OpenAI 在他们 2025 年的结构化输出实现里点名了 llguidance。
- vLLM 引导解码。 通过 Outlines、XGrammar 或 lm-format-enforcer 后端,内置
guided_json、guided_regex、guided_choice、guided_grammar。 - Instructor。 基于 Pydantic 的、套在任何 LLM 上的封装。校验失败时重试。跨厂商,但不修改 logits——它靠重试 + 感知结构化输出的 prompt。
反直觉的结果
约束解码常常比无约束生成更快。两个原因。第一,它缩小了下一 token 的搜索空间。第二,聪明的实现对被强制的 token 完全跳过生成(像 \{"name": " 这样的脚手架——每个字节都已确定)。
会让你付代价的坑
字段顺序很要紧。把 answer 放在 reasoning 之前,模型就在思考之前先认定了答案。JSON 有效,答案错了。没有校验能抓住这个。
// BAD
{"answer": "yes", "reasoning": "because ..."}

// GOOD
{"reasoning": "... therefore ...", "answer": "yes"}
Schema 字段顺序是逻辑,不是格式。
constrained-decoder动手构建
第 1 步:从零做正则约束生成
独立的 FSM 实现见 code/main.py。30 行里的核心思想:
def mask_logits(logits, valid_token_ids):
    mask = [float("-inf")] * len(logits)
    for tid in valid_token_ids:
        mask[tid] = logits[tid]
    return mask

def generate_constrained(model, tokenizer, prompt, fsm):
    ids = tokenizer.encode(prompt)
    state = fsm.initial_state
    while not fsm.is_accept(state):
        logits = model.next_token_logits(ids)
        valid = fsm.valid_tokens(state, tokenizer)
        logits = mask_logits(logits, valid)
        tok = sample(logits)
        ids.append(tok)
        state = fsm.transition(state, tok)
    return tokenizer.decode(ids)
FSM 跟踪我们目前满足了文法的哪些部分。valid_tokens(state, tokenizer) 算出哪些词表 token 能在不离开接受路径的前提下推进 FSM。
第 2 步:用 Outlines 处理 JSON Schema
from pydantic import BaseModel
from typing import Literal
import outlines

class Review(BaseModel):
    sentiment: Literal["positive", "negative", "neutral"]
    confidence: float
    evidence_span: str

model = outlines.models.transformers("meta-llama/Llama-3.2-3B-Instruct")
generator = outlines.generate.json(model, Review)

result = generator("Classify: 'The wait staff was attentive and the food arrived hot.'")
print(result)
# Review(sentiment='positive', confidence=0.93, evidence_span='attentive ... hot')
零校验错误。永远。FSM 让非法输出无法到达。
第 3 步:用 Instructor 做厂商无关的 Pydantic
import instructor
from anthropic import Anthropic
from pydantic import BaseModel, Field

class Invoice(BaseModel):
    vendor: str
    total_usd: float = Field(ge=0)
    line_items: list[str]

client = instructor.from_anthropic(Anthropic())
invoice = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=1024,
    response_model=Invoice,
    messages=[{"role": "user", "content": "Extract from: 'Acme Corp $420. Widget, Gizmo.'"}],
)
机制不同。Instructor 不碰 logits。它把 schema 写进 prompt,解析输出,校验失败时重试(默认 3 次)。和任何厂商都能用。重试增加延迟和成本。跨厂商可移植性是它的卖点。
第 4 步:原生厂商 API
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-5",
    input=[{"role": "user", "content": "Classify: 'The food was cold.'"}],
    text={"format": {"type": "json_schema", "name": "sentiment",
          "schema": {"type": "object", "required": ["sentiment"],
                     "properties": {"sentiment": {"type": "string",
                                                  "enum": ["positive", "negative", "neutral"]}}}}},
)
print(response.output_parsed)
服务端约束解码。在支持的 schema 上和 Outlines 可靠性持平。不用管本地模型。把你锁在厂商上。
坑
- 递归 schema。 Outlines 把递归拍平到固定深度。树形结构输出(嵌套评论、AST)需要 XGrammar 或 llguidance(基于 CFG)。
- 巨大的枚举。 10000 选项的枚举编译很慢或超时。换成检索器:先预测 top-k 候选,再约束到那些。
- 文法太严。 强制
date: "YYYY-MM-DD"正则,模型就没法对缺失日期输出"unknown"。模型靠编一个日期来补偿。允许null或一个哨兵值。 - 过早认定。 见上面的字段顺序坑。永远把 reasoning 放前面。
- 没 schema 的厂商 JSON 模式。 纯 JSON 模式只保证有效 JSON,不保证对你的用例有效。永远提供完整 schema。
实际使用
2026 年的栈:
| 场景 | 选择 |
|---|---|
| OpenAI/Anthropic/Google 模型,简单 schema | 原生厂商结构化输出 |
| 任意厂商,Pydantic 工作流,能容忍重试 | Instructor |
| 本地模型,需要 100% 有效,扁平 schema | Outlines(FSM) |
| 本地模型,递归 schema | XGrammar 或 llguidance |
| 自托管推理服务器 | vLLM 引导解码 |
| 可接受重试的批处理 | Instructor + 最便宜的模型 |
拿去用
存为 outputs/skill-structured-output-picker.md:
---
name: structured-output-picker
description: Choose a structured output approach, schema design, and validation plan.
version: 1.0.0
phase: 5
lesson: 20
tags: [nlp, llm, structured-output]
---

Given a use case (provider, latency budget, schema complexity, failure tolerance), output:

1. Mechanism. Native vendor structured output, Instructor retries, Outlines FSM, or XGrammar CFG. One-sentence reason.
2. Schema design. Field order (reasoning first, answer last), nullable fields for "unknown", enum vs regex, required fields.
3. Failure strategy. Max retries, fallback model, graceful `null` handling, out-of-distribution refusal.
4. Validation plan. Schema compliance rate (target 100%), semantic validity (LLM-judge), field-coverage rate, latency p50/p99.

Refuse any design that puts `answer` or `decision` before reasoning fields. Refuse to use bare JSON mode without a schema. Flag recursive schemas behind an FSM-only library.
练习
- 简单。 对一个小的开放权重模型(如 Llama-3.2-3B)不用约束解码,为
Review(sentiment, confidence, evidence_span)下 prompt。在 100 条评论上测能解析为有效 JSON 的比例。 - 中等。 同一语料用 Outlines JSON 模式。对比合规率、延迟和语义准确率。
- 困难。 从零为电话号码(
\d\{3\}-\d\{3\}-\d\{4\})实现一个正则约束解码器。在 1000 个样本上验证 0 个非法输出。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| 约束解码 | 强制有效输出 | 在每个生成步骤掩掉非法 token 的 logits。 |
| logit 处理器 | 那个做约束的东西 | 函数:(logits, state) -> masked_logits。 |
| FSM | 有限状态机 | 编译后的文法表示;O(1) 的有效下一 token 查找。 |
| CFG | 上下文无关文法 | 处理递归的文法;比 FSM 慢但更具表达力。 |
| Schema 字段顺序 | 它要紧吗? | 要紧——第一个字段就认定了;永远把 reasoning 放在 answer 之前。 |
| 引导解码 | vLLM 给它起的名字 | 同一个概念,集成进推理服务器。 |
| JSON 模式 | OpenAI 的早期版本 | 保证 JSON 语法;不保证 schema 匹配。 |
延伸阅读
- Willard, Louf (2023). Efficient Guided Generation for LLMs —— Outlines 论文。
- XGrammar paper (2024) —— 快速的基于 CFG 的约束解码。
- vLLM — Structured Outputs —— 推理服务器集成。
- OpenAI — Structured Outputs guide —— API 参考 + 坑。
- Instructor library —— 跨厂商的 Pydantic + 重试。
- JSONSchemaBench (2025) —— 对 6 个约束解码框架的基准测试。