主题建模 —— LDA 与 BERTopic
LDA:文档是主题的混合,主题是词上的分布。BERTopic:文档在 embedding 空间里聚类,簇就是主题。目标相同,分解方式不同。
类型: Learn 语言: Python 前置要求: Phase 5 · 02(BoW + TF-IDF)、Phase 5 · 03(Word2Vec) 预计时间: ~45 分钟
问题背景
你手上有 10000 张客服工单、50000 篇新闻,或者 200000 条推文。你需要知道这堆东西在讲什么,又不想读它。你没有标注好的类别。你甚至不知道有多少个类别。
主题建模无需监督就能回答这个。给它一个语料,它给你一小组连贯的主题,以及每篇文档在这些主题上的分布。
两个算法家族占主导。LDA(2003)把每篇文档当作隐主题的混合,把每个主题当作词上的分布。推断是贝叶斯式的。在你需要混合成员归属和可解释的词级概率分布时,它至今还在生产里出现。
BERTopic(2020)用 BERT 编码文档,用 UMAP 降维,用 HDBSCAN 聚类,再通过基于类的 TF-IDF 抽取主题词。它在短文本、社交媒体,以及任何语义相似度比词重叠更重要的地方胜出。一篇文档得到一个主题,这对长篇内容是个局限。
这节课为两者建立直觉,并点明给定语料该挑哪一个。
核心概念
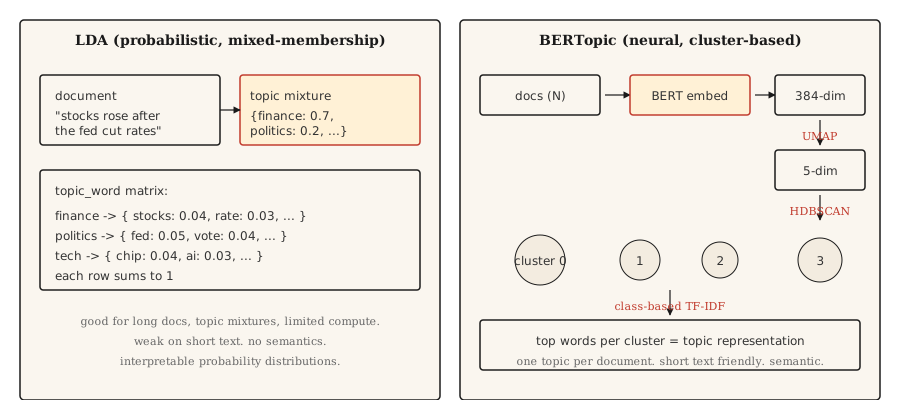
LDA 的生成故事。 每个主题是词上的分布。每篇文档是主题的混合。要在文档里生成一个词,先从文档的混合里采样一个主题,再从那个主题的分布里采样一个词。推断把这个倒过来:给定观测到的词,推断每篇文档的主题分布和每个主题的词分布。折叠 Gibbs 采样或变分贝叶斯来算这个数学。
LDA 的关键输出:
doc_topic:矩阵(n_docs, n_topics),每行求和为 1(文档的主题混合)。topic_word:矩阵(n_topics, vocab_size),每行求和为 1(主题的词分布)。
BERTopic 流水线。
- 用一个 sentence transformer(比如
all-MiniLM-L6-v2)编码每篇文档。384 维向量。 - 用 UMAP 把维度降到约 5 维。BERT embedding 维度太高,没法直接聚类。
- 用 HDBSCAN 聚类。基于密度,产出可变大小的簇和一个"离群"标签。
- 对每个簇,在簇内文档上算基于类的 TF-IDF,抽出最靠前的词。
输出是每篇文档一个主题(外加一个 -1 离群标签)。可选地,通过 HDBSCAN 的概率向量给出软成员归属。
topic-drift动手构建
第 1 步:用 scikit-learn 做 LDA
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation
import numpy as np

def fit_lda(documents, n_topics=5, max_features=1000):
    cv = CountVectorizer(
        max_features=max_features,
        stop_words="english",
        min_df=2,
        max_df=0.9,
    )
    X = cv.fit_transform(documents)
    lda = LatentDirichletAllocation(
        n_components=n_topics,
        random_state=42,
        max_iter=50,
        learning_method="online",
    )
    doc_topic = lda.fit_transform(X)
    feature_names = cv.get_feature_names_out()
    return lda, cv, doc_topic, feature_names

def print_top_words(lda, feature_names, n_top=10):
    for idx, topic in enumerate(lda.components_):
        top_idx = np.argsort(-topic)[:n_top]
        words = [feature_names[i] for i in top_idx]
        print(f"topic {idx}: {' '.join(words)}")
注意:去掉停用词,min_df 和 max_df 过滤罕见和无处不在的词,用 CountVectorizer(而非 TfidfVectorizer),因为 LDA 期望原始计数。
第 2 步:BERTopic(生产)
from bertopic import BERTopic

topic_model = BERTopic(
    embedding_model="sentence-transformers/all-MiniLM-L6-v2",
    min_topic_size=15,
    verbose=True,
)

topics, probs = topic_model.fit_transform(documents)
info = topic_model.get_topic_info()
print(info.head(20))
valid_topics = info[info["Topic"] != -1]["Topic"].tolist()
for topic_id in valid_topics[:5]:
    print(f"topic {topic_id}: {topic_model.get_topic(topic_id)[:10]}")
Topic != -1 的过滤丢掉了 BERTopic 的离群桶(HDBSCAN 没能聚类的文档)。min_topic_size 控制 HDBSCAN 的最小簇大小;BERTopic 库的默认是 10。这个例子为了配合本课的规模显式设成 15。语料超过 10000 篇文档时,增大到 50 或 100。
第 3 步:评估
两种方法都输出主题词。问题在于这些词是否连贯。
- 主题连贯度(c_v)。 在滑动窗口上下文里,把最靠前词对的 NPMI(归一化点互信息)组合起来,聚合成主题向量,再用余弦相似度比较这些向量。越高越好。用
gensim.models.CoherenceModel配coherence="c_v"。 - 主题多样性。 所有主题的最靠前词里独特词所占比例。越高越好(主题不重叠)。
- 定性检查。 读每个主题的最靠前词。它们能命名一个真实的东西吗?人类判断仍是最后一道防线。
该挑哪个
| 场景 | 选择 |
|---|---|
| 短文本(推文、评论、标题) | BERTopic |
| 带主题混合的长文档 | LDA |
| 无 GPU / 算力有限 | LDA 或 NMF |
| 需要文档级的多主题分布 | LDA |
| 集成 LLM 做主题打标 | BERTopic(直接支持) |
| 资源受限的边缘部署 | LDA |
| 极致语义连贯度 | BERTopic |
最大的实际考量是文档长度。BERT embedding 会截断;LDA 计数对任意长度都管用。文档比 embedding 模型上下文还长时,要么分块 + 聚合,要么用 LDA。
实际使用
2026 年的栈:
- BERTopic。 短文本及任何语义要紧场景的默认。
gensim.models.LdaModel。 生产用的经典 LDA,成熟、久经考验。sklearn.decomposition.LatentDirichletAllocation。 做实验用的省事 LDA。- NMF。 非负矩阵分解。LDA 的快速替代,在短文本上质量相当。
- Top2Vec。 设计与 BERTopic 类似。社区更小,但在某些基准上不错。
- FASTopic。 更新,在超大语料上比 BERTopic 快。
- 基于 LLM 的打标。 跑任意聚类,然后让模型给每个簇命名。
拿去用
存为 outputs/skill-topic-picker.md:
---
name: topic-picker
description: Pick LDA or BERTopic for a corpus. Specify library, knobs, evaluation.
version: 1.0.0
phase: 5
lesson: 15
tags: [nlp, topic-modeling]
---

Given a corpus description (document count, avg length, domain, language, compute budget), output:

1. Algorithm. LDA / NMF / BERTopic / Top2Vec / FASTopic. One-sentence reason.
2. Configuration. Number of topics: `recommended = max(5, round(sqrt(n_docs)))`, clamped to 200 for corpora under 40,000 docs; permit >200 only when the corpus is genuinely large (>40k) and note the increased compute cost. `min_df` / `max_df` filters and embedding model for neural approaches also belong here.
3. Evaluation. Topic coherence (c_v) via `gensim.models.CoherenceModel`, topic diversity, and a 20-sample human read.
4. Failure mode to probe. For LDA, "junk topics" absorbing stopwords and frequent terms. For BERTopic, the -1 outlier cluster swallowing ambiguous documents.

Refuse BERTopic on documents longer than the embedding model's context window without a chunking strategy. Refuse LDA on very short text (tweets, reviews under 10 tokens) as coherence collapses. Flag any n_topics choice below 5 as likely wrong; flag >200 on corpora under 40k docs as likely over-splitting.
练习
- 简单。 在 20 Newsgroups 数据集上拟合 5 个主题的 LDA。打印每个主题最靠前的 10 个词。手工给每个主题打标。算法找到真实类别了吗?
- 中等。 在同一个 20 Newsgroups 子集上拟合 BERTopic。把找到的主题数、最靠前的词、定性连贯度和 LDA 对比。哪个把真实类别浮现得更干净?
- 困难。 在你的语料上分别为 LDA 和 BERTopic 计算 c_v 连贯度。各跑 5、10、20、50 个主题。画连贯度对主题数的曲线。报告哪种方法在不同主题数下更稳定。
关键术语
| 术语 | 人们怎么说 | 它实际是什么 |
|---|---|---|
| 主题(Topic) | 语料在讲的某个东西 | 词上的概率分布(LDA)或相似文档的一个簇(BERTopic)。 |
| 混合成员归属 | 一篇文档属于多个主题 | LDA 给每篇文档分配一个在所有主题上的分布。 |
| UMAP | 降维 | 保留局部结构的流形学习;用在 BERTopic 里。 |
| HDBSCAN | 密度聚类 | 找出可变大小的簇;给离群点产出"噪声"标签(-1)。 |
| c_v 连贯度 | 主题质量指标 | 滑动窗口内最靠前主题词的平均点互信息。 |
延伸阅读
- Blei, Ng, Jordan (2003). Latent Dirichlet Allocation —— LDA 论文。
- Grootendorst (2022). BERTopic: Neural topic modeling with a class-based TF-IDF procedure —— BERTopic 论文。
- Röder, Both, Hinneburg (2015). Exploring the Space of Topic Coherence Measures —— 引入 c_v 及其同类的那篇论文。
- BERTopic documentation —— 生产参考。例子极好。