Whisper —— 架构与微调
Whisper 是一个 30 秒窗口的 transformer 编码器-解码器,在 68 万小时的多语种弱监督音频-文本对上训练。一套架构,多种任务,跨 99 种语言都鲁棒。2026 年的 ASR 参照物。
类型: Build 语言: Python 前置要求: 阶段 6 · 04(ASR)、阶段 5 · 10(注意力)、阶段 7 · 05(完整 Transformer) 预计时间: ~75 分钟
问题背景
Whisper 由 OpenAI 在 2022 年 9 月发布,是第一个像日用品一样交付的 ASR 模型:贴进音频,拿到文本,99 种语言,抗噪,能在笔记本上跑。到 2024 年 OpenAI 已经放出了 Large-v3 和 Turbo 变体;到 2026 年,从播客转写到语音助手再到 YouTube 字幕,Whisper 是这一切的默认基线。
但 Whisper 不是一条你可以永远当黑盒用的流水线。域偏移会把它干翻——技术行话、说话人口音、专有名词、短音频、静音。你得知道:
- 它内部到底是什么。
- 怎么正确地把分块、流式或长音频喂给它。
- 什么时候该微调、怎么微调。
核心概念
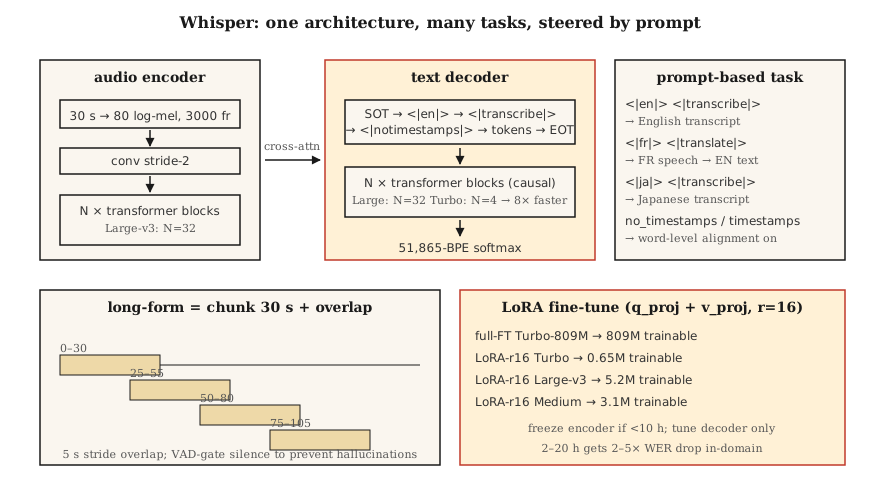
架构。 标准的 transformer 编码器-解码器。
- 输入:30 秒的对数梅尔频谱图,80 个梅尔,10 ms 跳步 → 3000 帧。更短的音频补零,更长的音频分块。
- 编码器:卷积下采样(步长 2)+
N个 transformer 块。Large-v3 是:32 层,1280 维,20 个头。 - 解码器:
N个 transformer 块,带因果自注意力 + 对编码器输出的交叉注意力。和编码器同尺寸。 - 输出:51,865 个 token 词表上的 BPE token。
Large-v3 有 15.5 亿参数。Turbo 用 4 层解码器(从 32 层砍下来),延迟降到 1/8,WER 只损失 <1%。
prompt 格式。 Whisper 是一个由解码器 prompt 里的特殊 token 操控的多任务模型:
<|startoftranscript|><|en|><|transcribe|><|notimestamps|> Hello world.<|endoftext|><|en|>—— 语言标签;决定走翻译还是转写的行为。<|transcribe|>或<|translate|>—— 把任意语言输入翻成英语输出,或逐字转写。<|notimestamps|>—— 跳过词级时间戳(更快)。
正是 prompt 让一个模型能干多种任务。把 <|en|> 换成 <|fr|>,它就转写法语。
30 秒窗口。 一切都钉死在 30 秒上。更长的音频要分块;更短的要补齐。窗口原生不支持流式——这正是 WhisperX、Whisper-Streaming 和 faster-whisper 存在的原因。
对数梅尔归一化。 (log_mel - mean) / std,统计量来自 Whisper 自己的训练语料。你必须用 Whisper 的预处理(whisper.audio.log_mel_spectrogram),不能用 librosa.feature.melspectrogram。
2026 年的各种变体
| 变体 | 参数量 | 延迟(A100) | WER(LibriSpeech-clean) |
|---|---|---|---|
| Tiny | 39M | 1× 实时 | 5.4% |
| Base | 74M | 1× | 4.1% |
| Small | 244M | 1× | 3.0% |
| Medium | 769M | 1× | 2.7% |
| Large-v3 | 1.55B | 2× | 1.8% |
| Large-v3-turbo | 809M | 8× | 1.58% |
| Whisper-Streaming(2024) | 1.55B | 流式 | 2.0% |
微调
2026 年的经典流程:
- 收集 10–100 小时目标领域音频,带对齐的转写文本。
- 跑
transformers.Seq2SeqTrainer,配generate_with_loss回调。 - 参数高效:在注意力层的
q_proj、k_proj、v_proj上做 LoRA,GPU 内存降 4 倍,WER 代价 <0.3。 - 如果只有 <10 小时数据,就冻结编码器,只调解码器。
- 用 Whisper 自己的分词器和 prompt 格式;绝不换分词器。
社区结果:在 20 小时医疗口述上微调 Medium,医疗词汇上的 WER 从 12% 降到 4.5%。在 4 小时冰岛语上微调 Turbo,WER 从 18% 降到 6%。
sp-asr-attention动手构建
第 1 步:开箱即用跑 Whisper
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe(
    "clip.wav",
    language="en",
    task="transcribe",
    temperature=0.0,
    condition_on_previous_text=False,  # 防止失控重复
)
print(result["text"])
for seg in result["segments"]:
print(f"[{seg['start']:.2f}–{seg['end']:.2f}] {seg['text']}")你该永远覆盖的几个关键默认值:temperature=0.0(采样默认走 0.0 → 0.2 → 0.4 … 的回退链)、condition_on_previous_text=False(防止级联幻觉问题)、no_speech_threshold=0.6(静音检测)。
第 2 步:分块长音频
# whisperx 是 2026 年长音频 + 词级时间戳的参照实现
import whisperx
model = whisperx.load_model("large-v3-turbo", device="cuda", compute_type="float16")
segments = model.transcribe("1hour.mp3", batch_size=16, chunk_size=30)
WhisperX 加了 (1) Silero VAD 把门,(2) 通过 wav2vec 2.0 做词级对齐,(3) 通过 pyannote.audio 做说话人分离。它是 2026 年生产转写的主力。
第 3 步:用 LoRA 微调
from transformers import WhisperForConditionalGeneration, WhisperProcessor
from peft import LoraConfig, get_peft_model

model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-large-v3-turbo")
lora = LoraConfig(
    r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"],
    lora_dropout=0.1, bias="none", task_type="SEQ_2_SEQ_LM",
)
model = get_peft_model(model, lora)
# model.print_trainable_parameters()  -> ~3M trainable / 809M total
接着标准的 Trainer 循环。每 1000 步存一次 checkpoint。在留出集上用 WER 评估。
第 4 步:观察每一层学到了什么
# 解码时抓出交叉注意力权重,看解码器在关注什么。
with torch.inference_mode():
    out = model.generate(
        input_features=features,
        return_dict_in_generate=True,
        output_attentions=True,
    )
# out.cross_attentions: layer × head × step × src_len
用热力图可视化——你会看到解码器逐步扫过编码器帧时呈现的对角对齐。那条对角线就是 Whisper 对词级时间戳的理解。
实际使用
2026 年的工具栈:
| 情形 | 选 |
|---|---|
| 通用英语、离线 | 通过 whisperx 用 Large-v3-turbo |
| 移动端 / 边缘端 | 量化的 Whisper-Tiny(int8)或 Moonshine |
| 多语种长音频 | 通过 whisperx 用 Large-v3 + 说话人分离 |
| 低资源语言 | 用 LoRA 微调 Medium 或 Turbo |
| 流式(2 秒延迟) | Whisper-Streaming 或 Parakeet-TDT |
| 词级时间戳 | WhisperX(通过 wav2vec 2.0 做强制对齐) |
faster-whisper(CTranslate2 后端)是 2026 年最快的 CPU+GPU 推理运行时——比原版快 4 倍,输出完全一致。
2026 年仍在上线的坑
- 静音上的幻觉文本。 Whisper 在字幕上训练,里面混着 "Thanks for watching!"、"Subscribe!"、歌词。调用前永远用 VAD 把门。
condition_on_previous_text级联。 一个幻觉会污染后续窗口。除非你需要跨块的流畅性,否则设False。- 短音频补齐。 一段 2 秒音频补齐到 30 秒,可能在尾部静音里产生幻觉。用
pad=False或 VAD 把门。 - 梅尔统计量用错。 用 librosa 的梅尔而不是 Whisper 的,会产生近乎随机的输出。用
whisper.audio.log_mel_spectrogram。
拿去用
存为 outputs/skill-whisper-tuner.md。为给定领域设计一条 Whisper 微调或推理流水线。
练习
- 简单。 跑
code/main.py。它对一个 Whisper 风格的 prompt 做分词,计算解码后的 shape 预算,并打印一段 10 分钟音频的分块排程。 - 中等。 装上
faster-whisper,转写一段 10 分钟播客,对人工转写算 WER。试试language="auto"对比强制language="en"。 - 困难。 用 HF
datasets,挑一种 Whisper 吃力的语言(比如乌尔都语),在 2 小时数据上用 LoRA 微调 Medium 跑 2 个 epoch,报告 WER 差值。
关键术语
| 术语 | 大家嘴上怎么说 | 它实际指什么 |
|---|---|---|
| 30 秒窗口 | Whisper 的上限 | 硬性输入上限;更长的音频要分块。 |
| SOT | 转写起始 | `< |
| 时间戳 token | 时间对齐 | 每 0.02 s 的偏移在 51k 词表里都是一个特殊 token。 |
| Turbo | 那个快的变体 | 4 层解码器,快 8 倍,WER 退化 <1%。 |
| WhisperX | 那个长音频封装 | VAD + Whisper + wav2vec 对齐 + 说话人分离。 |
| LoRA 微调 | 高效调参 | 给注意力加低秩适配器;训练约 0.3% 的参数。 |
| 幻觉 | 那种静默失败 | Whisper 从噪声/静音里产出流畅的英语。 |
延伸阅读
- Radford et al. (2022). Whisper paper —— 最初的架构和训练配方。
- OpenAI (2024). Whisper Large-v3-turbo release —— 4 层解码器,8 倍加速。
- Bain et al. (2023). WhisperX —— 长音频、词级对齐、说话人分离。
- Systran — faster-whisper repo —— CTranslate2 支撑,快 4 倍。
- HuggingFace — Whisper fine-tune tutorial —— 经典的 LoRA / 全量微调走查。