9.2 为什么上下文工程重要
尽管模型的速度越来越快、可处理的数据规模越来越大,但我们观察到:LLM 和人类一样,在一定点上会“走神”或“混乱”。针堆找针(needle-in-a-haystack)类基准揭示了一个现象:<strong>上下文腐蚀(context rot)</strong>——随着上下文窗口中的 tokens 增加,模型从上下文中准确回忆信息的能力反而下降。
不同模型的退化曲线或许更平滑,但这一特征几乎在所有模型上都会出现。因此,<strong>上下文必须被视作一种有限资源,且具有边际收益递减</strong>。就像人类有有限的工作记忆容量一样,LLM 也有一笔“注意力预算”。每新增一个 token,都会消耗这笔预算的一部分,因此我们更需要谨慎地筛选哪些 tokens 应该被提供给 LLM。
这种稀缺并非偶然,而是源自 LLM 的架构约束。Transformer 让每个 token 能够与上下文中的<strong>所有</strong> token 建立关联,理论上形成 (n^2) 级别的两两注意力关系。随着上下文长度增长,模型对这些两两关系的建模能力会被“拉薄”,从而自然地产生“上下文规模”与“注意力集中度”的张力。此外,模型的注意力模式来源于训练数据分布——短序列通常比长序列更常见,因此模型对“全上下文依赖”的经验更少、专门参数也更少。
诸如位置编码插值(position encoding interpolation)等技术可以让模型在推理时“适配”比训练期更长的序列,但会牺牲部分对 token 位置的精确理解。总体上,这些因素共同形成的是一个<strong>性能梯度</strong>,而非“悬崖式”崩溃:模型在长上下文下依旧强大,但相较短上下文,在信息检索与长程推理上的精度会有所下降。
基于上述现实,<strong>有意识的上下文工程</strong>就成为构建强健智能体的必需品。
9.2.1 有效上下文的“解剖学”
在“有限注意力预算”的约束下,优秀的上下文工程目标是:<strong>用尽可能少、但高信号密度的 tokens,最大化获得期望结果的概率</strong>。落实到实践中,我们建议围绕以下组件开展工程化建设:
<strong>系统提示(System Prompt)</strong>:语言清晰、直白,信息层级把握在“刚刚好”的高度。常见两极误区:
- 过度硬编码:在提示中写入复杂、脆弱的 if-else 逻辑,长期维护成本高、易碎。
- 过于空泛:只给出宏观目标与泛化指引,缺少对期望输出的<strong>具体信号</strong>或假定了错误的“共享上下文”。 建议将提示分区组织(如 <background_information>、<instructions>、工具指引、输出描述等),用 XML/Markdown 分隔。无论格式如何,追求的是<strong>能完整勾勒期望行为的“最小必要信息集”</strong>(“最小”并不等于“最短”)。先用最好的模型在最小提示上试跑,再依据失败模式增补清晰的指令与示例。
<strong>工具(Tools)</strong>:工具定义了智能体与信息/行动空间的契约,必须促进效率:既要返回<strong>token 友好</strong>的信息,又要鼓励高效的智能体行为。工具应当:
- 职责单一、相互低重叠,接口语义清晰;
- 对错误鲁棒;
- 入参描述明确、无歧义,充分发挥模型擅长的表达与推理能力。 常见失败模式是“臃肿工具集”:功能边界模糊,导致“选哪个工具”这一决策本身就含混不清。<strong>如果人类工程师都说不准用哪个工具,别指望智能体做得更好</strong>。精心甄别一个“最小可行工具集(MVTS)”往往能显著提升长期交互中的稳定性与可维护性。
<strong>示例(Few-shot)</strong>:始终推荐提供示例,但不建议把“所有边界条件”的罗列一股脑塞进提示。请精挑细选一组<strong>多样且典型</strong>的示例,直接画像“期望行为”。对 LLM 而言,<strong>好的示例胜过千言万语</strong>。
总的指导思想是:<strong>信息充分但紧致</strong>。如图9.2所示,是进入运行时的动态检索。
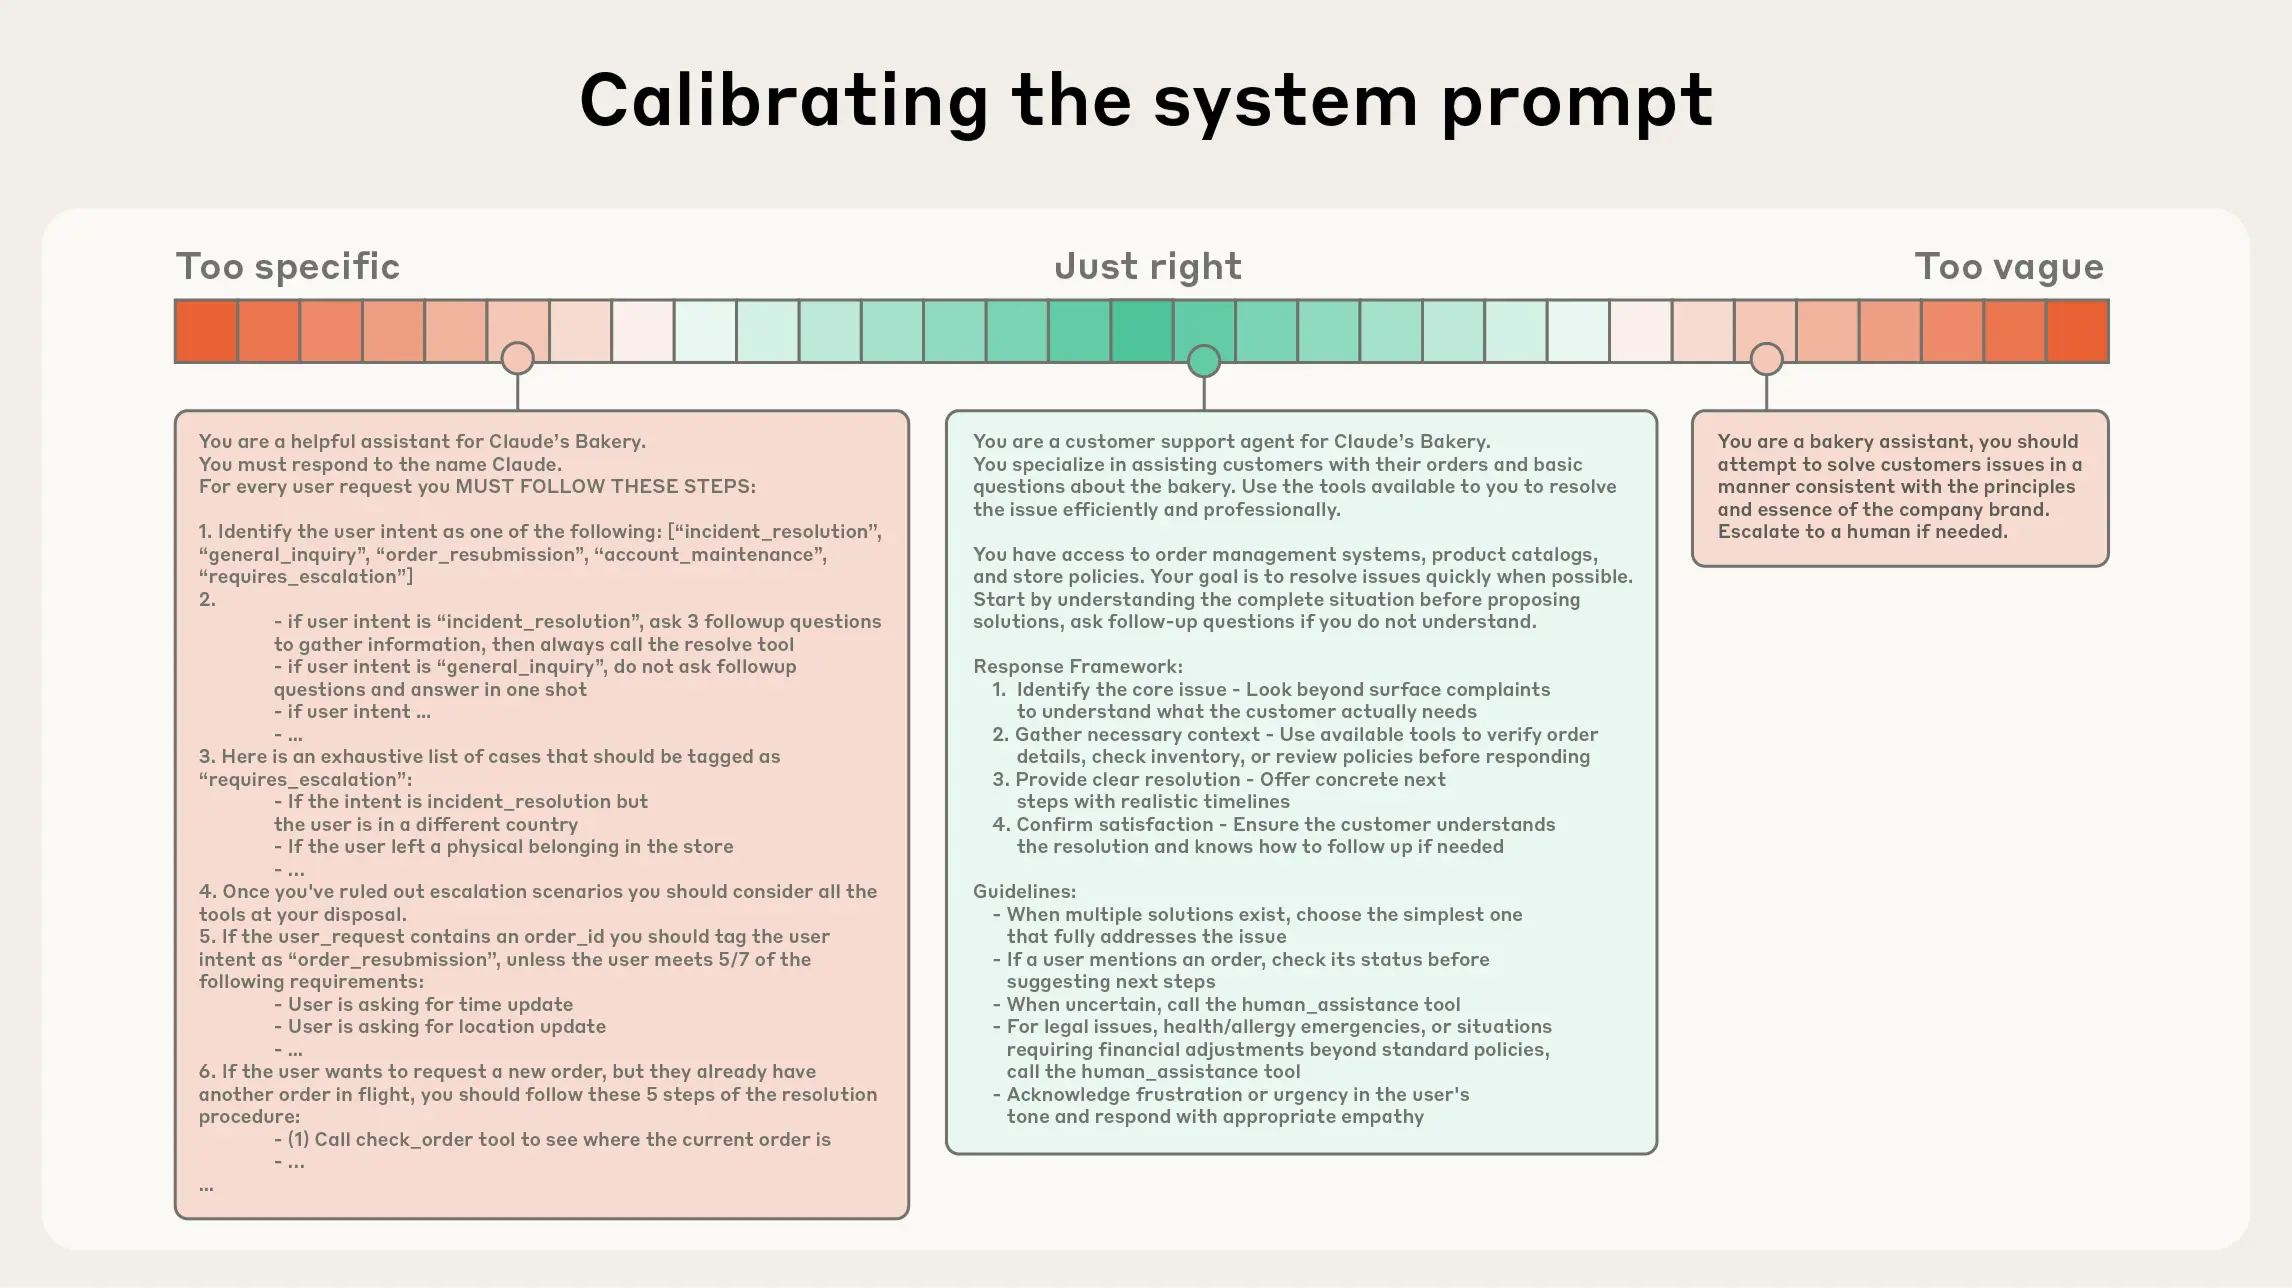
图 9.2 Calibrating the system prompt
9.2.2 上下文检索与智能体式搜索
一个简洁的定义:<strong>智能体 = 在循环中自主调用工具的 LLM</strong>。随着底层模型能力增强,智能体的自治水平便可提升:更能独立探索复杂问题空间,并从错误中恢复。
工程实践正在从“推理前一次性检索(embedding 检索)”逐步过渡到“<strong>及时(Just-in-time, JIT)上下文</strong>”。后者不再预先加载所有相关数据,而是维护<strong>轻量化引用</strong>(文件路径、存储查询、URL 等),在运行时通过工具动态加载所需数据。这样可让模型撰写针对性查询、缓存必要结果,并用诸如 <code>head</code>/<code>tail</code> 之类的命令分析大体量数据——无需把整块数据一次性塞入上下文。其认知模式更贴近人类:我们不会死记硬背全部信息,而是用文件系统、收件箱、书签等外部索引按需提取。
除了存储效率,<strong>引用的元数据</strong>本身也能帮助精化行为:目录层级、命名约定、时间戳等都在隐含地传达“目的与时效”。例如,<code>tests/test_utils.py</code> 与 <code>src/core/test_utils.py</code> 的语义暗示就不同。
允许智能体自主导航与检索还能实现<strong>渐进式披露(progressive disclosure)</strong>:每一步交互都会产生新的上下文,反过来指导下一步决策——文件大小暗示复杂度、命名暗示用途、时间戳暗示相关性。智能体得以按层构建理解,只在工作记忆中保留“当前必要子集”,并用“记笔记”的方式做补充持久化,从而维持聚焦而非“被大而全拖垮”。
需要权衡的是:运行时探索往往比预计算检索更慢,并且需要有“主见”的工程设计来确保模型拥有正确的工具与启发式。如果缺少引导,智能体可能会误用工具、追逐死胡同或错过关键信息,造成上下文浪费。
在不少场景中,<strong>混合策略</strong>更有效:前置加载少量“高价值”上下文以保证速度,然后允许智能体按需继续自主探索。边界的选择取决于任务动态性与时效要求。在工程上,可以预先放入类似“项目约定说明(如 README/指南)”的文件,同时提供 <code>glob</code>、<code>grep</code> 等原语,让智能体即时检索具体文件,从而绕开过时索引与复杂语法树的沉没成本。
9.2.3 面向长时程任务的上下文工程
长时程任务要求智能体在超出上下文窗口的长序列行动中,仍能保持连贯性、上下文一致与目标导向。例如大型代码库迁移、跨数小时的系统性研究。指望无限增大上下文窗口并不能根治“上下文污染”与相关性退化的问题,因此需要直接面向这些约束的工程手段:<strong>压缩整合(Compaction)</strong>、<strong>结构化笔记(Structured note-taking)</strong>与<strong>子代理架构(Sub-agent architectures)</strong>。
<strong>压缩整合(Compaction)</strong>
- 定义:当对话接近上下文上限时,对其进行高保真总结,并用该摘要重启一个新的上下文窗口,以维持长程连贯性。
- 实践:让模型压缩并保留架构性决策、未解决缺陷、实现细节,丢弃重复的工具输出与噪声;新窗口携带压缩摘要 + 最近少量高相关工件(如“最近访问的若干文件”)。
- 调参建议:先优化<strong>召回</strong>(确保不遗漏关键信息),再优化<strong>精确度</strong>(剔除冗余内容);一种安全的“轻触式”压缩是对“深历史中的工具调用与结果”进行清理。
<strong>结构化笔记(Structured note-taking)</strong>
- 定义:也称“智能体记忆”。智能体以固定频率将关键信息写入<strong>上下文外的持久化存储</strong>,在后续阶段按需拉回。
- 价值:以极低的上下文开销维持持久状态与依赖关系。例如维护 TODO 列表、项目 NOTES.md、关键结论/依赖/阻塞项的索引,跨数十次工具调用与多轮上下文重置仍能保持进度与一致性。
- 说明:在非编码场景中同样有效(如长期策略性任务、游戏/仿真中的目标管理与统计计数)。结合第八章的 <code>MemoryTool</code>,可轻松实现文件式/向量式的外部记忆并在运行时检索。
<strong>子代理架构(Sub-agent architectures)</strong>
- 思想:由主代理负责高层规划与综合,多个专长子代理在“干净的上下文窗口”中各自深挖、调用工具并探索,最后仅回传<strong>凝练摘要</strong>(常见 1,000–2,000 tokens)。
- 好处:实现关注点分离。庞杂的搜索上下文留在子代理内部,主代理专注于整合与推理;适合需要并行探索的复杂研究/分析任务。
- 经验:公开的多智能体研究系统显示,该模式在复杂研究任务上相较单代理基线具有显著优势。
方法取舍可以遵循以下经验法则:
- <strong>压缩整合</strong>:适合需要长对话连续性的任务,强调上下文的“接力”。
- <strong>结构化笔记</strong>:适合有里程碑/阶段性成果的迭代式开发与研究。
- <strong>子代理架构</strong>:适合复杂研究与分析,能从并行探索中获益。
即便模型能力持续提升,“在长交互中维持连贯性与聚焦”仍是构建强健智能体的核心挑战。谨慎而系统的上下文工程将长期保持其关键价值。