5 - 电商问数:Qdrant 与 ES 快速入门与接入
本章课程目标:
- 理解
Qdrant和Elasticsearch在「电商问数」里的职责边界,而不是把它们都当成“检索组件”混在一起。 - 掌握向量数据库、全文检索、
mapping、collection、payload等核心概念。 - 看懂项目里的
QdrantClientManager和ESClientManager是如何封装、初始化与测试的。
学习建议: Qdrant 和 ES 都叫检索,但不要把它们混成一个东西。读这篇时先记住分工:Qdrant 更适合语义相似度召回,ES 更适合全文匹配和精确过滤。跑 quickstart 的目的不是熟练所有 API,而是看清 collection / point / payload 和 index / document / mapping 分别在项目里对应什么。
对应代码分支: 05-qdrant-es
很多同学第一次看到这套项目时,都会问一个很自然的问题:
既然都是“检索”,为什么还要同时接
Qdrant和Elasticsearch?
答案是:它们解决的不是同一类问题。
在「电商问数」里,这几个基础设施的分工可以概括成下面这张表:
| 组件 | 在项目中的核心职责 | 最擅长解决的问题 |
|---|---|---|
MySQL | 存储权威结构化元数据与数仓数据 | 表、字段、指标、关系、样例值等结构化信息怎么保存 |
Qdrant | 存储字段和指标的向量索引 | “语义上谁更像” |
Elasticsearch | 存储字段取值的全文索引 | “文本上谁能匹配上” |
把它们放回问数链路,职责会更清楚:
用户自然语言问题
  -> Embedding 服务把文本转成向量
  -> Qdrant 召回语义相关的字段 / 指标
  -> Elasticsearch 检索可能相关的字段取值
  -> MySQL 补全表结构、字段定义、指标定义
-> LLM 基于上下文生成 SQL所以,本章真正要讲的不是两个彼此独立的客户端,而是「电商问数」的检索基础设施层:为什么需要它们、它们分别存什么、在项目里怎么接、后面又怎么被业务层调用。
1、Qdrant 客户端接入
1.1 Qdrant 简介
官方文档:https://qdrant.tech/documentation/overview/what-is-qdrant/ (英)
一句话来说,Qdrant 就是:一个专门用于保存向量并执行相似度检索的数据库。
但放到当前项目里,这句话还不够具体。更准确的说法应该是:
- 字段信息会被向量化后写入
Qdrant - 指标信息也会被向量化后写入
Qdrant - 用户问题到来时,同样会先被向量化
- 再用“问题向量”去搜索最相近的字段和指标
也就是说,Qdrant 在这里并不承担“保存全部元数据”的职责,而是承担:在海量字段和指标候选中,先快速缩小语义问题空间。
这一点非常关键。因为企业问数场景里,表和字段通常很多,如果没有这一步语义召回,大模型需要面对的候选上下文会非常多,后面的 SQL 生成更容易跑偏。
当前项目构建字段和指标向量索引时,不是只给每个实体写一条向量,而是会把名称、描述、别名分别向量化后再写入向量库。这样做的目的,是让系统既能听懂正式名,也能听懂业务别名和自然语言表达。
1.2 区分 OLTP、OLAP 和向量数据库
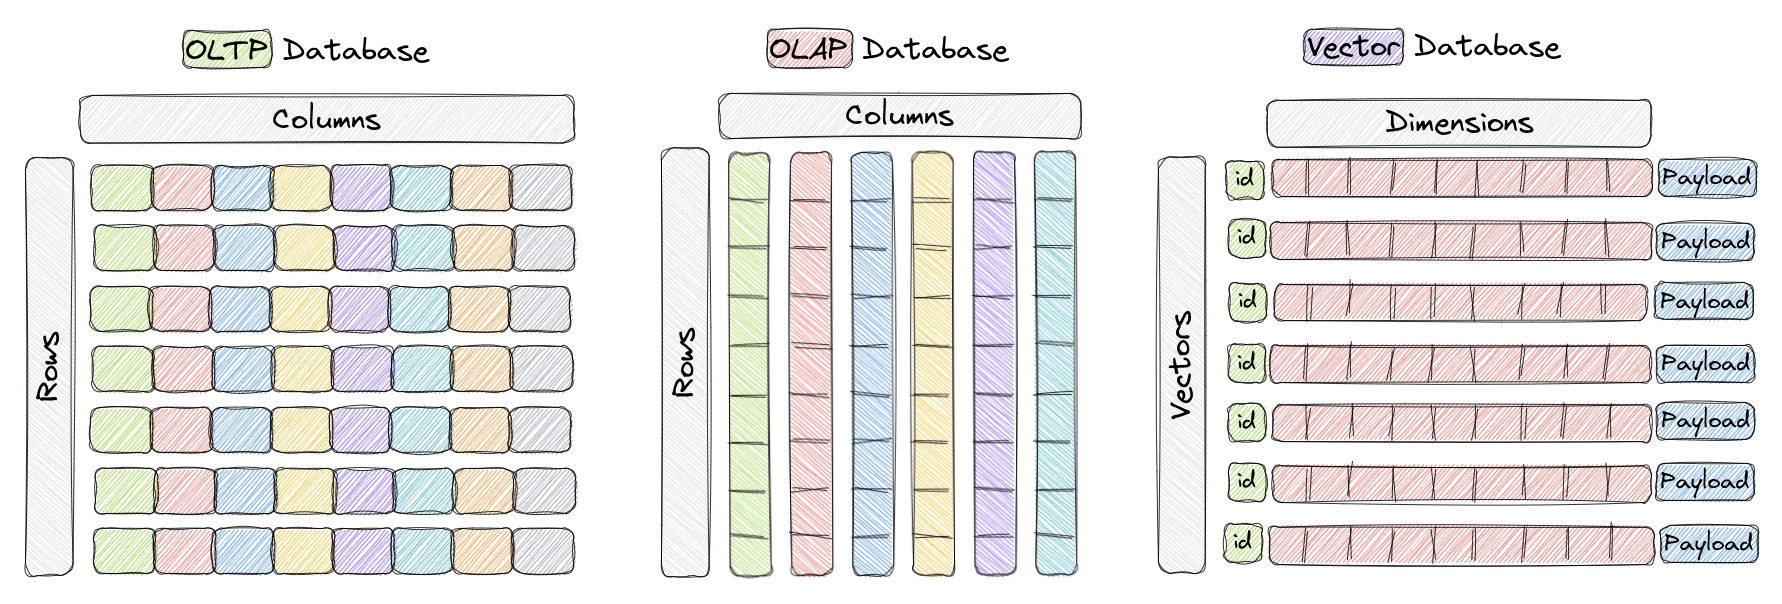
理解 Qdrant 之前,一个常见误区是把它简单理解成“另一种 MySQL”。
如果直接结合上面这张图来看,它本质上是在对比三类数据库的数据组织方式:
左边
OLTP database- 重点是按“行”组织数据
- 更适合支撑业务系统按一条记录去查、改、写
中间
OLAP database- 重点是按“列”组织数据
- 更适合做统计分析,因为分析场景经常需要一次扫描某一整列数据
右边
Vector database- 核心单位不再是“表里的一行记录”,而是一个向量点
- 一个点通常由
id、vector、payload组成
所以这张图真正想表达的是:数据组织方式不同,决定了它们擅长解决的问题也不同。
先把三类数据库粗略理解成下面这样:
| 类型 | 典型代表 | 主要用途 | 数据组织方式 |
|---|---|---|---|
OLTP 数据库 | MySQL、PostgreSQL、Oracle | 支撑日常业务交易 | 通常以表的行列结构为主,更偏按行读写 |
OLAP 数据库 | Hive、ClickHouse、Doris | 支撑统计分析和报表计算 | 也是表结构,但更适合分析型查询,常见按列存储 |
| 向量数据库 | Qdrant | 支撑语义相似度检索 | 以向量点为核心数据单位 |
如果再压缩成一句最容易记忆的话,可以这样区分:
OLTP(Online Transaction Processing)更偏业务数据库,适合查询某一行OLAP(Online Analytical Processing)更偏分析型数据库,适合查询某一列- 向量数据库更偏语义相似度检索
把这张图再映射回「电商问数」项目,分工就更清楚了:
MySQL负责存元数据和数仓模拟数据Qdrant负责语义相似度召回,根据向量相似度召回相关字段和指标Elasticsearch不等同于这里的OLAP,它更偏搜索引擎和全文检索系统;在本项目里主要负责字段取值检索
你可能会问,那 Elasticsearch 属于这三类数据库中的哪一种?
更具体地说,Elasticsearch 并不完全等同于这里的任何一类。它更适合被理解成:搜索引擎 / 全文检索系统
在「电商问数」项目里,它承担的职责很明确:
- 根据用户问题里的自然语言表达
- 去匹配真实存在的字段取值
- 为后续 SQL 生成补充“值域层”的上下文信息
所以这里最重要的结论不是“谁替代谁”,而是:结构化存储、统计分析、语义召回、全文检索,往往需要不同类型的基础服务共同完成。
1.3 理解 Qdrant 核心概念
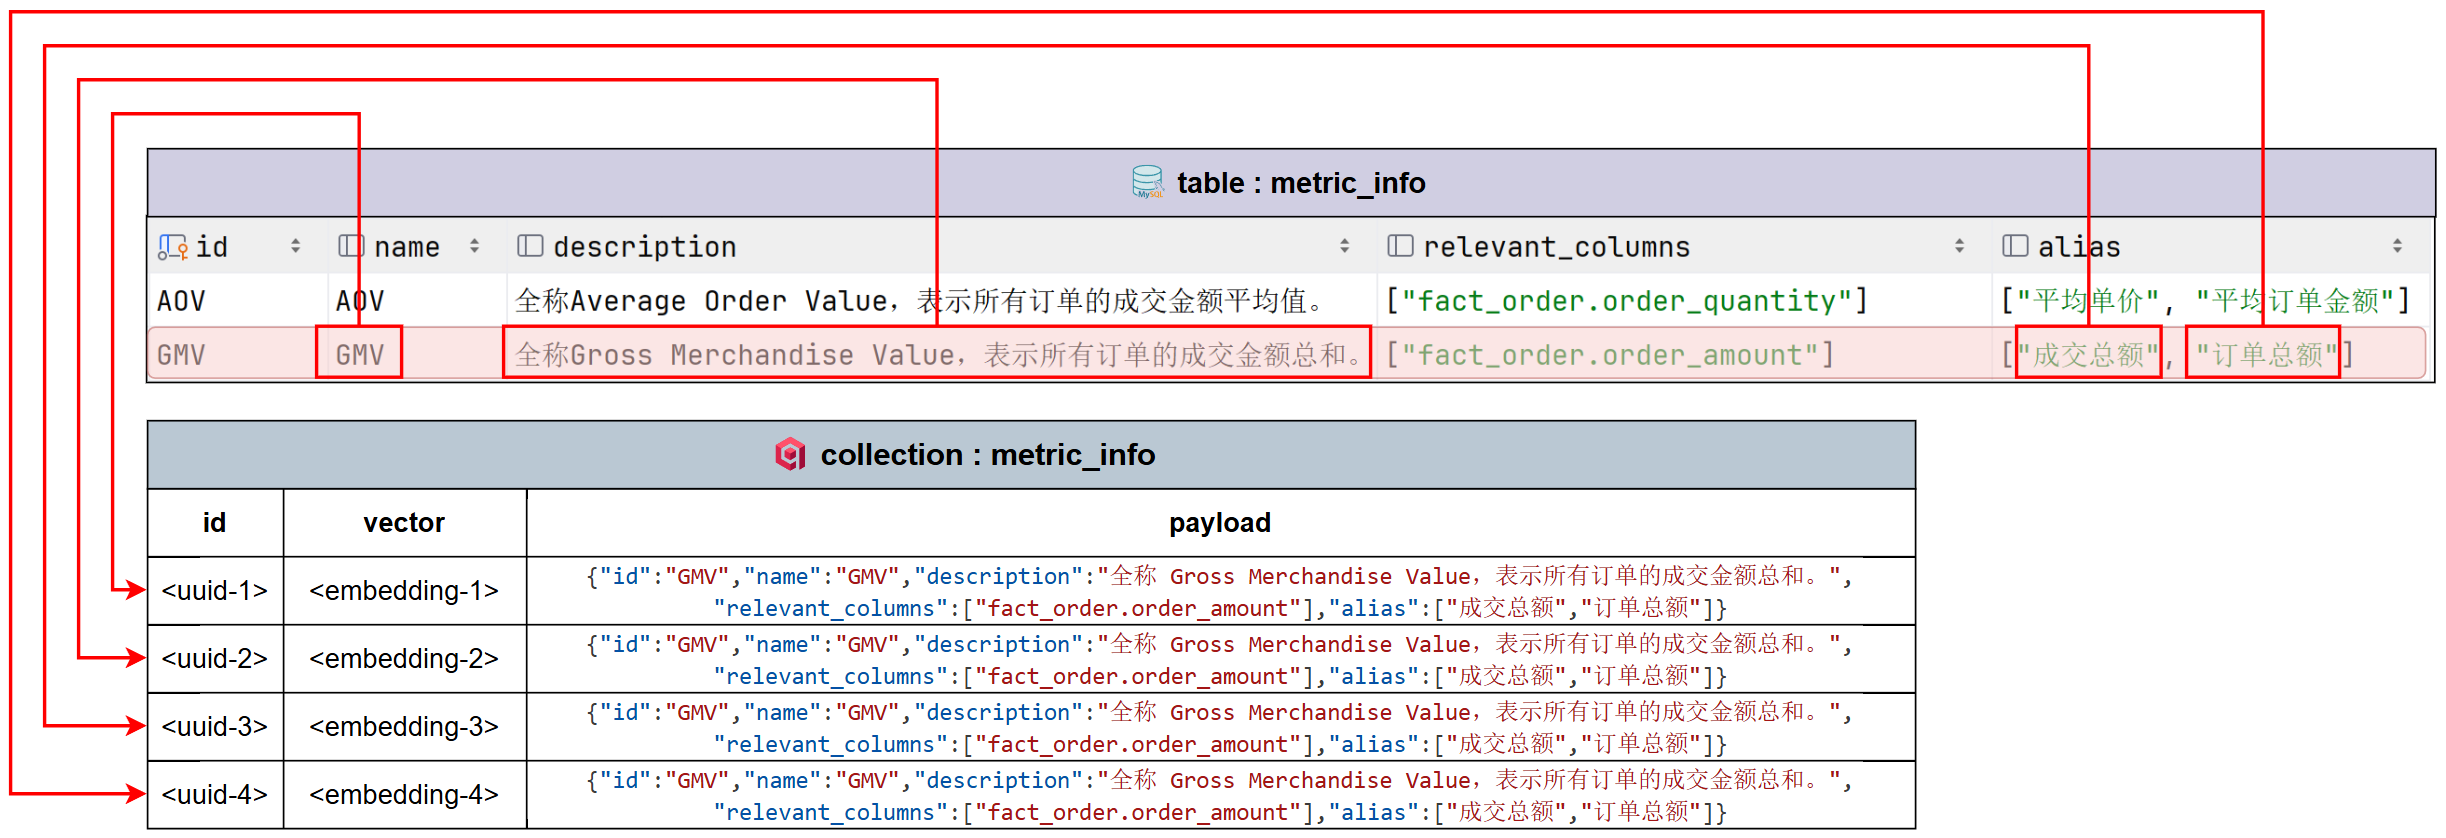
Qdrant 官方对 collection 的描述很清楚:同一个 collection 里的 points 使用相同维度,并按同一种距离度量进行比较。
如果是第一次接触向量数据库,先掌握下面几个概念:
| 概念 | 可以怎样理解 |
|---|---|
collection | 一组向量点的集合,可以类比成“同类向量的一张表” |
point | 集合中的一条记录 |
vector | 这条记录对应的向量 |
payload | 跟着向量一起保存的业务字段 |
distance | 用什么方式比较“像不像” |
一个 point 最常见的结构如下:
{
  "id": "column-001",
  "vector": [0.12, 0.98, 0.44, 0.31],
  "payload": {
    "name": "region_name",
    "description": "地区名称"
  }
}
这里有两个参数特别重要:
size:向量维度,必须和 Embedding 模型输出维度一致distance:相似度 / 距离计算方式,当前项目使用COSINE
1.4 Qdrant 快速入门案例
这份 quickstart 演示的是最基础的 4 步:
初始化客户端
  -> 创建 collection
  -> 写入 points
  -> query_points 查询相似向量
把这条思路进一步落成一个最小可运行的 .py 示例:
项目对应文件路径:shopkeeper-agent/examples/qdrant_quickstart_demo.py
import asyncio

from qdrant_client import AsyncQdrantClient, models

QDRANT_URL = "http://localhost:6333"
COLLECTION_NAME = "quickstart_demo"
VECTOR_SIZE = 4

async def recreate_collection(client):
    """为了让示例可重复运行,先删除旧集合,再重新创建"""
    if await client.collection_exists(COLLECTION_NAME):
        await client.delete_collection(COLLECTION_NAME)

    # Create a collection:创建一个新的集合
    await client.create_collection(
        collection_name=COLLECTION_NAME,
        vectors_config=models.VectorParams(
            size=VECTOR_SIZE,
            distance=models.Distance.COSINE,
        ),
    )
    print(f"1. 已创建集合:{COLLECTION_NAME}")

async def add_vectors(client):
    """
    写入几个示例向量

    这里同时带上 payload,方便读者理解:
    在 Qdrant 里,一个 point 不只有 vector,还可以附带业务字段
    """
    await client.upsert(
        collection_name=COLLECTION_NAME,
        points=[
            models.PointStruct(
                id=1,
                vector=[0.05, 0.61, 0.76, 0.74],
                payload={"name": "订单分析", "type": "report"},
            ),
            models.PointStruct(
                id=2,
                vector=[0.19, 0.81, 0.75, 0.11],
                payload={"name": "销量趋势", "type": "metric"},
            ),
            models.PointStruct(
                id=3,
                vector=[0.36, 0.55, 0.47, 0.94],
                payload={"name": "区域销售额", "type": "dimension"},
            ),
        ],
    )
    print("2. 已写入 3 个向量点。")

async def run_query(client):
    """
    执行一次向量查询

    查询向量会和集合里的点做相似度计算,
    最终返回最相近的几个 point
    """
    query_vector = [0.2, 0.1, 0.9, 0.7]
    result = await client.query_points(
        collection_name=COLLECTION_NAME,
        query=query_vector,
        limit=3,
        with_payload=True,
    )

    print(f"3. 查询向量:{query_vector}")
    print("4. 查询结果:")
    for i, point in enumerate(result.points, start=1):
        print(
            f"   {i}) id={point.id}, score={point.score:.4f}, payload={point.payload}"
        )

async def main():
    # 直接初始化客户端,方便单独学习 quickstart 的基本用法
    client = AsyncQdrantClient(url=QDRANT_URL)

    try:
        await recreate_collection(client)
        await add_vectors(client)
        await run_query(client)
    finally:
        await client.close()

if __name__ == "__main__":
    asyncio.run(main())
执行文件验证,成功:
(shopkeeper-agent) didilili@DidililiMacBook-Pro shopkeeper-agent % python3 -m examples.qdrant_quickstart_demo

1. 已创建集合:quickstart_demo
2. 已写入 3 个向量点。
3. 查询向量:[0.2, 0.1, 0.9, 0.7]
4. 查询结果:
   1) id=1, score=0.8946, payload={'name': '订单分析', 'type': 'report'}
   2) id=3, score=0.8387, payload={'name': '区域销售额', 'type': 'dimension'}
   3) id=2, score=0.6660, payload={'name': '销量趋势', 'type': 'metric'}
这里最值得掌握的不是样例数据本身,而是三个 API:
create_collection(...):创建集合,并声明维度与距离度量upsert(...):按id更新或插入 pointsquery_points(...):根据查询向量返回最相关的点
Qdrant 官方 API 文档里,query_points 还支持 score_threshold、limit、filter、with_payload、with_vector 等参数。当前项目最常用的是:
score_threshold:控制最低召回分数limit:控制返回条数with_payload:控制是否把业务字段一起带回
Qdrant 自带可视化页面,通常可以通过 http://localhost:6333/dashboard 打开控制台页面,查看当前有哪些 collection、点数据是否写入成功。这对开发阶段排查问题会比较方便。
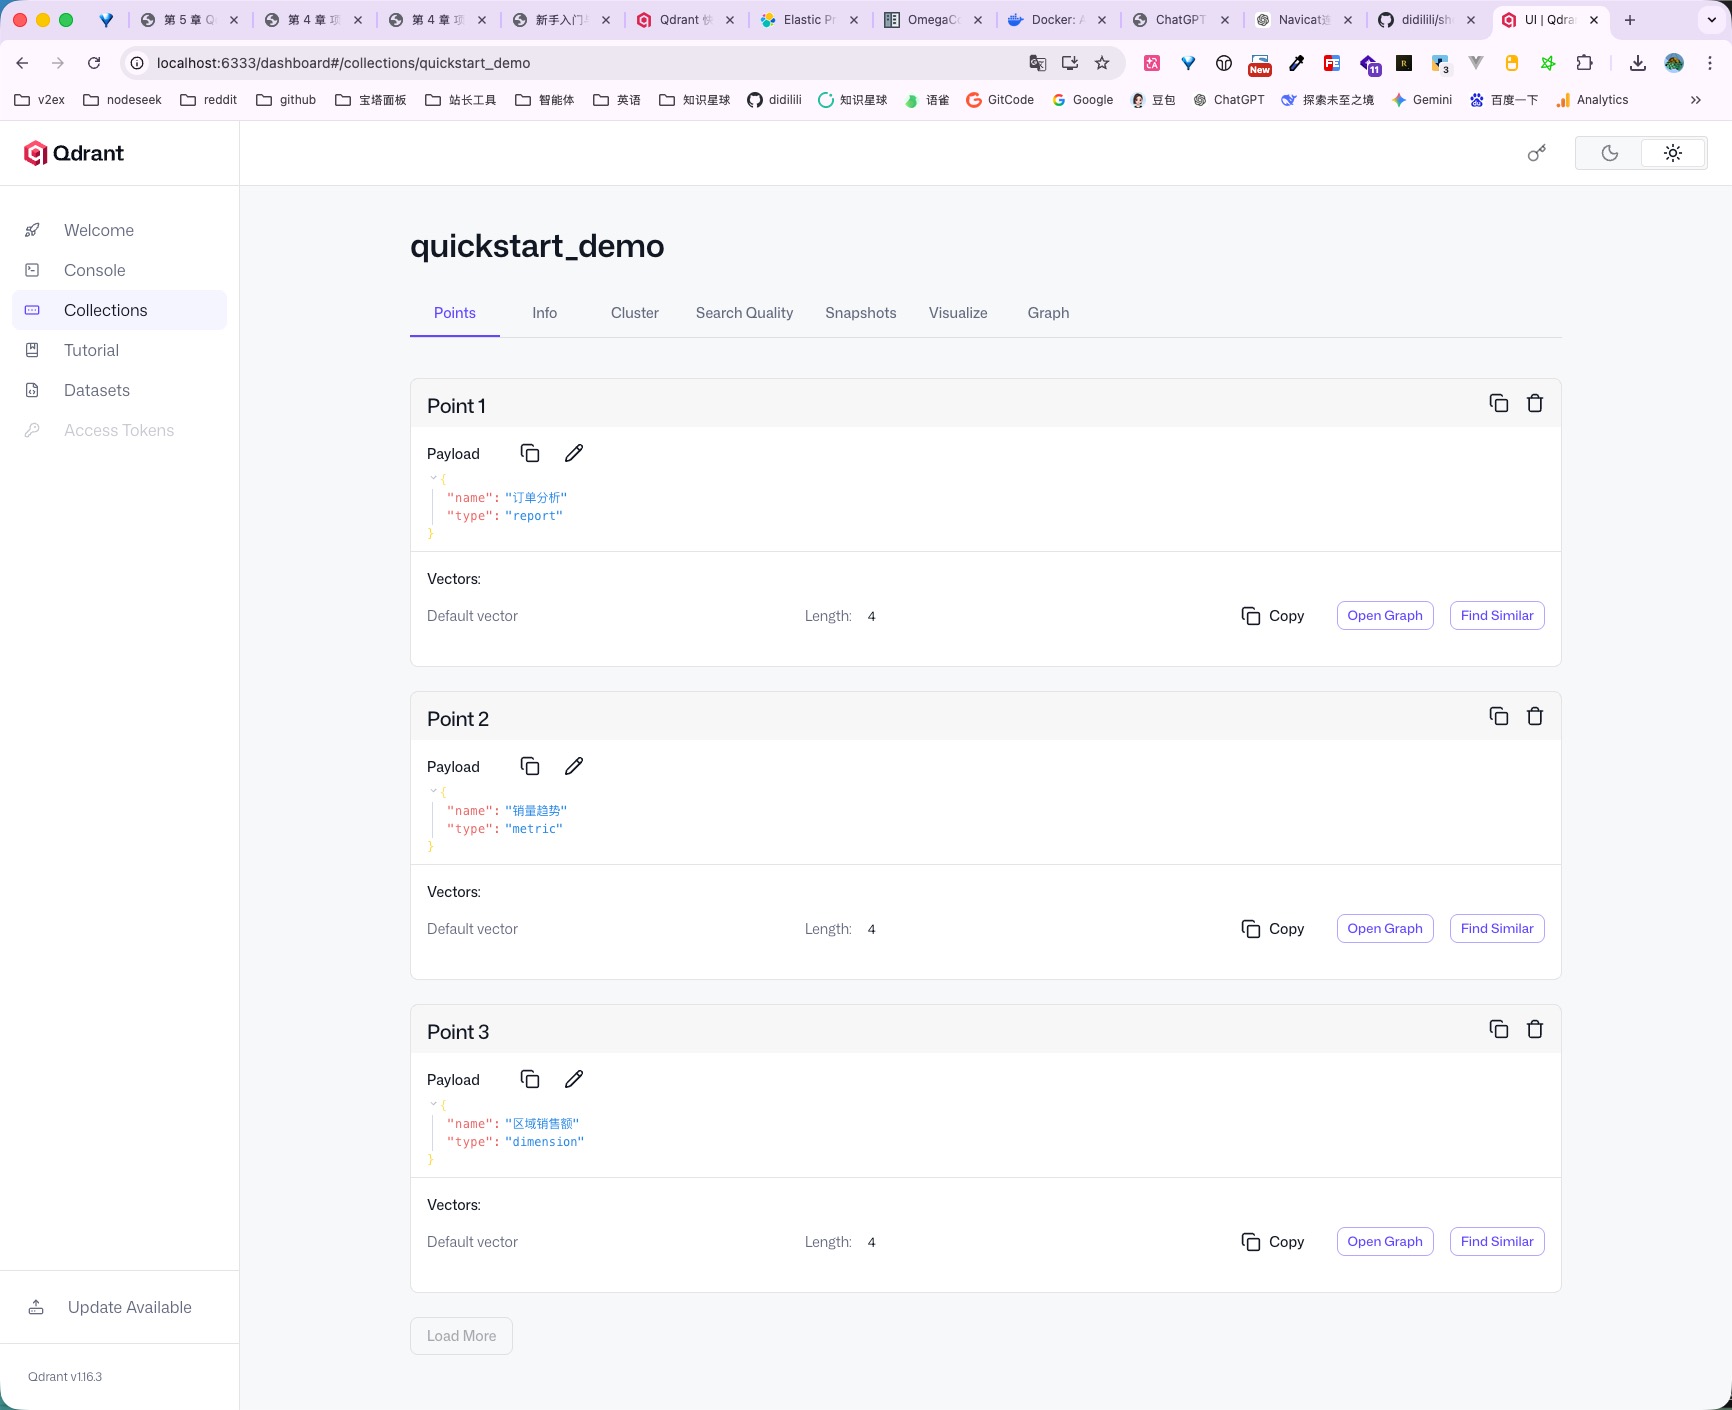
1.5 封装 Qdrant 客户端
理解了 Qdrant 的基本概念之后,再来看项目代码里的封装就顺了。
在这个项目里,我们并不是在每个地方都临时 new 一个客户端,而是专门写了一个 QdrantClientManager。这样做主要是为了统一处理这几件事:客户端初始化,客户端关闭,读取配置文件中的服务地址,保持项目里只使用同一套客户端对象。
另外,这一节还有一个很重要的演进点:前面快速入门时,示例代码先用同步客户端帮助我们理解流程;但真正放到项目里时,更合适的做法是改成异步客户端。
原因也不复杂:
Qdrant的读写本质上是网络I/O- 网络请求发出去之后,程序往往需要等待服务端响应
- 如果使用异步客户端,这段等待时间就可以把
CPU让给其他协程
所以,项目最终采用 AsyncQdrantClient,本质上是为了和整套异步后端保持一致,减少阻塞,提高整体并发利用率。
项目对应文件路径:shopkeeper-agent/app/clients/qdrant_client_manager.py
import asyncio
import random
from typing import Optional

from qdrant_client import AsyncQdrantClient, models

from app.conf.app_config import QdrantConfig, app_config

class QdrantClientManager:
    def __init__(self, qdrant_config: QdrantConfig):
        # 保存配置对象,后面初始化客户端时要从这里读取 host 和 port
        self.qdrant_config = qdrant_config
        # 先把 client 声明出来,真正初始化放到 init() 中进行
        self.client: Optional[AsyncQdrantClient] = None

    def _get_url(self):
        # 根据配置文件拼出 Qdrant 服务地址
        return f"http://{self.qdrant_config.host}:{self.qdrant_config.port}"

    def init(self):
        # 创建异步客户端
        # 这里不在 __init__ 中直接初始化,是为了和项目的生命周期管理保持一致
        self.client = AsyncQdrantClient(url=self._get_url())

    async def close(self):
        # 项目关闭时统一关闭客户端连接
        await self.client.close()

# 创建一个全局的管理器对象
# 后续项目中的其他模块都通过它来获取同一套 Qdrant 客户端
qdrant_client_manager = QdrantClientManager(app_config.qdrant)

if __name__ == "__main__":
    # 先初始化客户端,后面的测试逻辑才能真正访问 Qdrant
    qdrant_client_manager.init()

    async def test():
        # 取出真正的 Qdrant 异步客户端
        client = qdrant_client_manager.client

        # 如果集合不存在,就先创建一个集合
        if not await client.collection_exists("my_collection"):
            await client.create_collection(
                collection_name="my_collection",
                vectors_config=models.VectorParams(
                    # 当前集合中的向量维度是 10
                    size=10,
                    # 使用余弦相似度作为距离计算方式
                    distance=models.Distance.COSINE,
                ),
            )

        # 向集合中写入 100 个随机 point
        # 每个 point 都有一个 id 和一个 10 维向量
        await client.upsert(
            collection_name="my_collection",
            points=[
                models.PointStruct(
                    id=i,
                    vector=[random.random() for _ in range(10)],
                )
                for i in range(100)
            ],
        )

        # 用一个随机生成的查询向量做相似度检索
        # limit=10 表示最多返回 10 条结果
        # score_threshold=0.8 表示只保留分数不低于 0.8 的结果
        res = await client.query_points(
            collection_name="my_collection",
            query=[random.random() for _ in range(10)],  # type: ignore
            limit=10,
            score_threshold=0.8,
        )

        # 打印查询结果,便于观察 point 的 id、score 等信息
        print(res)

    # 运行异步测试函数
    asyncio.run(test())
执行文件验证,成功:
(shopkeeper-agent) didilili@DidililiMacBook-Pro shopkeeper-agent % python3 -m app.clients.qdrant_client_manager
points=[ScoredPoint(id=33, version=4, score=0.9287777, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=45, version=4, score=0.9019778, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=58, version=4, score=0.90187067, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=75, version=4, score=0.8799222, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=66, version=4, score=0.87921834, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=87, version=4, score=0.8753782, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=73, version=4, score=0.86765623, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=27, version=4, score=0.86216307, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=16, version=4, score=0.8618801, payload={}, vector=None, shard_key=None, order_value=None), ScoredPoint(id=69, version=4, score=0.8546801, payload={}, vector=None, shard_key=None, order_value=None)]
代码分析:
1.5.1 理解文件的两层职责
这一节可以按两个层次来理解这个文件。第一个层次,是把 Qdrant 客户端封装成项目里的基础服务。第二个层次,是用文件底部的测试代码演示一条最小可运行链路。这样看时,这个文件的职责就很清楚了:上半部分负责管理客户端,下半部分负责说明客户端怎么用。
1.5.2 上半部分:QdrantClientManager 在做什么
先看上半部分的管理器代码。这里的核心目标不是“多写一个类”,而是把 Qdrant 客户端的初始化和关闭统一收口,不让项目里每个地方都自己去创建和销毁连接。
这一部分最值得注意的是下面几个位置:
self.qdrant_config:保存Qdrant配置对象,后面要从这里读取host、port等参数_get_url():根据配置拼出完整服务地址,例如http://localhost:6333init():真正初始化AsyncQdrantClientclose():在程序退出时统一关闭客户端连接qdrant_client_manager = QdrantClientManager(app_config.qdrant):在模块加载时创建一份全局可复用的管理器对象
1.5.3 下半部分:测试代码演示的最小链路
再看下半部分的测试代码,它并不是为了写一段“临时脚本”,而是在演示这个客户端封装好之后,最基本的使用流程是什么。它对应的就是下面这条链路:
- 判断
collection是否存在 - 如果不存在,就调用
create_collection(...) - 通过
upsert(...)写入一批向量点 - 通过
query_points(...)做相似度查询
把这四步看懂,这个文件就理解了一大半。
collection_name="my_collection":指定当前操作的是哪一个集合models.VectorParams(size=10, distance=models.Distance.COSINE):指定向量维度和距离计算方式models.PointStruct(...):表示单个点数据,里面至少会有id和vectorlimit=10:表示最多返回前 10 个最相近结果score_threshold=0.8:表示只保留分数不低于 0.8 的结果
1.5.4 异步写法和真实项目里的向量来源
因为这里使用的是异步客户端,所以代码写法上还有两个同步示例里不会出现的点:和服务端交互的方法,都要通过 await 调用;测试逻辑要先放进 async def test() 这样的异步函数里,再通过 asyncio.run(test()) 执行。
这里为了演示流程,向量是随机生成的。真实项目里,写入 Qdrant 的向量并不是随便生成的,而是来自 Embedding 模型对字段说明、指标说明或用户问题的编码结果。
2、Elasticsearch 客户端接入
2.1 ES 简介
Elasticsearch 在当前项目里不是用来替代 MySQL,也不是用来替代 Qdrant。
它最核心的职责是:为字段取值建立全文索引,让系统能把用户的自然语言表达映射到真实存在的值域。
例如:
- 用户说“华北地区”
- 用户说“数码品类”
- 用户说“直营门店”
这些表达不一定是字段名,更可能是某个维度字段里的具体取值。这个时候,光靠向量召回字段和指标还不够,还要补一层“值域检索”,这就是 ES 在当前项目里的位置。
2.2 ES 基础概念
官方文档:https://www.elastic.co/guide/en/elasticsearch/reference/8.19/documents-indices.html (英)
在 Elasticsearch 里,先掌握四个词:
| 概念 | 可以怎样理解 |
|---|---|
index | 一组同类文档的逻辑容器 |
document | index 中的一条 JSON 文档 |
field | document 中的一个字段 |
mapping | 定义字段结构、字段类型以及索引行为 |
如果和其他基础设施做类比:
| 系统 | 结构类比 |
|---|---|
MySQL | 表 -> 行 -> 列 |
Qdrant | collection -> point -> vector / payload |
Elasticsearch | index -> document -> field |
也就是说,虽然三者都在“存数据”,但它们组织数据的方式并不一样:
- MySQL 更偏结构化记录
- Qdrant 更偏向量点
- Elasticsearch 更偏 JSON 文档
如果用最熟悉的 JSON 形式来理解,一个 document 大致就像这样:
{
  "id": "v_001",
  "value": "华北地区",
  "column_id": "dim_region.region_name"
}
在这个例子里:
- 整个 JSON 对象就是一个
document id、value、column_id就是field- 这些文档会被存进某个
index
如果把它和前面讲过的 Qdrant 再对一下,会更容易理解:
- 在
Qdrant里,我们会说“往某个collection里写入一个point” - 在
Elasticsearch里,我们会说“往某个index里写入一个document”
这也解释了为什么这里要特别强调:index 在这里是名词,表示一个索引容器;而不是后面 API 里的那个“写入动作”。另外,Elasticsearch 返回结果里经常会出现一些以下划线开头的字段,例如 _index、_id、_source,这些属于元数据字段,属于 ES 自带的字段。
这里先做一个简要对应:
_index表示这条数据属于哪个索引_id表示这条数据在索引中的唯一标识_source里存放的,才是我们真正写进去的业务数据
2.3 理解 mapping
mapping 本质是 Elasticsearch 里的“表结构说明”。
如果之前接触过关系型数据库、数据建模,或者在别的技术栈里见过 schema 这个词,这里可以直接把两者对应起来:mapping 是 Elasticsearch 里的说法,而 schema 是很多数据库或数据系统里更常见的说法。
它们在这里表达的核心意思是一样的:用一套结构定义,描述这一类数据有哪些字段、字段是什么类型、应该按什么方式被索引和存储。
这里还要特别区分两种常见方式:
dynamic mapping:让ES根据写入的数据自动推断字段类型explicit mapping:由我们显式定义字段结构和字段类型
从工程角度看,当前项目更适合使用 显式定义 的方式,因为这样更可控,也更方便我们精确设计检索行为。
2.4 text 和 keyword 区别
mapping 不只是定义“有哪些字段”,还要定义“字段的数据类型是什么”。而 text 和 keyword,就是 ES 里两种非常常见、但处理方式完全不同的字段类型。
也就是说,
- 先有
index index里存的是documentdocument里有很多fieldmapping要定义这些field的类型- 当字段类型是字符串时,最常见的两种类型就是
text和keyword
text 类型更偏全文检索。它适合保存一段可以被自然语言搜索的文本内容。为了支持这类搜索,ES 往往会先对文本做分词,再建立倒排索引。这意味着什么?意味着你存进去的不是一个“必须原样完全相等”的字符串,而是一段可以被拆开、被搜索、被匹配的文本。
例如:"华北地区"、"数码品类"、"近三个月销售额"。这类值如果定义成 text,用户在查询时不一定非得一模一样地输入整串文本,而是可以通过自然语言方式去匹配它们。
而keyword 更偏精确匹配。它不会像 text 那样做分词,更适合存那些“必须按原值整体处理”的字段。
例如:主键 id、字段标识 column_id、状态码、类别编码。这类值通常不是拿来做全文搜索的,而是要么相等,要么不相等,所以更适合定义成 keyword。
字段类型不同,ES 后续建立索引和执行检索的方式也不同。这正是 mapping 为什么重要的原因。我们并不是随便把字段声明成某个类型,而是在提前告诉 ES:这个字段将来打算怎么被搜索。
放到「电商问数」项目里,这个区别就非常具体了:字段取值里的 value 适合定义为 text。因为用户会用自然语言去搜它,例如“华北地区”“数码品类”。id 和 column_id 更适合定义为 keyword。因为它们更像结构化标识,不需要分词,只需要精确匹配。
这一点在项目真实代码里也能看到,对应文件:shopkeeper-agent/app/repositories/es/value_es_repository.py
其中索引映射大致如下:
index_mappings = {
    "dynamic": False,
    "properties": {
        "id": {"type": "keyword"},
        "value": {
            "type": "text",
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_max_word",
        },
        "column_id": {"type": "keyword"},
    },
}这里还有一个细节值得注意:value 字段使用了 ik_max_word,这说明项目在中文文本检索时,会配合中文分词器来提高匹配效果。这个设置本身也再次说明:value 这个字段不是按“原样完全相等”去检索的,而是按全文检索的思路来处理的。
2.5 ES 常见使用方式
使用 Elasticsearch 大致有两种常见方式:
- 直接调用
REST API - 在程序里使用语言客户端
如果只是做测试或调试,第一种方式非常方便。例如,我们可以在 Kibana 的 Dev Tools 里直接执行接口,验证索引是否创建成功、文档是否写入成功、查询语句是否返回预期结果。
在这个项目里,更常见的真实开发方式是第二种,也就是在 Python 代码中使用 elasticsearch 客户端库。这也解释了为什么我们接下来会专门封装一个 ESClientManager。
2.6 ES 快速入门案例
官方文档:https://www.elastic.co/guide/en/elasticsearch/reference/8.19/full-text-filter-tutorial.html (英)
这份教程讲的不是 Python 客户端封装,而是直接通过 REST API 走一遍 Elasticsearch 的典型使用流程。通常最适合在 Kibana 的 Dev Tools 里执行,所以它非常适合拿来建立直觉。
如果把它翻译成一条更好理解的链路,大致就是:
创建 index
  -> 定义 mapping
  -> 批量写入文档
  -> 使用 _search 做全文检索
  -> 再叠加 filter 做精确过滤
先看完整案例代码。它把“清理旧索引、创建索引、定义映射、批量写入文档、全文检索、叠加过滤”都串起来了。
# 如果之前已经创建过 cooking_blog,可以删掉旧索引
DELETE /cooking_blog

# 创建索引
PUT /cooking_blog

# 定义字段结构
PUT /cooking_blog/_mapping
{
  "properties": {
    "title": { "type": "text" },
    "description": { "type": "text" },
    "author": { "type": "text" },
    "date": { "type": "date", "format": "yyyy-MM-dd" },
    "category": { "type": "text" },
    "tags": { "type": "text" },
    "rating": { "type": "float" }
  }
}

# 批量写入文档
POST /cooking_blog/_bulk?refresh=wait_for
{"index":{"_id":"1"}}
{"title":"Perfect Pancakes","description":"Fluffy pancakes for breakfast","author":"Maria Rodriguez","date":"2023-05-01","category":"Breakfast","tags":["pancakes","breakfast"],"rating":4.8}
{"index":{"_id":"2"}}
{"title":"Vegetarian Curry","description":"A spicy and comforting curry","author":"Aisha Khan","date":"2023-06-10","category":"Dinner","tags":["vegetarian","curry","spicy"],"rating":4.7}
{"index":{"_id":"3"}}
{"title":"Berry Smoothie Bowl","description":"A healthy breakfast with fresh berries","author":"Liam Turner","date":"2023-07-03","category":"Breakfast","tags":["smoothie","berries","healthy"],"rating":4.6}
{"index":{"_id":"4"}}
{"title":"Chocolate Lava Cake","description":"Rich chocolate cake with a gooey center","author":"Sophia Chen","date":"2023-08-12","category":"Dessert","tags":["chocolate","cake","dessert"],"rating":4.9}

# 全文检索
GET /cooking_blog/_search
{
  "query": {
    "match": {
      "description": "fluffy pancakes"
    }
  }
}

# 全文检索 + 过滤查询
GET /cooking_blog/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "description": "breakfast"
          }
        }
      ],
      "filter": [
        {
          "range": {
            "rating": {
              "gte": 4.7
            }
          }
        }
      ]
    }
  }
}
这个案例最适合帮助初学者掌握下面这几件事:
- 创建
index - 定义
mapping - 批量写入
document - 用
_search做全文检索 - 在全文检索的基础上叠加精确过滤
如果把这套官方示例映射回当前项目,理解会更顺一些:
cooking_blog只是教学用的index- 食谱文档只是教学用的
document match、filter、_search才是我们真正要掌握的能力
也就是说,这个示例虽然用的是做菜博客场景,但它真正想教会我们的,是 ES 最基础、最通用的工作方式。后面放到「电商问数」项目里,食谱会换成字段值、标签或元数据信息,但底层思路不会变。
如果这组代码能在 Dev Tools 中顺利执行,并且 _search 能查到结果,就说明你已经把 ES 的最小使用链路走通了。
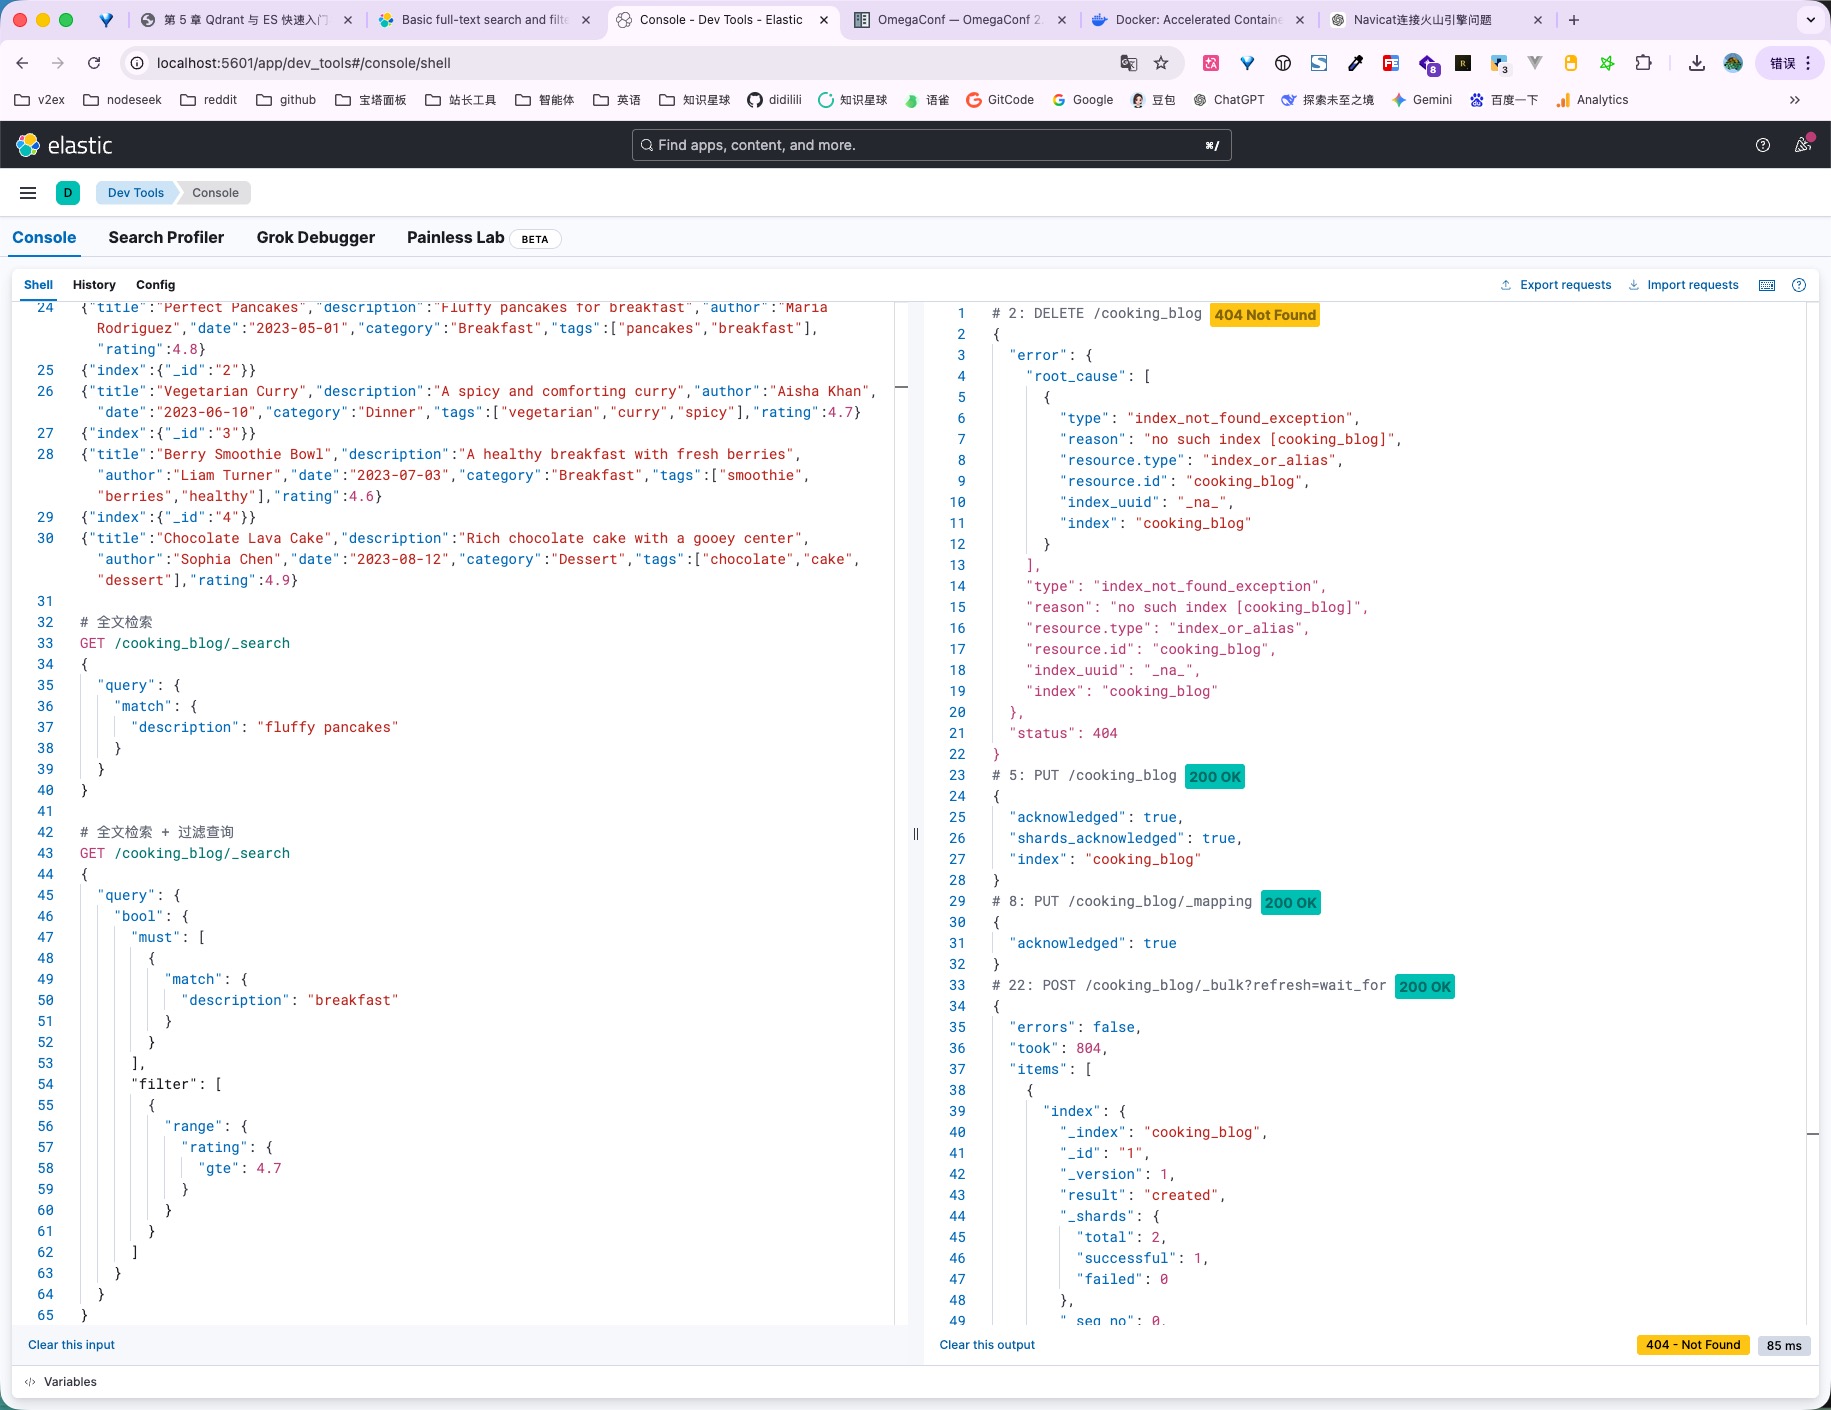
2.7 理解 bulk 和 match
快速入门里还有两个非常常用的 API,需要单独理解一下。
2.7.1 bulk
bulk 用来做批量写入,适合一次性写入多条文档。它的结构第一次看会有点绕,因为它采用的是“操作说明 + 数据本体”交替出现的形式。例如:
await client.bulk(
    operations=[
        {"index": {"_index": "my-books"}},
        {"name": "1984", "author": "George Orwell"},
        {"index": {"_index": "my-books"}},
        {"name": "Brave New World", "author": "Aldous Huxley"},
    ],
)
这里的结构其实很简单:
- 先说明“我要执行一次
index写入” - 再给出“这次写入的数据”
- 然后继续下一次操作
2.7.2 match
match 是 ES 中最常见的全文检索查询方式之一。例如:
await client.search(
    index="my-books",
    query={
        "match": {
            "name": "brave"
        }
    },
)
这段代码表达的意思是:
- 在
my-books这个索引中查找 - 重点搜索
name字段 - 查询词是
brave
ES 会根据这个查询词去做文本匹配,并返回最相关的结果。放到「电商问数」项目里,这个思路后面就会变成:在字段值索引里搜索 value;查询词可能是“华北地区”“数码品类”这类自然语言。
2.8 封装 ES 客户端
和前面的 Qdrant 一样,Elasticsearch 客户端也不适合在每次使用时临时创建。更合理的做法是统一封装一个管理器,负责:从配置文件读取 host 和 port,初始化客户端,在程序退出时关闭客户端,让整个项目共享同一套客户端对象。
项目对应文件路径:shopkeeper-agent/app/clients/es_client_manager.py
import asyncio
from typing import Optional

from elasticsearch import AsyncElasticsearch

from app.conf.app_config import ESConfig, app_config

class ESClientManager:
    def __init__(self, es_config: ESConfig):
        # 保存 ES 配置对象,后面初始化客户端时会从这里读取 host 和 port
        self.es_config = es_config
        # 先把 client 声明出来,真正初始化放到 init() 中进行
        self.client: Optional[AsyncElasticsearch] = None

    def _get_url(self):
        # 根据配置文件拼出 ES 服务地址
        return f"http://{self.es_config.host}:{self.es_config.port}"

    def init(self):
        # 创建异步 ES 客户端
        # hosts 之所以是列表,是为了兼容 ES 常见的集群连接方式
        self.client = AsyncElasticsearch(hosts=[self._get_url()])

    async def close(self):
        # 在程序退出时统一关闭客户端连接
        await self.client.close()

# 创建一个全局可复用的 ES 客户端管理器对象
es_client_manager = ESClientManager(app_config.es)

if __name__ == "__main__":
    # 先初始化客户端,后面的测试逻辑才能真正访问 ES
    es_client_manager.init()

    async def test():
        # 取出真正的 AsyncElasticsearch 客户端
        client = es_client_manager.client

        # 创建索引
        # 这里同时显式定义了字段结构
        # dynamic=False 表示关闭动态映射,要求写入数据必须符合当前定义
        await client.indices.create(
            index="my-books",
            mappings={
                "dynamic": False,
                "properties": {
                    # 书名和作者适合做全文检索,所以定义为 text
                    "name": {"type": "text"},
                    "author": {"type": "text"},
                    # 日期字段按日期类型处理
                    "release_date": {"type": "date", "format": "yyyy-MM-dd"},
                    # 页数字段按整数处理
                    "page_count": {"type": "integer"},
                },
            },
        )

        # 插入数据
        # bulk 采用“操作说明 + 数据本体”交替出现的格式
        # 适合一次性写入多条文档
        await client.bulk(
            operations=[
                {"index": {"_index": "my-books"}},
                {
                    "name": "Revelation Space",
                    "author": "Alastair Reynolds",
                    "release_date": "2000-03-15",
                    "page_count": 585,
                },
                {"index": {"_index": "my-books"}},
                {
                    "name": "1984",
                    "author": "George Orwell",
                    "release_date": "1985-06-01",
                    "page_count": 328,
                },
                {"index": {"_index": "my-books"}},
                {
                    "name": "Fahrenheit 451",
                    "author": "Ray Bradbury",
                    "release_date": "1953-10-15",
                    "page_count": 227,
                },
                {"index": {"_index": "my-books"}},
                {
                    "name": "Brave New World",
                    "author": "Aldous Huxley",
                    "release_date": "1932-06-01",
                    "page_count": 268,
                },
                {"index": {"_index": "my-books"}},
                {
                    "name": "The Handmaids Tale",
                    "author": "Margaret Atwood",
                    "release_date": "1985-06-01",
                    "page_count": 311,
                },
            ],
        )

        # 搜索
        # 在 name 字段上执行 match 查询
        # 这里演示的是最基础的全文检索能力
        resp = await client.search(
            index="my-books",
            query={"match": {"name": "brave"}},
        )

        # 打印查询结果,便于观察 hits 和返回结构
        print(resp)

        # 测试结束后关闭客户端连接
        await es_client_manager.close()

    # 运行异步测试函数
    asyncio.run(test())
执行文件验证,成功:
(shopkeeper-agent) didilili@DidililiMacBook-Pro shopkeeper-agent % python3 -m app.clients.es_client_manager
{'took': 5, 'timed_out': False, '_shards': {'total': 1, 'successful': 1, 'skipped': 0, 'failed': 0}, 'hits': {'total': {'value': 1, 'relation': 'eq'}, 'max_score': 1.2067741, 'hits': [{'_index': 'my-books', '_id': 'SDB_np0BrzSqcXAMSMVk', '_score': 1.2067741, '_source': {'name': 'Brave New World', 'author': 'Aldous Huxley', 'release_date': '1932-06-01', 'page_count': 268}}]}}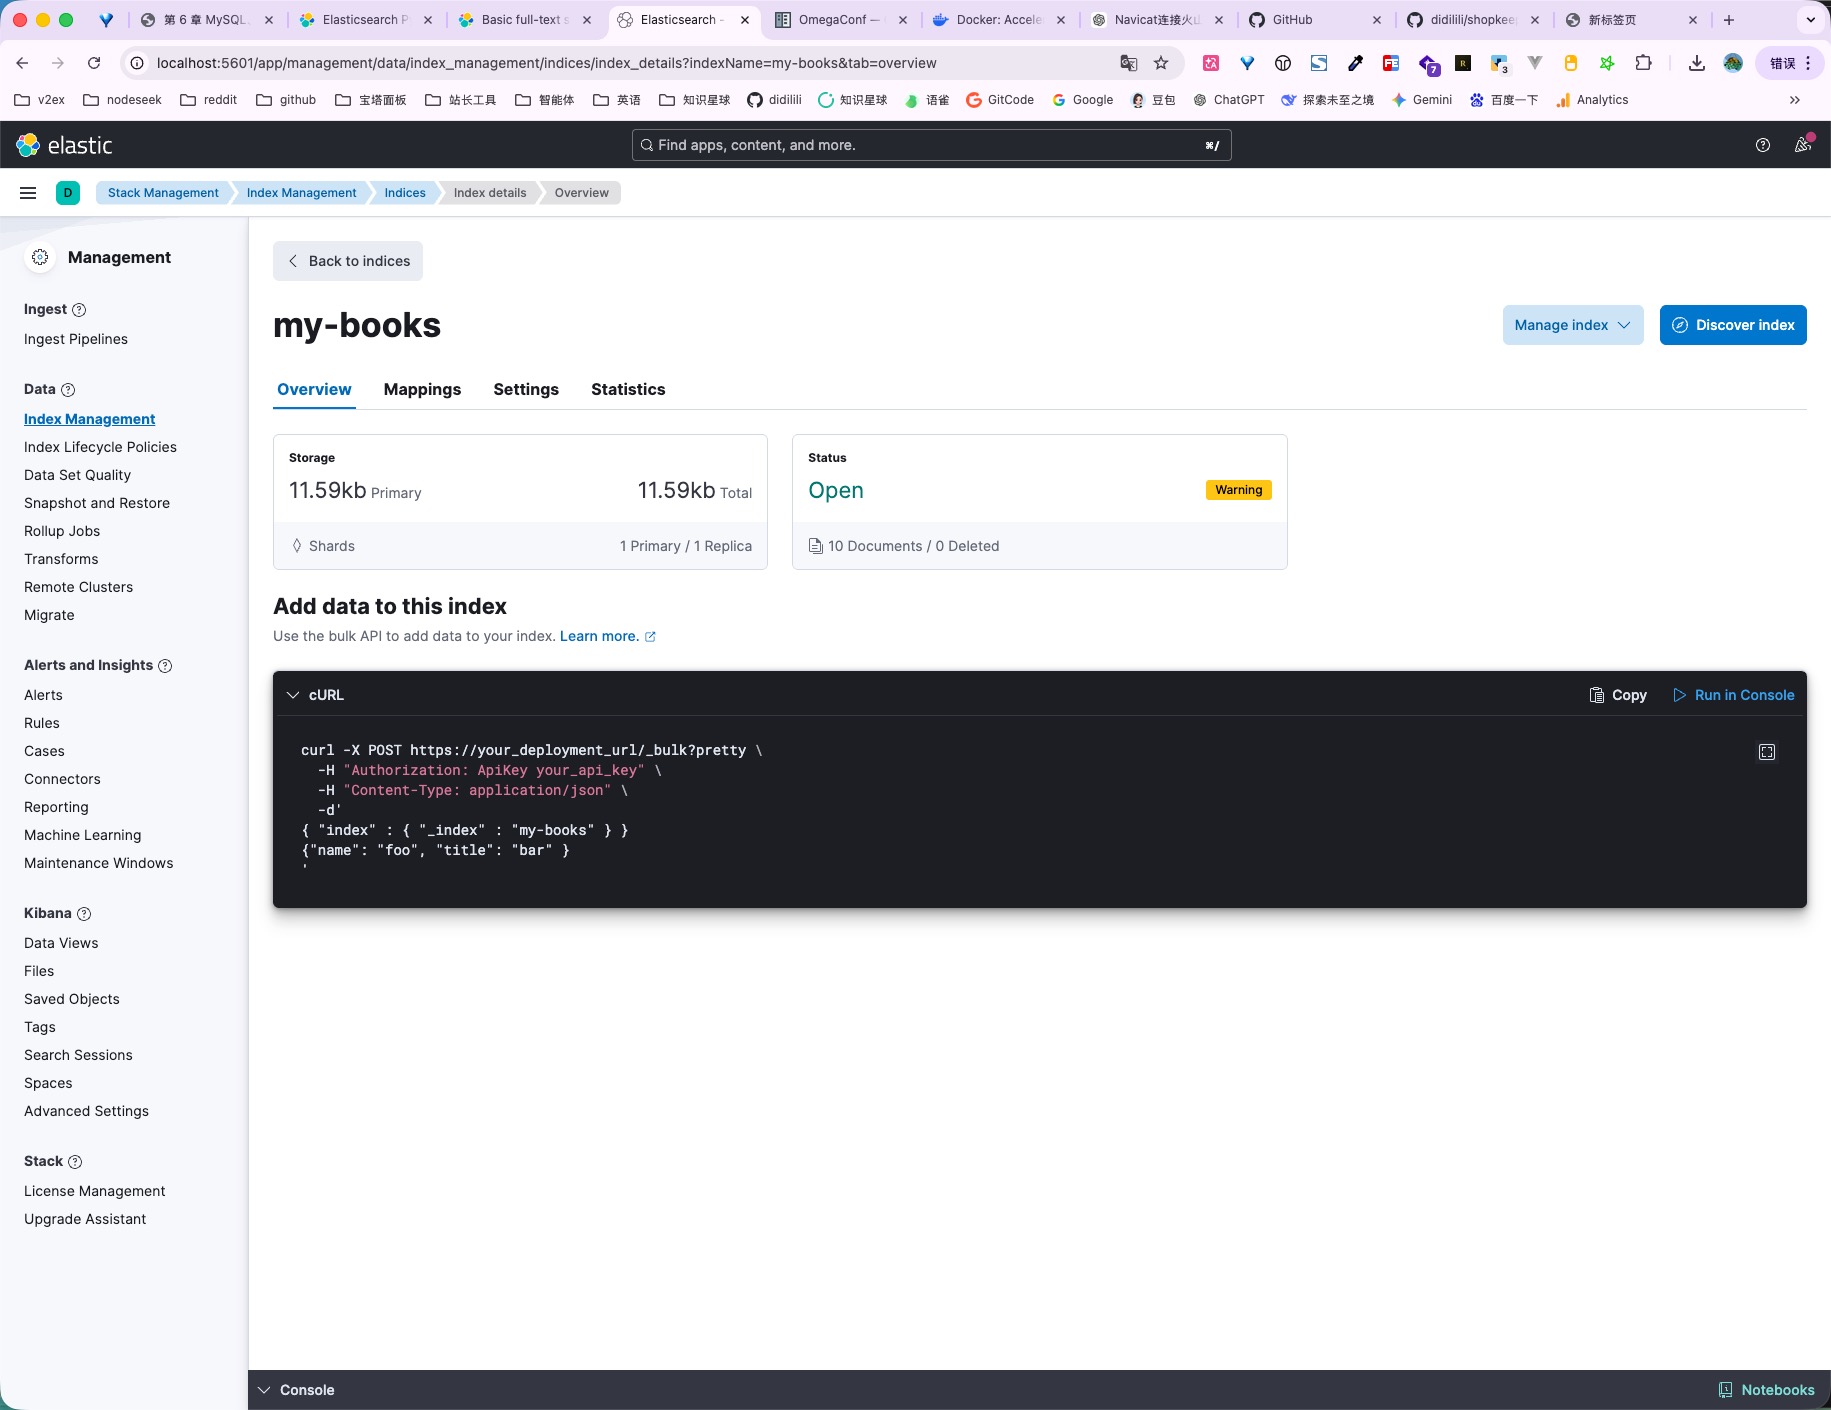
2.8.1 这一层封装在做什么
这个文件实际上也在完成两层工作:
- 封装一个全局可复用的
ES异步客户端 - 用文件底部的测试代码演示
ES的最小使用流程
2.8.2 _get_url()、init()、close() 说明
先看上半部分的管理器代码。它和前面的 QdrantClientManager 思路是一致的,核心也是三件事:
- 保存
ES配置 - 在
init()中创建异步客户端 - 在
close()中关闭客户端
这里可以重点看下面几个位置:
self.es_config:保存配置对象,里面有host、port、index_name等参数_get_url():把配置中的地址拼成完整 URL,例如http://localhost:9200init():创建AsyncElasticsearch客户端close():在程序退出或生命周期结束时关闭连接es_client_manager = ESClientManager(app_config.es):创建全局可复用的客户端管理器对象
这里最重要的结论其实和 Qdrant 一样:整个项目只保留这一份 ES 客户端管理器,后面其他地方都复用它。这样可以避免重复创建连接,也能让基础服务层的管理方式保持一致。
2.8.3 文件底部的测试代码演示了怎样的最小链路
再看下半部分的测试代码,它对应的就是 ES 的最小使用流程:
初始化客户端
  -> 创建 index
  -> 写入 document
  -> search 查询文档
如果按动作拆开看,主要就是下面这几步:
client.indices.create(...):创建一个名为my-books的索引,并显式指定字段结构client.bulk(...):批量写入多条文档client.search(...):使用match查询在name字段里搜索"brave"await es_client_manager.close():在测试结束后关闭客户端,避免留下未关闭连接
2.8.4 关键参数理解
另外,因为这里用的是异步客户端,所以测试代码也要遵循和前面 Qdrant 一样的规则:
- 具体测试逻辑写在
async def test()里 - 调用客户端方法时通过
await - 最外层用
asyncio.run(test())启动整个异步流程
这一段虽然是一个演示示例,但它已经把 ES 的核心使用方式串起来了:先有索引结构,再写入文档,最后根据查询条件检索数据。
你可能会问,为什么官方示例有时会传 api_key,而我们这里的代码只传了 hosts?原因是教学项目当前使用的是本地 Docker 环境,并且关闭了安全认证,所以本地开发时只需要连接地址即可。也就是说,这一版代码更接近:单节点本地开发环境,关闭认证,方便快速调试。
如果放到更完整的生产环境里,ES 往往会:
- 以集群方式部署,而不是单节点
- 开启安全认证
- 额外提供
api_key或其他认证信息
这里还可以继续往下理解:
hosts之所以是复数写法,不是随便起的名字,而是因为Elasticsearch天然支持集群部署- 一个
ES集群可以包含多个节点,每个节点通常运行在不同的服务器或容器上 - 一个
index里的数据,可以按 分片(shard) 分散到多个节点上存储 - 为了提高可用性,还可以给这些分片再准备 副本(replica)
所以从运维视角看,ES 客户端不只是“连某一台服务器”,而是可能在和一组节点组成的集群打交道。
不过这一层在当前项目里先知道结论即可:
- 我们这个教学环境是 单节点
- 所以
hosts虽然是列表,但里面通常只有一个地址 - 分片、副本、故障转移这些能力,是
ES作为分布式搜索引擎本身具备的背景能力 - 当前这章的重点仍然是“把客户端接进项目并完成基础使用”,不是深入讲集群运维
因此,这里用 hosts=[self._get_url()],并不是说 ES 只能这么连,而是因为当前教程环境做了简化。
这里还要再往前走一步,理解它在真实项目里的用途。上面的 my-books 示例主要是帮助我们快速看懂客户端写法;真正放到「电商问数」项目里,ES 更重要的作用是为字段取值建立全文索引。
也就是说,真实项目里写进去的数据不会是书名和作者,而更可能是这种结构:
{
  "id": "value_001",
  "value": "华北地区",
  "column_id": "dim_region.region_name"
}
这样当用户问题里出现“华北地区”这类自然语言表达时,系统就可以通过 ES 找到真实字段取值,再把它反馈给后面的 SQL 生成流程。也就是说,示例里的 my-books 只是一个教学用数据集,项目真正要复用的,是这套 封装客户端 -> 建立索引 -> 写入文档 -> 执行检索 的基本思路。这里和 第 6 章《MySQL、Embedding 接入与日志管理》 中的 Embedding 服务接入是前后衔接的。
本章小结:
- Qdrant 负责向量存储与语义相似度召回,核心概念是
collection / point / vector / payload。 - Elasticsearch 负责全文检索与字段值匹配,核心概念是
index / document / field / mapping。 - 两者在项目里并不是二选一,而是分别从语义层和文本层为后续问数流程提供候选结果。
- 从代码组织上看,项目通过
QdrantClientManager和ESClientManager统一管理异步客户端,这和前一篇讲到的配置体系是完全衔接的。
下一篇会继续补齐另外几块基础服务:MySQL、Embedding 与日志管理。其中 MySQL 负责结构化存储,Embedding 负责向量生成,日志则负责把整套后端运行过程变得可观察、可排查。