5、训练显存
本节先掌握: 模型加载成功,训练仍可能放不下。分清权重与计算中间结果,知道减小 batch 主要减少哪一部分;精度按硬件支持选择。
显存(VRAM) 可以先理解为 GPU(训练时主要承担计算的显卡)用来摆放模型和计算中间结果的工作台。工作台放不下,训练就会报内存不足;工作台越大,通常能放下更大的模型、更长的样本或更大的 batch。
这也把前面的界面设置串了起来:“截断长度”影响一条样本有多长,“批处理大小”决定同时处理多少条,“计算类型”影响数值的表示方式。它们都会影响显存,所以不能只按模型文件大小选择显卡。
5.1 显存的主要占用
沿着第 1 节的顺序,看看训练用的这张“工作台”上要放什么:
- 加载模型时,先放入权重。 模型要使用这些数值计算,权重本身就占一部分空间。此时还没有处理训练样本。
- 处理一批样本时,产生计算草稿。 模型各层算出的中间结果叫作激活值。后面求梯度还会用到其中一些结果,所以算出预测后不能立刻把草稿全部丢掉。
- 根据损失往回求梯度。 程序沿着刚才的计算关系往回求梯度,这个过程叫作反向传播。梯度也需要存放;启用梯度累积时,处理下一小批之前还要保留已经累积的梯度。
- 更新参数时,还要保留更新所需的信息。 AdamW 会参考历史梯度统计,这些信息叫作优化器状态,供后续更新继续使用。
因此,“模型加载成功”和“一批训练能够跑完”是两件事。后面几步还需要空间;训练框架、临时工作空间等也有额外的运行开销。
这也解释了第 2 节的配置调整:同一个模型,batch 从 4 改为 2,并不是把模型权重缩小一半,而是同时处理的样本少了,需要保存的中间结果通常也更少。文章变长,则会增加这部分负担。
所以,权重大小主要看模型和数值表示;激活值还要看实际序列长度和单卡 batch。 第 5.3 节的梯度检查点,就是在“保存草稿”和“需要时重算”之间作取舍。
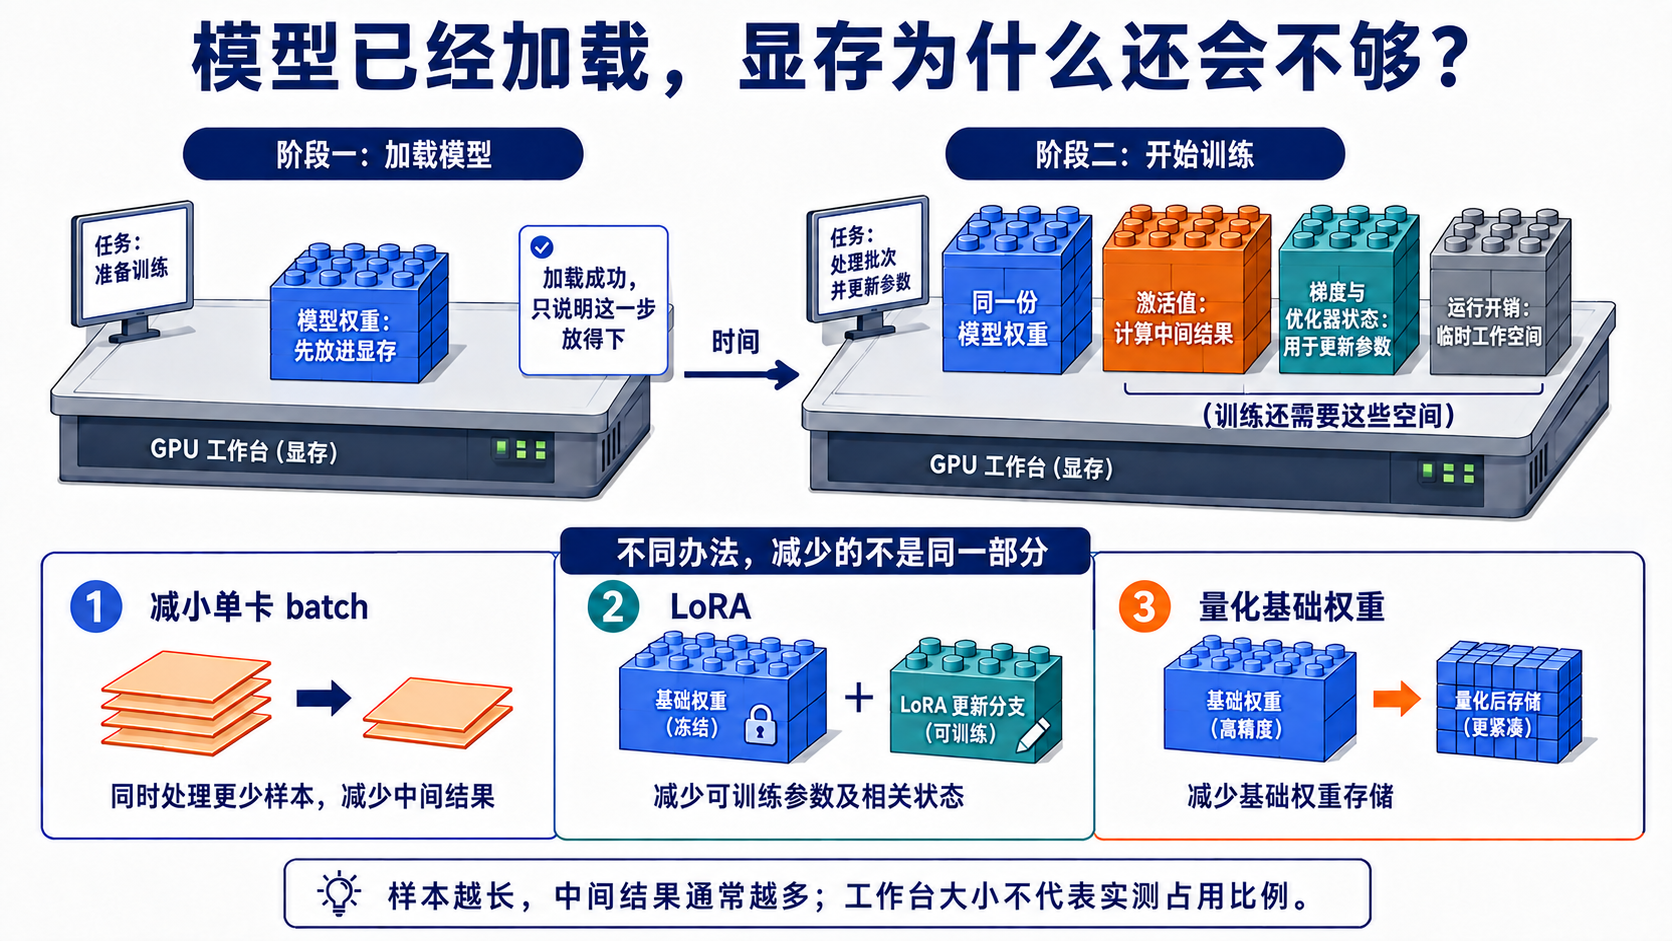
先比较两张工作台:右边的模型没有变大,增加的是训练需要的其他内容。 再看下方三种办法,分别减少哪一部分。图中的物体大小不表示实测占用比例。
遇到“显存不足”,先找到发生的阶段,再对照每种办法减少什么:
| 准备调整什么 | 主要影响工作台上的哪部分 | 如何判断方向是否合适 |
|---|---|---|
| 减小单卡 batch | 同时处理样本产生的中间结果 | 模型已加载,处理批次时空间不足 |
| 降低实际训练长度 | 每条样本产生的中间结果 | 先检查输入和答案是否仍然完整 |
| 使用 LoRA | 大量原权重对应的梯度、优化器状态 | 接受冻结原权重,只训练新增分支 |
| 量化基础权重 | 原模型权重本体 | 加载大模型时,权重已占去过多空间 |
例如,连模型都没加载完就报错,改 batch 无法缩小待加载的权重;已经完成加载,处理长文章时才报错,则应先检查实际长度和 batch。学习率改变参数更新的幅度,并不减少这些数值的数量,不能用它解决显存容量问题。
5.2 数值精度与权重大小
模型参数是数值,计算机保存一个数时,也需要选择表示方式。这里说的数值精度,不是模型回答的准确率,而是这些数能表示得多细。
可以借记录小数理解:把 0.12345 写成 0.12 更粗略,写成 0.1235 更细;另外,一个格式能否表示特别大或特别小的数,又涉及它的数值范围。这是帮助区分“精细程度”和“范围”的例子,FP16 并不是固定保留两位小数。
FP32、FP16、BF16 是几种保存和计算数值的格式。在训练页的“计算类型”中,课程选择 fp16,配置对应 fp16: true、bf16: false。先看它们占用的空间:
| 格式 | 一个数占多少位 | 折合多少字节 |
|---|---|---|
| FP32 | 32 bit | 4 字节 |
| FP16 | 16 bit | 2 字节 |
| BF16 | 16 bit | 2 字节 |
8 bit 等于 1 字节。FP16 和 BF16 虽然占的字节相同,数值范围和精度分配却不同,不是只换一个名字;本次 AutoDL V100 使用 FP16,不使用原生 BF16。具体硬件与安装检查放在第 31 章。
把 0.6B 粗略按 6 亿个参数计算,若每个权重用 2 字节保存:
600,000,000 × 2 = 1,200,000,000 字节 ≈ 1.2 GB同样的 6 亿个数,若全部按 FP32 的 4 字节保存,权重本体就是约 2.4 GB。数值的数量没变,表示它们所用的空间变了。这里均按十进制 GB 粗算,只算权重本体,还没有加入中间结果、梯度和优化器状态等。
所以,从 FP32 改用 FP16 后,不能只据这道题断言整场训练显存减半。实际还有混合精度安排,部分状态仍会使用 FP32;是否稳定、硬件是否支持,也要通过第 31 章的实际运算检查确认。LoRA 的可训练参数比例同样不能直接用来换算整场训练显存。
“计算类型”也不同于模型区域的“量化等级”。本章使用 FP16 计算、不启用量化;第 7 节再解释量化会改变什么。
<details> <summary>选读:选择 FP16 后,日志为什么还会出现 FP32</summary>混合精度是让不同计算或状态使用不同精度,不是所有数值都统一变成 16 位。示例配置开启 FP16,但启动日志还记录了 Upcasting trainable params to float32,表示可训练参数被提升为 FP32。它们并不矛盾:计算设置、参数保存和优化器状态需要分开看。
5.3 梯度检查点与显存
如果第 5.1 节中用于反向传播的“草稿”占了太多显存,能不能少保存一些,需要时再算?
**梯度检查点(gradient checkpointing,也称激活检查点)**会少保存一部分中间结果,需要时再计算一次。可以把它理解为:不把所有草稿都留在桌面上,只保留必要位置,后面用到时重算。代价是增加计算,换取较低的显存占用。
不要与训练存档混淆:
| 名称 | 在这里做什么 |
|---|---|
| 梯度检查点 | 在一次训练计算中减少中间结果的保存,节省显存 |
训练检查点,如 checkpoint-50 | 把某个更新步的权重、状态等保存到磁盘,供后续加载或恢复 |
在其他设置相同的条件下,开启梯度检查点,相当于“少存草稿、多做重算”;关闭后则省去这部分重算,但要保存更多中间结果。如果原来刚好放得下,关闭后可能在处理批次时显存不足;开启后能否以可接受的时间完成,则要同时看资源和耗时。
本次启动日志已有 Gradient checkpointing enabled.,说明它已经开启。跟做时先核对启用状态;若要比较开关的影响,再记录完整运行中的占用与时间,不能拿“每 50 步保存文件”替代这个开关。具体排查方法留在第 33 章。
显存中的另一项大开销,是大量可训练参数对应的梯度和优化器状态。接下来介绍的 LoRA,主要从这一部分减少训练负担。