4、关键词评分与结果分析
4.1 格式检查与内容检查
第 28 章就区分过:回答能否被程序直接处理,与选词是否准确,是两件事。第 29 章的标注规则与审核示例进一步说明,选词既要有原文依据,也要抓住主题。到了评估阶段,还要区分“命中参考答案”和“内容合理”。
先沿用第 29 章的图书馆短文。下面是教学示例,不是模型实测结果:
文章:市图书馆周末开设儿童阅读课,读者可通过公众号预约。
参考答案:市图书馆;儿童阅读课;公众号预约| 假设模型回答 | 格式是否合格 | 是否命中参考答案 | 内容是否合理 |
|---|---|---|---|
市图书馆;儿童阅读课;公众号预约 | 是 | 三个词全部命中 | 符合本例约定的对象、活动和参与方式范围 |
关键词:市图书馆;儿童阅读课;公众号预约 | 否,多出前缀 | 后两个词命中;带前缀的第一项未命中 | 能读出相关信息,但没有按要求交付 |
市图书馆;成人培训 | 是 | 只命中“市图书馆” | “成人培训”没有原文依据 |
市图书馆;儿童阅读课 | 是 | 输出的两个词都命中,但未找全 | 有依据,漏掉本例要求的预约方式 |
市图书馆;儿童阅读课;公众号预约;周末 | 是 | 三个参考词命中,多出“周末” | “周末”有原文依据;本例未把时间列入目标范围,换业务时须按规则判断 |
格式检查看分隔符、前缀和重复等形式;参考答案匹配按既定规则比较词语;内容审核再回到原文,判断依据、名称和主题覆盖。三者不能互相代替:多出一个未命中的词,可能是无依据内容,也可能是原文中的合理信息或标注范围差异。
表中的“命中”沿用现有脚本规则,未提前去掉前缀;后面的精确率、召回率与 F1 也以随附参考答案为准,不等同于人工认定的内容正确率。
第 29 章教过清洗答案,为什么这里不把前缀删掉再评分?
清洗训练答案,是为了提供正确示范;保留预测错误,是为了检查模型有没有学会。 如果评分前替模型删除“关键词:”,就看不出它原本没有完成格式要求了。
因此,模型的解释、换行、前缀和错误都保留在预测文件里。脚本分别计算格式与内容指标;内容计算采用哪些归一化规则,在第 4.5 节说明。
课程输入并非每条都明确写了英文分号要求,所以“没有达到本课程的目标格式”,不总等于“违反了这条输入明写的指令”。比较时保留两组相同的原始任务要求。
<details> <summary>换成问答、分类或摘要任务时,怎样调整评估</summary>第 29 章的 Easy Dataset 扩展生成的是问答数据,不能直接套用本章的分号解析与关键词集合评分。先确定新任务期望交付什么,再选择检查方法:
| 任务 | 自动检查可以先做什么 | 还需要怎样阅读结果 |
|---|---|---|
| 关键词抽取 | 检查格式、计算参考关键词的命中与遗漏 | 对照原文判断名称、主题和依据 |
| 固定类别分类 | 检查类别是否合法,统计准确率与各类别表现 | 查看哪些类别经常互相混淆,避免总体分数掩盖少数类别 |
| 文档问答 | 检查必需字段或可明确核验的答案要点 | 核对事实来源、是否回答问题、是否漏掉前提与限制 |
| 摘要生成 | 检查长度、格式及规定的必要信息 | 检查主要信息是否保留,是否增加原文没有的事实 |
例如,参考写“可通过公众号预约”,回答写“在公众号内完成预约”,逐字匹配不同,但可能表达相同信息;若回答改成“只能现场预约”,即使包含“预约”也可能错误。问答与摘要允许不同措辞时,应先制定内容审核规则,不把字符串相同当作唯一标准。
可以让另一个模型辅助审核,但仍需用人工已核对的样本检查它的判断,专业疑点交给熟悉领域的人确认。让模型评分不会自动消除偏差。相关方法见 Hugging Face 自定义评估课程;本课关键词评分脚本仍按前述规则计算,不包含这类人工或模型审核。
</details>4.2 精确率、召回率与 F1
仍用上面的教学样本。假设模型回答:
市图书馆;儿童阅读课它输出的两个词都在参考答案里,但没有找全。我们分别问两个问题:
| 问题 | 指标名称 | 本例计算 |
|---|---|---|
| 选出来的词,有多少命中参考答案? | Precision,精确率 | 命中 2 个 ÷ 输出 2 个 = 100% |
| 参考答案里的词,有多少被找回来? | Recall,召回率 | 命中 2 个 ÷ 参考 3 个 ≈ 66.7% |
精确率高,不代表找得全;召回率高,也不代表没有多选。比如把三个参考词都输出,再加上两个未命中的词,召回率会是 100%,精确率却只有 3/5。
F1 用一个数综合这两项,避免只看“准”或只看“全”。它不是简单的算术平均,计算方式是:
F1 = 2 × 精确率 × 召回率 ÷(精确率 + 召回率)
   = 2 × 1 × (2/3) ÷ (1 + 2/3)
   = 0.8
图中用同一条样本把“命中”和“漏掉”标出来:
这些指标在本课程脚本中取值为 0~1,显示成百分比时,0.8 就是 80%。没有命中任何参考词时,脚本将该条的 F1 记为 0。
F1=0.8 不等于“80%的文章都答对了”,也不是本课程规定的合格线。 它描述的是按当前规则计算的匹配情况,是否可用还要看任务要求和实际错误。
4.3 从预测文件转换到评分文件
LLaMA-Factory 保存的每条结果包含 prompt、predict、label;配套评分脚本则读取 input 与 prediction。
转换是把同一份预测整理成评分脚本需要的字段。下面用教学样本展示这个关系:
案例与源码-4-微调/convert_keywords_predictions.py 会按完整输入和参考答案核对每条记录,再保存模型回答。你需要把握的是:答卷与题目一一对应,模型写错的内容也原样保留。 字段转换不会替模型修答案。
例如,转换后的一行采用这样的结构:
{ "input": "完整文章与关键词抽取指令", "prediction": "模型实际返回的全部文字" }转换器按完整输入核对每条预测与参考答案的对应关系,处理 prompt 中的模板标记,并原样保留模型回答。
第 29 章介绍的用户输入是消息内容,工具保存的 prompt 则可能包含对话模板标记。因此,转换需要识别模板外壳,并按输入内容配对;仅改字段名或按文件行号配对都可能出错。
本转换器支持已核对的单轮 Qwen3 包装,并允许参考标签末尾多一个换行。评分脚本会合并输入中的连续空白再匹配,但完整文章和任务指令仍须保留。遇到不支持的输出结构时,先检查模板和原始文件,再判断是否需要扩展转换器。
</details>4.4 运行转换与评分脚本
本节接着处理第 3.3 节下载的两组预测:先转换,再评分。没有运行云端预测的读者,可以选择下面的“使用课程附带预测”入口;选好输入后,两条路线执行同一组命令。
在本机项目根目录打开终端,进入案例目录;已经位于该目录则不必再执行 cd:
cd "案例与源码-4-微调"先指定原始预测和评分结果的目录。接着第 3.3 节跟做时,执行:
prediction_dir="results/keywords-my-run-1"
score_dir="results/keywords-my-run-1-score"
prediction_dir 指向下载文件所在的目录,score_dir 指向本次新建的评分目录。它们是当前终端中保存路径的两个变量,后面用 $prediction_dir、$score_dir 取用;若自己的实验目录名称不同,在这里修改一次即可。
课程已经保存了原始模型与 LoRA 的各 200 条预测。要直接复算它们,在同一终端中改用下面两个路径:
prediction_dir="results/keywords-clean"
score_dir="results/keywords-clean-rescore"
这一入口只需要 Python 3。输入仍读取课程附带文件,自己的转换结果和报告另存;继续执行下方命令即可。
评分结果使用尚未存在的新目录。 若 score_dir 指向以前用过的目录,先换一个名字。然后创建本次目录:
mkdir "$score_dir"
mkdir "$score_dir/base" "$score_dir/lora"
若创建时报“目录已存在”,修改 score_dir 后重新创建,再继续。后续命令都在当前终端中执行。
先处理原始模型的预测文件:
python3 convert_keywords_predictions.py \
  --reference processed/keywords-clean/keywords_test.jsonl \
  --predictions "$prediction_dir/base/generated_predictions.jsonl" \
  --output "$score_dir/base/predictions.jsonl"
转换成功后,再评分:
python3 evaluate_keywords_predictions.py \
  --reference processed/keywords-clean/keywords_test.jsonl \
  --predictions "$score_dir/base/predictions.jsonl" \
  --output "$score_dir/base/report.json" \
--require-all| 参数 | 这里填写什么 |
|---|---|
--reference | 同一份测试集,里面有完整输入和参考答案 |
--predictions | 转换时填工具导出的文件;评分时填转换后的文件 |
--output | 本步骤新生成的文件位置 |
--require-all | 评分必须覆盖全部参考输入,不能只计算其中一部分 |
原始模型评分成功后,再用相同参考数据处理 Adapter 组。 两组执行相同的“转换 → 评分”,只改变路径:
| 比较组 | 原始预测所在位置 | 报告保存位置 |
|---|---|---|
| 原始模型 | $prediction_dir/base/ | $score_dir/base/report.json |
| Adapter | $prediction_dir/lora/ | $score_dir/lora/report.json |
展开下面的命令继续执行,不必手工逐项替换。完成后应得到两份报告,再进入第 4.5 节;若输入使用课程附带预测,评分应与第 4.6 节一致。
接着处理 Adapter 组。参考数据不变,把结果路径中的 base 换成 lora:
python3 convert_keywords_predictions.py \
  --reference processed/keywords-clean/keywords_test.jsonl \
  --predictions "$prediction_dir/lora/generated_predictions.jsonl" \
  --output "$score_dir/lora/predictions.jsonl"
确认转换成功后执行:
python3 evaluate_keywords_predictions.py \
  --reference processed/keywords-clean/keywords_test.jsonl \
  --predictions "$score_dir/lora/predictions.jsonl" \
  --output "$score_dir/lora/report.json" \
  --require-all
以跟做者的原始模型预测为例,三类文件分别位于:
results/
├── keywords-my-run-1/base/generated_predictions.jsonl  # 原始回答
└── keywords-my-run-1-score/base/
    ├── predictions.jsonl                              # 转换后的评分输入
    └── report.json                                    # 本次评分报告
LoRA 组位于相应的 lora/ 目录。无论选择哪个入口,评分都读取转换后的 predictions.jsonl,测试集中的 assistant.content 始终保留为参考答案。
如果脚本报错,先看提示,不要继续执行下一步:
| 提示或现象 | 先检查什么 |
|---|---|
| 找不到文件 | 当前终端目录、下载位置,以及 base / lora 是否放反 |
FileExistsError | 转换器拒绝覆盖旧文件;换一个新的 score_dir 并从目录创建重新执行,保留原始回答 |
| 输入或模板无法匹配 | 是否保留了完整文章与任务指令,模板外壳是否与转换器支持的形式相同 |
label 与参考答案不一致 | 是否用了另一份数据,或答案被截断、改动 |
| 缺少预测或出现重复 | 是否只跑了部分数据,或混入了其他实验的结果 |
| 参考答案未通过格式检查 | 回查参考数据和标注规则,而不是先修饰模型回答 |
4.5 阅读评分报告
运行完成后,打开 score_dir 所指目录下的 base/report.json 与 lora/report.json。第 4.6 节展示课程附带预测的评分;选择课程入口复算时,结果应与它一致。自己的模型预测可能不同,先回答三个问题即可:
| 先问什么 | 看哪里 | 本次应怎样判断 |
|---|---|---|
| 题目都评了吗? | 参考数、已评估数、缺失数 | 前两项都是 200,缺失为 0 |
| 格式和选词怎样? | 格式通过率、Macro F1 | 分别看能否按要求交付、是否命中参考词 |
| 哪些错误影响使用? | items 中的原文、参考和预测 | 找到漏词、名称不完整、无依据内容等具体原因 |
其余字段帮助进一步解释分数,需要时查下表。
<details> <summary>查阅:评分报告的完整字段说明</summary>| 阅读顺序 | 字段与中文名称 | 要回答的问题 |
|---|---|---|
| 1 | reference_samples:参考样本数 | 这次应评估多少条?本例应为 200 |
| 2 | evaluated_samples:已评估样本数 | 实际评估了多少条?是否覆盖完整测试集? |
| 3 | missing_predictions:缺失预测数 | 有多少条参考输入没有对应的模型回答? |
| 4 | format_pass_rate:格式通过率 | 有多少比例的回答通过格式检查? |
| 5 | macro_precision:宏平均精确率 | 每篇文章中,模型给出的关键词有多大比例命中参考答案? |
| 6 | macro_recall:宏平均召回率 | 每篇文章中,参考关键词有多大比例被模型找到了? |
| 7 | macro_f1:宏平均 F1 | 各篇文章综合精确率与召回率后的 F1,平均是多少? |
| 8 | exact_match_rate:完全匹配率 | 有多少比例的回答与参考关键词集合完全相同? |
| 9 | items:逐条结果 | 具体哪篇文章漏词或多词,需要怎样改进? |
**Macro(宏平均)**在这里表示“先算每条,再平均”。例如,三条教学样本的 F1 分别是 1.0、0.8、0,Macro F1 就是:
(1.0 + 0.8 + 0) ÷ 3 = 0.6每篇文章贡献一个 F1,不是先把全部文章的关键词混到一起算,也不是“60%的文章完全正确”。macro_precision、macro_recall 同样分别对每条结果取平均;不要拿这两个平均数重新计算 F1,替代脚本的 macro_f1。
本次的“完全匹配”要求预测词集合与参考集合相同;自动评分不会把近义词或简称自动视为同一个词。看见低分后,还要回到原文判断。
<details> <summary>进阶阅读:完全匹配与评分归一化规则</summary>完全匹配检查的是关键词集合:词相同即可,顺序不作比较。比如 图书馆;阅读课 与 阅读课;图书馆 在内容集合上相同,但只要少一个参考词,就不是完全匹配。
格式与内容采用不同的检查方式。 内容评分会统一分号、整理空白并去重,再精确比较词语;格式检查始终针对模型原始回答。因此:
- 中文分号可能不影响词语命中,但仍会导致格式不通过。
- 重复列词不会增加内容命中数,也会被格式检查发现。
独头掘进不会自动匹配独头掘进巷道;简称、近义词不会自动算作相同。- 格式通过也不保证全部内容都是关键词,规则无法识别所有解释句,更不能代替语义判断。
4.6 从分数回到具体错误
在报告的 items 中,每条都有 reference、prediction、missing_keywords 和 extra_keywords。后两项分别列出相对参考答案漏掉与多出的词。
先看两组的整体表现,再沿着“原文 → 参考答案 → 模型回答”分析具体失误。
本次测试的实际结果:
下面两组使用第 3 节的配置,评分来自原始模型报告 案例与源码-4-微调/results/keywords-clean/base/report.json 与 LoRA 报告 案例与源码-4-微调/results/keywords-clean/lora/report.json。
| 指标 | 原始模型 | 加载 LoRA 后 |
|---|---|---|
| 完整评估条数 | 200 / 200 | 200 / 200 |
| 格式通过率 | 0% | 86.5%(173 条) |
| Macro Precision | 0.0000 | 0.3202 |
| Macro Recall | 0.0000 | 0.3353 |
| Macro F1 | 0.0000 | 0.3125 |
| 完全匹配率 | 0% | 0% |
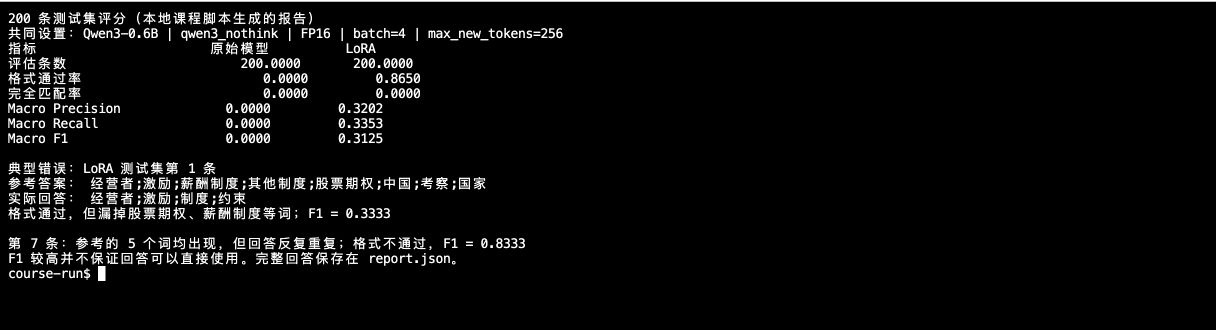
图中是本机课程脚本生成的报告,在终端中并排查看。先留意两个容易误读的地方:
- 原始模型的 0 分反映本次输出未满足评分规则。 在本次模板、原有任务指令和最多生成 256 个 Token 的条件下,它输出了思考、解释等内容,没有形成脚本能够匹配的关键词列表。这一结果不能代表模型的总体能力;加强提示词或调整生成方式后的表现,需要另做对照。
- LoRA 的格式改善,不等于关键词已经抽取准确。 仍有 27 条未通过格式检查,而且没有一条的关键词集合与参考集合完全相同。它适合用于分析下一步改进,不宜据此宣布可以直接上线。
第 2.4 节的小样本对照帮助我们发现提示词、模板和标注问题。要判断“优化提示词后,微调还能带来多少改善”,应在验证集选定方案,再用未参与选择的测试数据做同条件比较;本表不能替代这项验收。
走完一条真实结果:格式通过,为什么 F1 只有 0.3333?
测试集第 1 条的完整输入是:
帮我识别出文本中的关键词:
标题:经营者激励的国情约束
摘要:我们能否仿效西方国家的做法,对经营者给予股票期权等种种薪酬呢?在考虑完善中国的薪酬制度时,还需要对与薪酬制度密切相关的其他制度情况作一考察.
参考答案:经营者;激励;薪酬制度;其他制度;股票期权;中国;考察;国家
LoRA 回答:经营者;激励;制度;约束
回答使用了英文分号,也没有前缀和解释,因此格式通过。再逐词对照参考答案:
| 对照结果 | 词语 | 数量 |
|---|---|---|
| 命中 | 经营者、激励 | 2 |
| 漏掉 | 薪酬制度、其他制度、股票期权、中国、考察、国家 | 6 |
| 多出 | 制度、约束 | 2 |
所以精确率为 2 ÷ 4 = 0.5,召回率为 2 ÷ 8 = 0.25,F1 为 2 × 0.5 × 0.25 ÷ (0.5 + 0.25) ≈ 0.3333。它给出了一份容易拆分的列表,但只命中八个参考词中的两个。
再回到原文判断错误的性质:制度 把文章中的“薪酬制度”“其他制度”写得更宽泛,丢掉了具体所指;约束 则出现在标题中,有文本依据,只是未被参考答案收录。报告中的“多出”表示相对参考集合多出,是否适合作为关键词还需按标注规则判断。
这条记录帮助我们提出下一步检查的问题:训练数据是否经常把具体名称缩短,参考选词规则是否一致?若准备改进,应到训练集和验证集查找同类样本,复核完整名称、选词范围,再用验证集比较候选方案。这条测试记录保留为当前结果,不拿它挑选参数或临时修改参考答案。
<details> <summary>继续练习:简称差异与重复输出为何影响判断</summary>再对照两种不同的错误,体会为什么分数还需要结合原文阅读:
| 测试条目 | 实际现象 | 怎样理解 |
|---|---|---|
| 第 3 条:潜舰对抗模拟 | 回答用了 HLA,参考用的是“高层体系结构”;本条 F1 为 0 | 原文已给出这组中英文对应,精确匹配不会自动换算;同时参考中的 RTI 等在给定文本中未明确出现,需复核标注,不能把所有不匹配都当作模型胡编 |
| 第 7 条:云南新植物 | 参考中的 5 个词都出现了,但后面不断重复,F1 为 0.8333,格式不通过 | 内容评分会去重,因此 F1 仍较高;读者实际拿到的却是重复列表,不能只看 F1 判断是否可用 |
这组结果给出的结论是:本次 LoRA 更容易按关键词形式回答,但漏词、名称不一致和重复输出仍需处理,参考标注也需要继续审核。 格式问题可在验证集检查 Adapter 加载和生成设置,内容问题则结合训练样本与标注规则分析。
如果要把它用进文章管理系统,当前应作出什么决定? 继续改进与验证,暂缓自动写入标签。可以按下面三项整理评估结论:
| 业务要求 | 当前证据 | 下一步 |
|---|---|---|
| 回答能稳定解析 | 173/200 条通过格式检查,仍有重复等问题 | 保留原始回答,异常进入审核或约定的备用流程 |
| 标签有依据且覆盖主题 | 已看到漏词、名称缩短;验证样本还出现无依据编号 | 审核训练与验证样本,比较数据改进方案 |
| 比其他可选方案更值得采用 | 尚无优化后基线及目标业务成本、时延对照 | 在相同业务要求下,补测质量、响应时间、调用与维护成本 |
没有适用于所有任务的统一 F1 上线门槛。用于检索提示的候选标签与直接写入正式记录,可以有不同的验收要求,应先约定哪些错误可以接受、哪些必须拦截。
测试集用于评价已经选定的方案。根据本次结果继续开发后,下一次独立验收需要新的留出数据;用于企业文章前,还需覆盖目标场景,不能只看同源练习数据的分数。
<span id="finetuning-regression"></span>
4.7 回归检查:原来能做的任务还可靠吗
假如下一轮补充了农业文章,品种名提取得更好了,但原来的图书馆文章开始反复输出关键词,这轮改动就有新的问题。回归检查就是把一组需要持续满足的要求固定下来,每次更换数据、模型或提示词后重新检查。
先确定模型负责什么。当前 Adapter 只负责关键词节点,重点检查文章类型、选词规则、格式和停止行为。只有准备让同一个 Adapter 继续承担问答、摘要等任务时,才需要把那些必须保留的任务也加入检查。
先用四条短文理解检查方法。 下面都是自编教学样例,没有附微调前后的实测回答。每条都加上相同的关键词任务说明,按第 29 章的规则审核参考答案,再用于自己的开发回归练习:
| 编号 | 示例文章 | 重点检查 |
|---|---|---|
| K01 | 市图书馆周末开设儿童阅读课,读者可通过公众号预约。 | 能否继续概括活动与参与方式;分号、前缀、重复是否合格 |
| K02 | 青禾市图书馆在北城分馆开设儿童阅读课。 | 是否保留影响含义的机构与分馆名称,而非只留下“图书馆;活动” |
| K03 | 高层体系结构(HLA)用于连接仿真系统。 | 是否按本课规则优先使用原文给出的全称 |
| K04 | 青禾一号由 A17 与 B08 杂交育成。 | 是否保留主要品种名;有无凭空增加相似编号 |
比较时,固定样本、参考规则与共同生成设置,分别保存旧方案和新方案的原始回答。每条记录“格式检查、内容问题、是否比原来变差”,先逐条读,再汇总。这里的四条只够演示方法;实际项目还需加入有代表性的主题、较长输入和关键边界,不能用“四条都过了”保证没有退化。
还可以把第 29 章的覆盖表用于分组看结果:专业名称、全称与缩写、长文本等各有多少条,分别出现什么错误。一个样本可以属于多组,各组数量不能简单相加当作总样本数;小组样本很少时,分数也更容易波动。
这组题一旦用来反复选择方案,就属于开发检查数据。最终验收仍需未参与这些选择的留出数据。对照条件与结果位置可接着记入第 31 章的实验记录卡。
<details> <summary>如果模型还负责选择工具,回归检查增加什么?</summary>对照第 29 章的工具调用示意,分别检查:信息不足时是否澄清、信息齐全时工具是否选对、参数是否符合约定、查询失败时是否如实处理、最终回答是否符合工具结果,以及不需要工具时是否避免多余调用。
最终一句回答正确,不代表中间步骤都正确;也不要求每次都复现唯一一条调用顺序。应以任务要求、工具执行记录和最终结果判断。当前关键词训练没有验证工具选择能力,这些是扩展任务的评估要求。
</details>发现表现下降时,先核对实际输入、模板、Adapter 加载与生成设置,再调查数据和训练。目标任务的泛化变差与其他旧任务的能力下降可能同时出现,不能仅凭一次低分就把原因定为“灾难性遗忘”。第 30 章讲过训练与验证的对照;这里补充的是那些必须持续保持的实际行为。
<span id="finetuning-data-iteration"></span>
4.8 从错误样本到下一轮数据改进
第 4.6 节已经发现名称缩短、漏词和重复。接下来该补数据,还是调参数?先把看到的现象和尚待验证的解释分开。下面是一轮改进练习,目前没有随附重训后的效果;先完成数据审核与实验设计,再实际运行。
以验证中的“万安县”问题为例,能够确认的是:原参考答案把地名截短了。由此可以提出“其他参考答案是否也存在名称截短”的检查方向,但还不能认定所有模型错误都由它造成。按下面的顺序继续:
| 步骤 | 具体做什么 | 留下什么结果 |
|---|---|---|
| 1.检查同类问题 | 到训练集和验证集查找含完整地名、机构名或品种名的样本,对照原文及第 29 章规则审核 | 样本编号、原答案、建议答案、依据与待确认项 |
| 2.确定修订范围 | 只采纳已经确认的修订;已有样本保留训练或验证归属,新增材料按来源分组安排 | 新数据与变更说明,保留旧版;历史测试题不进入训练 |
| 3.重新检查文件 | 沿用第 29 章的格式与去重检查,核对集合交叉,为新版本使用独立输出目录;新验收题从未参与开发的来源另留 | 新三份数据、登记文件、清洗报告和文件指纹;语义仍需审核 |
| 4.比较一次明确的改动 | 先固定基础模型和训练设置,从同一起点重新训练候选方案,用验证集及回归题比较 | 本轮实际配置、日志、检查点与原始回答 |
| 5.验收选定方案 | 在未参与开发的新留出数据上比较,结合格式、内容与失败样本判断 | 同条件的预测与报告,以及改善了什么、仍有什么问题 |
比如,这一轮只想验证“修订名称标注是否有帮助”,就先保持学习率、rank、模板等设置相同。数据变了,应作为新实验;不要用第 31 章的断点恢复冒充原训练的接续。 如果选择接着旧 Adapter 训练,需要另记起点和训练预算,其结果不能与从原模型重新训练混为一谈。
补充样本后,即使 epoch 不变,更新步和训练工作量也可能增加,比较时要一起记录。重新随机划分旧数据,也可能把以前的验证或测试题移入训练;不要把这种变化当作又得到了一份独立验收集。
若同时修改了参考答案,比较组也必须按同一份新参考重新评分。旧版分数保留其原口径;不能把“换了一把尺子”造成的变化全算作模型进步。修复一个名字也不代表整份数据已经完成语义审核。
这一轮仍可出现“格式改善,但完整名称没有改善”的结果。原样记录,再决定下一步,不预设必须提高多少分。完成后,在实验记录卡中注明新数据、配置、原始预测的位置和本轮结论。