6、LoRA 高效微调
本节先掌握: 原权重继续参与计算,训练主要改变新增分支;得到的 Adapter 仍需原模型配合。第 6.2—6.6 节解释设置的用途,首轮沿用 rank 8、alpha 16、dropout 0、target all,先验证训练和实际回答。需要比较某个设置时,再设计一次有明确目的的实验,不要求一开始调优所有选项。
6.1 全参数微调与 LoRA
第 28 章区分了“用什么反馈教模型”与“更新哪些参数”。本节保持 SFT 的文章与参考答案不变,重点看第二个问题。
关键词抽取需要模型理解文章,也需要它遵守统一的输出要求。如果直接更新原模型中几乎全部参数,就是全参数微调。相应的大量梯度和优化器状态也要占用显存。
LoRA换了一种做法:原权重继续负责原来的计算,在选定的层旁边加一条可训练的分支,让它学习需要补上的调整量。两条路径一起参与计算,训练时只改新增分支中的少量参数。
这属于参数高效微调(PEFT):训练时只更新一部分参数,降低相关开销。本章只展开课程会使用的 LoRA 及其量化方式 QLoRA。
LoRA 新增的这一组权重叫作 Adapter(适配器)。它不是独立的完整模型,计算时仍需要原模型。这里的“基础模型”是指它依附的原模型 Qwen/Qwen3-0.6B,不等于必须选第 28 章介绍的 -Base 预训练版本。
| 训练方式 | 原模型权重 | 新增参数 | 主要保存的任务权重 |
|---|---|---|---|
| 全参数微调 | 参与更新 | 通常不需要 LoRA 分支 | 更新后的完整模型权重 |
| LoRA | 冻结,不更新 | 在选定层增加并训练小分支 | Adapter 增量权重 |
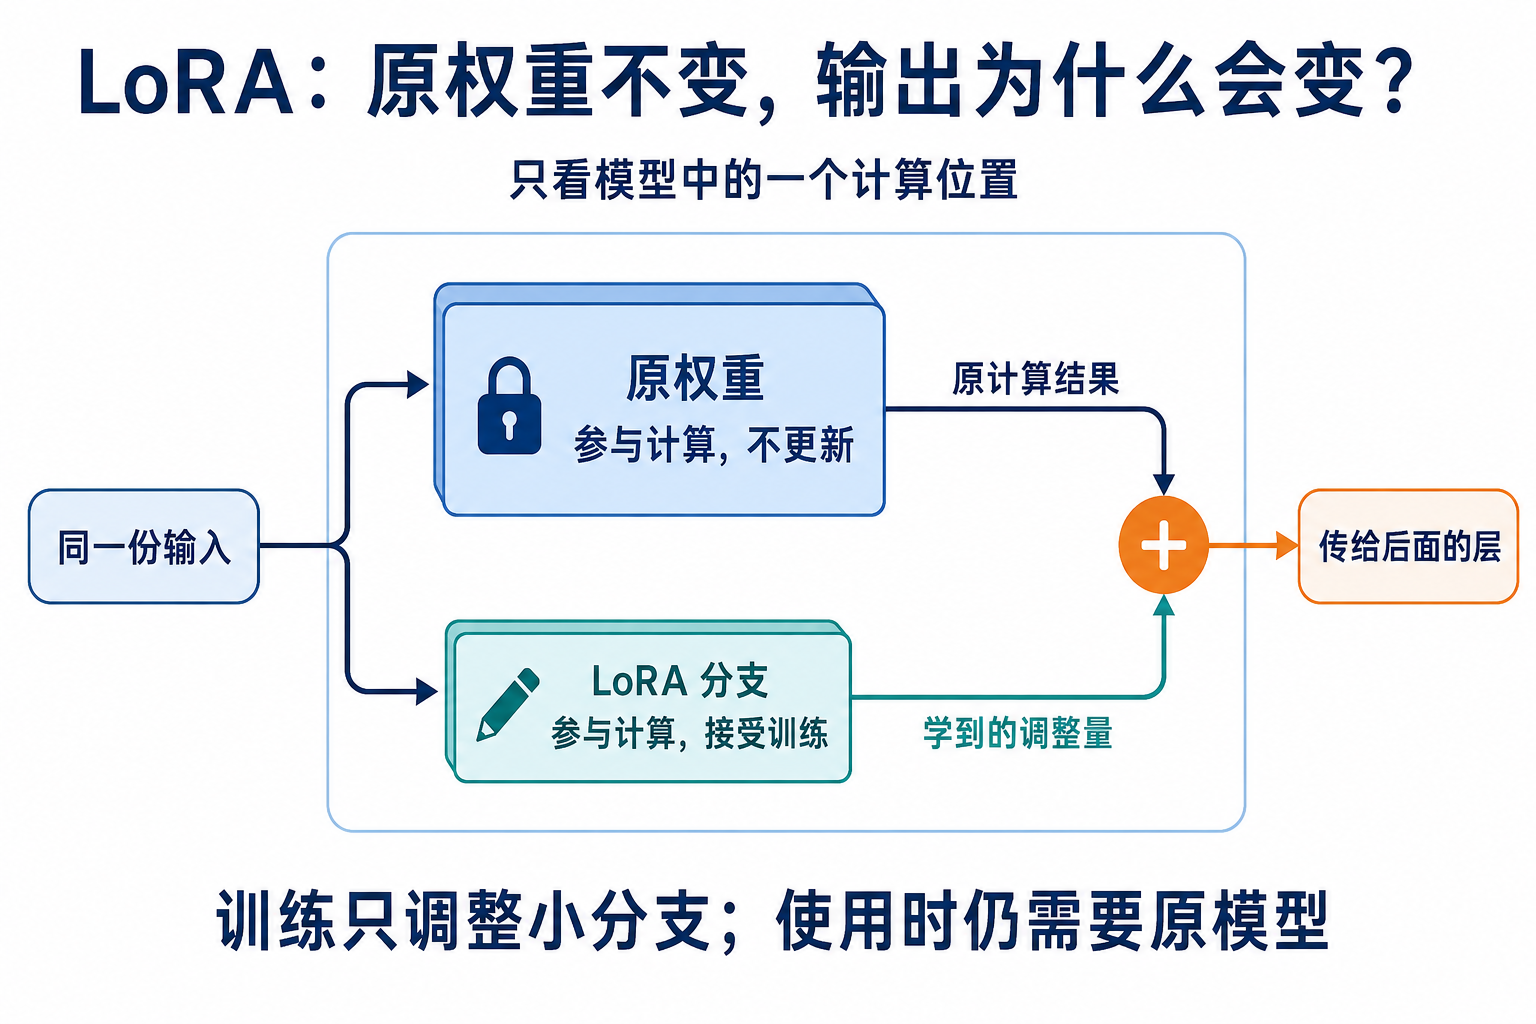
图中只放大模型中的一个计算位置。两条路都参与计算,只有小分支接受训练。 这里相加的是计算结果,还不是最终关键词;图中块的大小也不表示显存占比。
“冻结”不是锁住模型文件,也不是训练时不加载它。原权重仍参与计算,只是不为这些冻结参数计算、保存用于更新它们的梯度和优化器状态。反向传播仍需经过相关计算,才能求出可训练分支的梯度。
回到显存组成,少了大量参数的梯度和优化器状态,这部分开销就能减少;原权重和计算中间结果仍需保留。至于关键词提取是否改善,还要看训练后的验证结果。
冻结原权重,也不保证加载 LoRA 后所有旧任务都保持原样。 新分支会影响计算结果,模型的回答方式仍可能改变。除了检查关键词效果,还应检查自己需要保留的行为,做法见第 32 章的回归检查。
在训练页向下展开“LoRA 参数设置”,先找到上方的秩、缩放系数和随机丢弃三项:
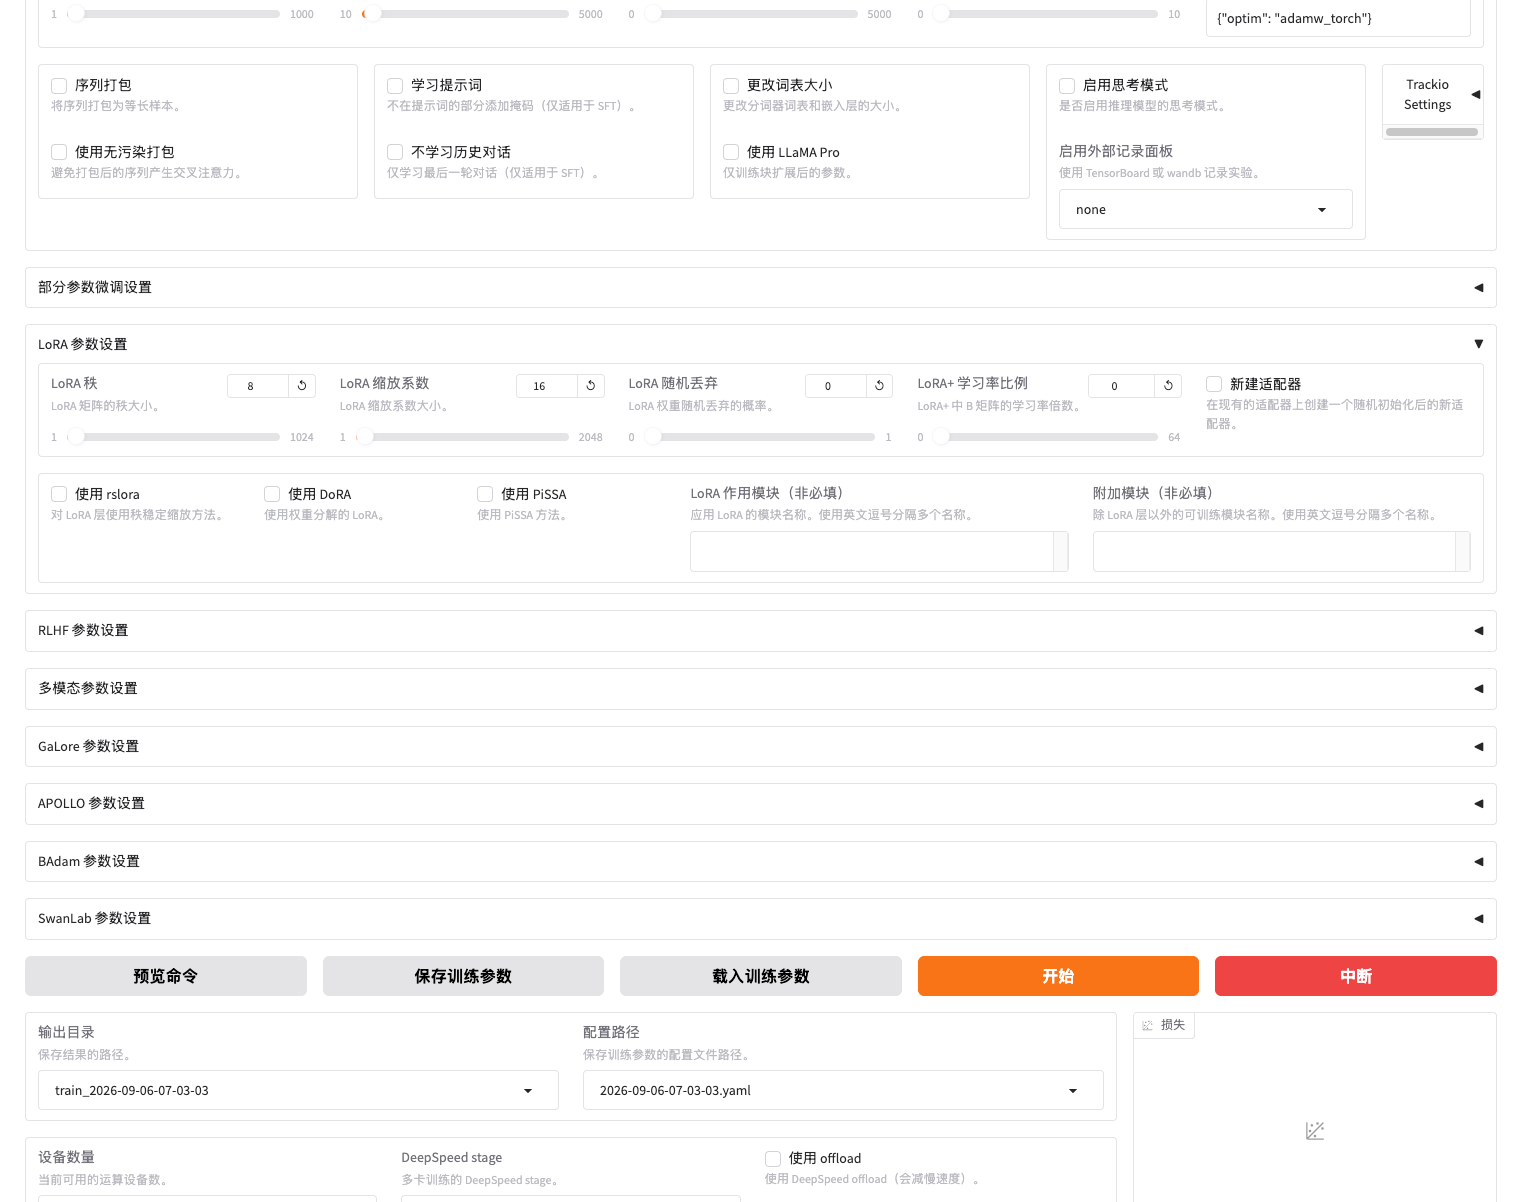
下方的“LoRA 作用模块”在图中留空;课程配置在这里填 all,右侧“LoRA 附加模块”留空。第 6.5 节解释作用位置,第 31 章第 7.4 节展示完整填写结果。
| 界面名称 | 配置写法 | 先理解它控制什么 |
|---|---|---|
| LoRA 秩 | lora_rank: 8 | 新增分支中间有多宽,影响可训练参数量 |
| LoRA 缩放系数 | lora_alpha: 16 | 配合 rank,控制新增分支的增量缩放 |
| LoRA 随机丢弃 | lora_dropout: 0 | 训练时是否随机遮住部分分支输入;本章不开启 |
| LoRA 作用模块 | lora_target: all | 在当前模型中哪些可用的线性层上添加分支 |
先认识这四项的位置和用途,下面各节再分别解释。其他 LoRA 变体保持未启用,矩阵图和完整手算过程可以按需展开。
6.2 A、B 矩阵与计算过程
原权重不更新,输出仍能变化,因为新分支贡献了一个可学习的调整量。LoRA 把这条分支写成两块小的参数矩阵 A、B;矩阵就是按行列排列的数值表。
同一份输入在原路径中照常计算,同时先经过 A、再经过 B 得到调整量。两路结果相加后,继续传给后面的层。
刚加上分支,会不会立刻把原来的输出改乱? 常见默认初始化让 A 从随机数开始,B 全为零。输入经过 A 后,无论得到什么数,再经过全零的 B,分支贡献都是零;训练随后让这个增量逐渐发生变化。因此,初始分支可以先不改变原路径的结果。
不要把它改成“A、B 都全为零”:在这个两矩阵相乘的结构中,两者都为零会使常规梯度更新无法把分支学起来。默认初始化及其他可选方式可查 PEFT LoRA 文档。本课保持工具的默认初始化。
原模型权重不更新,为什么它的输出还能改变?看清这个问题,就能理解 LoRA 为什么需要与原模型一起加载。
模型内部用一组组数值计算。一组按顺序排列的数叫作向量,按行列排列的数值表叫作矩阵。本节关注的线性层会用参数矩阵对输入向量做计算,得到另一组数值。LoRA 就是在选定的这些位置,增加用 A、B 表示的两块小矩阵。
下面只画其中一个线性层,不是整个模型。x 表示送进这一层的一组数,h 表示这一层算出的结果,还不是最终关键词。第一遍先沿箭头看“两条路径 → 相加”,图中的行列数留到第 6.3 节计算参数量时再看。
同一份输入走两条路:原权重照常计算,新增的 A、B 分支计算一个调整量,两路输出相加后传给下一层。训练时只更新 A、B,原权重保持不变。这就是图中“冻结”与“可训练”的区别。
先不算矩阵乘法,只看一个两维教学例子的结果。假设同一输入经过原路径,输出为 [1, 2];经过 A、B,得到的调整量为 [0.1, 0.2]。暂时不加缩放系数,对应位置相加,就得到 [1.1, 2.2],再交给后面的层处理。
这就是“原权重不改,计算结果仍能改变”的原因。这里的数值是为了说明两路相加,不是实际模型权重;这些中间数也还不是关键词。想知道调整量怎样算出来,可以展开下面的手算。
选读:文字怎样变成参与计算的向量
第 29 章把文字变成了 token 编号。例如,“市”的编号是 22697,但这个编号只是用来找到对应的 token,不表示它的含义就是数值二万多。
模型会先按编号取出一组数值,作为这个 token 的初始表示,这一步叫作 Embedding(嵌入)。这组向量会继续经过模型各层计算,与上下文结合,而不是直接拿 token 编号当作词义大小做加减。编号与向量的对应关系可对照 PyTorch Embedding 说明。
选读:A、B 怎样相乘,并用两维数值手算一次输出
沿用图中“先经过 A,再经过 B”的顺序,先暂时不考虑缩放:
权重增量:ΔW = B × A
等效新权重:W = W₀ + ΔW

原路径的输出:W₀ × x
新增路径的输出:B × (A × x)
这个线性层的输出:h = W₀ × x + B × (A × x)
W₀ 是原权重,ΔW 读作“权重的改变量”。权重与权重相加,输出与输出相加,不能把 W₀ × x 的计算结果直接与 B × A 这个矩阵相加。两条路径都要处理同一个 x。
训练期间保留 W₀,更新 A、B;多个样本共同影响这些小矩阵中的数值。这是 LoRA 的基本结构。
用小数字算一遍。 为了手算,把图中的 1000 维缩成 2 维,并假设下面是一组训练后的数值;暂时仍不加缩放系数:
输入 x = [1, 2]ᵀ        (ᵀ 表示把这两个数竖着排列)

原权重 W₀ = [1  0]      A = [0.1  0.2]      B = [0.2]
            [0  1]                              [0.4]
原路径保持输入不变;新增路径先把两个数算成一个数,再变回两个数:
原路径:W₀ × x = [1, 2]ᵀ

先经过 A:0.1 × 1 + 0.2 × 2 = 0.5
再经过 B:[0.2 × 0.5, 0.4 × 0.5]ᵀ = [0.1, 0.2]ᵀ

两路相加:h = [1, 2]ᵀ + [0.1, 0.2]ᵀ = [1.1, 2.2]ᵀ
这两个数还不是最终关键词,而是继续传给后面层的中间输出。此例只用来说明“两条路径处理同一个输入,再把结果相加”;尺寸太小,不用它计算节省比例。下一节再换回大矩阵,计算参数量。
6.3 rank 与可训练参数量
rank(秩,简称 r)控制新增分支中间有多宽。 课程设置 lora_rank: 8,表示输入经过 A 后,先形成 8 个中间数,再由 B 继续计算。
从 8 改成 16,分支会增加可调整的数值,表达调整量的空间更大,相关训练开销也会增加。更多可训练参数不保证关键词提取更好。 首轮先沿用 8,需要比较分支容量时,再看下面的数量计算,并同时核对下一节的 alpha。
把第 6.2 节的分支画宽一点,具体会多出多少参数?假设某个线性层的输入和输出都包含 1000 个数,A 先把 1000 个数变成 r 个,B 再变回 1000 个:
| rank | A 的参数量 | B 的参数量 | 新增可训练参数合计 |
|---|---|---|---|
| 8 | 8 × 1000 = 8,000 | 1000 × 8 = 8,000 | 16,000 |
| 16 | 16 × 1000 = 16,000 | 1000 × 16 = 16,000 | 32,000 |
从 8 改成 16,这个分支有了更多可调整的数值,能表达的修正范围更大;新增权重及其梯度、优化器状态也更多。 原路径的 100 万个权重仍在。上表是同一个教学层的尺寸对照,不能推导出整场训练显存翻倍。
什么时候值得比较 rank?如果输入完整、标注一致、Adapter 已正确加载,而现有训练在训练集和验证集上都持续表现不足,可以将分支容量作为一个待验证因素。如果训练题已经答得很好,验证题却变差,就应先检查第 9 节的过拟合问题。
比较时,从相同基础模型分别新建 Adapter,并在日志中核对可训练参数量,再比较同一份验证数据上的损失、关键词回答与资源开销。调整时还要考虑下一节的 alpha,二者会共同决定增量缩放。
沿用表中的 rank 8,计算节省了多少可训练参数。 A 的尺寸为 8 × 1000,B 为 1000 × 8。矩阵相乘后,B × A 仍是 1000 × 1000,能作为与原权重形状相同的增量。
全参数更新这一个矩阵:1,000,000 个可训练参数
LoRA 更新 A 和 B:8,000 + 8,000 = 16,000 个可训练参数

16,000 ÷ 1,000,000 = 1.6%
1,000,000 ÷ 16,000 = 62.5减少的是这个层的可训练参数,不是把原来的 100 万个权重删除了。此时原权重与 A、B 一共仍有 1,016,000 个参数,只是其中 16,000 个需要更新。不能由此说“整场训练显存缩小 62.5 倍”或“速度提升 62.5 倍”。
这里的“秩”与原矩阵有什么关系?
B × A 的秩不超过 r,不保证恰好等于 r。这个小宽度限制了增量能表达的变化,并不要求原矩阵本身的秩就是 8。
实际模型更新了多少参数? 本次清洗版训练使用 r=8,启动日志记录:
trainable params: 5,046,272
all params: 601,096,192
trainable%: 0.8395
也就是约 505 万个参数参与更新,占日志统计全部参数的约 0.8395%;分母包含基础模型与新增 Adapter。
教学层的 1.6% 与整模型的 0.8395% 不矛盾:真实模型有多层、不同矩阵尺寸和不同的作用位置。完整启动记录见第 31 章的训练日志 案例与源码-4-微调/results/keywords-clean/training/train.log。
6.4 alpha 与增量缩放
alpha 控制新增分支的结果怎样缩放后相加。 在本课程的标准 LoRA 中,缩放倍数是 alpha/r。课程 rank=8、alpha=16,所以分支结果先乘以 2,再与原路径结果相加。
先分清两个环节:学习率控制训练时权重怎样更新,alpha/r 控制计算时分支结果怎样加入。 alpha 不直接改变矩阵尺寸,也不能当作学习率的替代项。
首次保持 rank=8、alpha=16。以后改 rank 时,要连同这个比值一起看:只把 rank 改为 16,alpha 仍为 16,比值就从 2 变成 1。需要做配套对照时,再展开下面的例子。
沿用第 6.2 节的教学数字,暂时固定输入与 A、B:原路径输出 [1, 2],新增分支算出 [0.1, 0.2]。当 alpha/r 为 1,两路相加得到 [1.1, 2.2];保持 rank 不变,将 alpha 加倍,使系数变为 2,分支先乘 2,再相加得到 [1.2, 2.4]。矩阵尺寸没有变,改变的是同一份分支结果加入时的大小。
这也解释了为什么修改 rank 时需要一起看 alpha:
| 设置 | rank | alpha | alpha/r | 发生了什么 |
|---|---|---|---|---|
| 课程起点 | 8 | 16 | 2 | 当前分支宽度与缩放 |
| 只增加 rank | 16 | 16 | 1 | 分支变宽,缩放系数同时减半 |
| 增加 rank,并维持系数 | 16 | 32 | 2 | 分支变宽,缩放系数仍为 2 |
如果实验要比较“分支宽度变化、相加前的缩放倍数保持一致”,第三行就是一种配套安排。它仍不保证两组梯度、训练过程或输出相同。第二行也可以作为实验,只是结论要承认它同时改变了容量和缩放,不能全部归因于 rank。
本节使用标准 LoRA 的 alpha/r 规则,其他变体可能不同。本次 PEFT 0.18.1 的缩放实现
分支参与计算的方式变化,也会影响随后求出的梯度。比较 alpha 时,应先固定 rank 与作用位置,核对配置中的系数,再比较验证表现。
选读:把 alpha/r 放回公式中计算
权重增量:ΔW = (alpha / r) × B × A
线性层输出:h = W₀ × x + (alpha / r) × B × (A × x)
暂时固定 A、B,假设 B × A 中某个位置是 0.01,原权重对应位置是 0.30:系数为 1 时,等效权重是 0.31;系数为 2 时,是 0.32。这是前向计算中如何组合权重的例子,不是说优化器每次更新必然翻倍。
6.5 target modules 与作用位置
界面中的“LoRA 作用模块”对应 target modules(目标模块),指定把 LoRA 分支加到哪些层上。课程使用 lora_target: all,由工具为当前模型识别可应用 LoRA 的线性层。它与旁边的“附加模块”不是一回事;本课程“附加模块”留空。
模型中同一种层名可能重复出现,每个匹配的层各有自己的 A、B;原权重继续保持冻结。
<details> <summary>调整时再看:缩小作用范围会怎样,实际添加到了哪些层</summary>假设保持 rank 为 8,把作用位置从当前的 all 缩小到只选 q_proj、v_proj:模型中匹配这两个名称的层仍添加分支,原先其他位置的分支则不再添加。因此,可训练参数和相关状态会减少,但模型也少了一些可以学习调整的位置。rank 决定每条分支有多宽,target 决定哪些地方有分支。
这类比较适合回答“缩小作用范围,能否在减少开销时保留任务效果”。先从启动日志核对可训练参数量,并查看 adapter_config.json 的 target_modules,确认实际作用位置;再比较同一份验证数据上的回答。
这次 Qwen3 的哪些层加入了 LoRA:
清洗版 Adapter 配置记录了以下名称:
| 层名 | 所属计算部分 | 这里需要理解什么 |
|---|---|---|
q_proj、k_proj、v_proj、o_proj | 注意力部分的线性映射 | 这些位置会添加并训练 LoRA 分支 |
gate_proj、up_proj、down_proj | 前馈网络,即每层中继续变换数值的部分 | 这些位置同样参与本次 LoRA 训练 |
这些名称在不同网络层中重复出现,各自可以有对应的 A、B。更换模型时,应重新检查它的层名与实际作用位置。
</details>6.6 LoRA dropout
界面中的“LoRA 随机丢弃”对应 LoRA dropout,是在训练时对 LoRA 分支的部分输入值进行随机丢弃:本次暂时遮住部分输入,下次重新随机选择。
第 6.1 节截图中的辅助文字写成了“LoRA 权重随机丢弃的概率”,容易让人误以为会删除权重。这里按本次 PEFT 的实际计算理解为对分支输入应用 dropout,A、B 权重仍然保留。
课程设置为 lora_dropout: 0,即不启用。假设改为 0.1,训练时分支输入中的每个数值会以 10% 的概率被暂时置零,A、B 的尺寸和参数量保持不变。
这样做是希望分支少依赖某些输入值的固定组合,有时有助于缓解过拟合,也可能让有限训练中的学习更困难。如果核对数据和预处理后,仍出现训练表现持续改善、验证表现持续变差,可以把 dropout 作为候选调整之一。它不负责修正错误标注,也不是省显存开关。
若进行对照,两组从相同基础模型开始,保持其他训练条件一致;重点看验证损失和实际回答是否改善,即使训练损失稍高,也要结合验证结果判断。
</details>正常推理时 dropout 会关闭。首次训练保持课程的 0,遇到过拟合问题再考虑是否需要比较其他值。
现在再读本节开头的四项配置:target 决定分支加在哪里,rank 决定分支有多宽,alpha/r 决定结果怎样缩放后相加,dropout 决定训练时是否随机遮住部分分支输入。