4、序列长度与截断
本节先掌握: 长度上限包含输入和参考答案。缩短之前检查会丢掉什么,提高上限也不一定增加实际训练内容。
训练页面中的“截断长度”对应 cutoff_len,用来限制一条训练序列最多有多少 token。第 29 章已经看过对话模板和分词结果,这个长度需要把输入和参考答案一起算进去:
用户文本 + 任务指令 + 模板标记 + 助手参考答案
                    ↓
             完整训练序列的 token
沿用图书馆样本,实际计入长度的内容包括:
[用户角色标记] 市图书馆周末开设儿童阅读课……请提取关键词……
[助手角色标记] 市图书馆;儿童阅读课;公众号预约 [结束标记]
└──────────────── 整段分词后的 token 总数 ────────────────┘这是内容组成示意,角色标记的实际写法由模板决定。cutoff_len: 2048 表示这段完整序列的上限为 2,048 token,不是文章篇数、汉字数,也不是 Chat 页单独设置的“最大生成长度”。
4.1 长度上限的影响
长度首先影响模型能看到什么,其次才是显存和速度。假设图书馆原本提供了一篇很长的活动介绍,“读者可通过公众号预约”放在文章后半段。如果截断后这句话没了,参考答案里的“公众号预约”却仍然保留,会发生什么?
模型看到的文章不再有预约方式,训练程序却仍要求它预测出这个关键词。这样一来,一条本来有依据的答案,在截断后就可能失去依据。第 29 章检查的是原始样本是否合理,这里还要检查模型实际收到的样本是否完整。
用长度表示,假设一条训练样本处理前共有 2,300 token,而上限只有 2,048,就不能完整保留它。不同部分被截去,会产生不同影响:
| 被截去的内容 | 对关键词任务的影响 |
|---|---|
| 用户文章的一部分 | 答案可能提到了模型已经看不到的内容 |
| 参考答案的一部分 | 模型无法学习完整的关键词和结束方式 |
| 必要的任务说明或上下文 | 输入与答案可能不再构成清楚、完整的任务 |
工具会按自身预处理规则分配输入与答案的长度,不能一概认为只删除文章末尾。
<details> <summary>进阶选读:填充与截断有什么区别,短样本也会补到上限吗</summary>长度还涉及填充(padding):两条长短不同的样本放在同一批处理时,工具通常需要把它们整理成一样长。例如,一条有 120 个 token,另一条有 200 个 token;如果按本批最长样本补齐,短的那条就要增加 80 个填充位置。
工具会标记这些用于对齐的填充位置,让它们不作为预测目标计入损失;这里也会用到第 1.1.1 节的标签忽略规则。

读图时可以用两个问题区分:上半部分是“这一批长短不一,怎样排齐”,下半部分是“这一条太长,哪些内容还能保留”。图中没有规定工具具体截掉哪一段,实际结果需要按下一节的方法检查。
因此,cutoff_len: 2048 是长度上限,不等于每条短样本都补到 2,048。填充到哪里还取决于批次和工具设置。把上限提高到 8,192,也不能直接认定所有样本都会占用 8,192 个位置。
还要记住:2048 是上限,不表示每条短样本都会占满 2048 个位置。 实际占用还与批次及填充设置有关。
4.2 检查实际训练长度
先检查课程数据经过 LLaMA-Factory 处理后的长度。下面的结果对应 Qwen/Qwen3-0.6B、qwen3_nothink 模板、cutoff_len: 2048 和 train_on_prompt: false。这项检查只运行数据预处理,不需要加载模型权重或训练。
先看样本有没有被丢弃或截断:
| 数据文件 | 原始条数 → 处理后条数 | 最长完整序列 | 被截断的条数 |
|---|---|---|---|
keywords_train.jsonl | 1,600 → 1,600 | 957 token | 0 |
keywords_validation.jsonl | 200 → 200 | 604 token | 0 |
这里的长度包含角色标记、用户输入、助手答案和结束标记,不是文章字数。两份数据都低于 2,048 的上限,预处理前后条数一致,也没有因截断改变答案目标的样本。
现在可以根据实际长度判断怎样改上限。保持当前数据和模板不变,先作下面的配置推演:
| 截断长度设置 | 对当前数据能作出的判断 | 要检查什么 |
|---|---|---|
| 保持 2048 | 已有预处理证据表明全部样本完整保留 | 对照上述条数与长度 |
| 提高到 4096 | 当前最长只有 957,不会因此多读到文章内容 | 实际序列和填充是否变化,再观察资源 |
| 降到 512 | 至少已有最长样本无法完整保留 | 重新检查被截去的输入、答案及样本条数 |
长度设置首先要保证输入和答案完整。 上面的 4096 与 512 是按已有样本长度作出的推演;实际显存还受批次长度和填充方式影响。排查自己的数据时,可以展开下面的标签核验。
<details> <summary>选读:实际样本的输入、答案标签与长度核验</summary>再看 input_ids 和 labels 是否对应。 从这 1,800 条数据中,按完整序列长度选出最短、中间和最长的三条:
| 样本位置(文件行号从 1 开始) | 完整长度 | labels = -100 的位置数 | 参与损失计算的位置数 |
|---|---|---|---|
| 短:验证集第 133 行 | 39 | 28 | 11 |
| 中:训练集第 636 行 | 158 | 136 | 22 |
| 长:训练集第 631 行 | 957 | 938 | 19 |
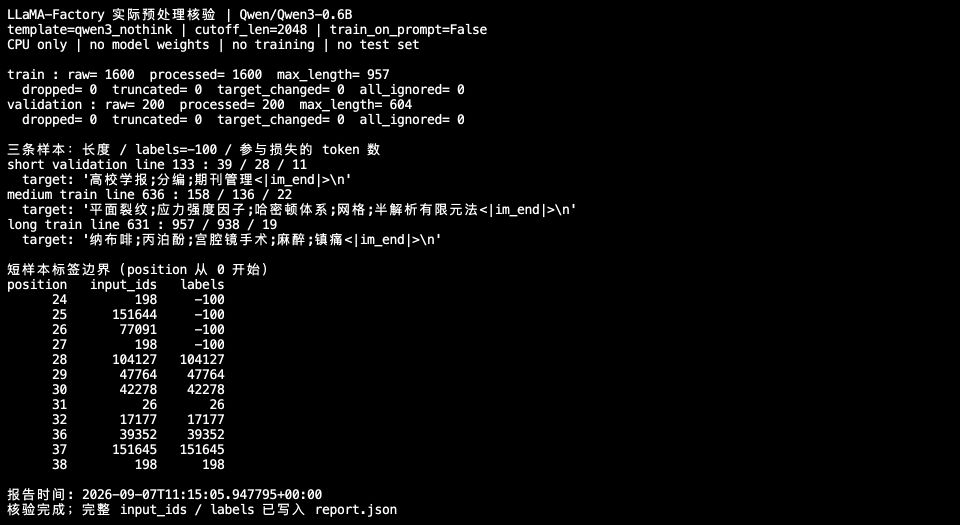
图中短样本的答案是 高校学报;分编;期刊管理。它的前 28 个位置是用户输入及角色标记,labels 为 -100;从位置 28 开始(索引从 0 计数),标签保留答案的 token ID。末尾的 <|im_end|> 和换行也计入目标,所以参与损失计算的位置数不等于关键词字数。-100 只表示该位置不作为预测目标,不表示模型看不到这段输入。
核对标签时,既要检查解码后的输入、答案和角色边界,也要确认每条样本都有参与损失计算的答案位置。表中三条样本与源记录对应,全部 1,800 条数据也没有答案标签全为 -100 的情况。可在配套 examples/preprocessing/report.json 中查找 decoded_input、decoded_target 和标签数组;下面给出检查脚本的运行方法。
先完成第 31 章的环境安装、模型下载和数据上传,不需要先启动训练。脚本只用 CPU 检查数据,不会替你下载模型。
在 AutoDL 的 JupyterLab 终端准备目录:
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
mkdir -p configs
在 JupyterLab 文件面板上传两份本机文件:
本机 案例与源码-4-微调/ 中的文件 | 上传到 AutoDL 的位置 |
|---|---|
audit_keywords_preprocessing.py | LLaMA-Factory/ 根目录 |
configs/keywords_clean_train.yaml | LLaMA-Factory/configs/ |
这里使用课程附带的 CLI 训练 YAML,不是 WebUI 的“保存训练参数”文件。若已上传同名文件,先核对内容;本脚本要求其中的 model_name_or_path 仍为 Qwen/Qwen3-0.6B,实际读取的本地模型位置由下面的 --model-dir 单独指定。
回到刚才的 AutoDL 终端,先检查文件,再运行脚本:
ls audit_keywords_preprocessing.py configs/keywords_clean_train.yaml
ls data/keywords-clean/keywords_train.jsonl data/keywords-clean/keywords_validation.jsonl

python audit_keywords_preprocessing.py \
  --data-dir data/keywords-clean \
  --config configs/keywords_clean_train.yaml \
  --model-dir /root/.cache/modelscope/models/Qwen--Qwen3-0.6B/snapshots/master \
  --output-dir /root/autodl-tmp/keywords-preprocessing-check
将 --model-dir 换成模型下载完成时返回的实际目录;--output-dir 必须是尚不存在的新目录,不要指向已有训练结果。--data-dir 是待检查的数据位置,--config 提供模板、长度等检查条件,并不会因为其中写了 do_train: true 就启动训练。
完成后,在文件面板打开输出目录中的 report.json,对照上面的条数、截断和标签统计。脚本报配置条件不符时,先核对所上传的 YAML;不要删掉检查条件强行运行。
换成自己的数据或调整模板后,需要重新运行上面的预处理检查,对照原文查看模型实际收到的文章与答案,确认两者仍然完整、对应。具体的解码、标签核验和脚本操作保留在展开框中。当前数据适合 2,048 的上限,不代表换一批文档后仍然合适。